载入数据
import pandas as pd

names=['preg','plas','pres','skin','test','mass','pedi','age','class']
df = pd.read_csv("./pima-indians-diabetes.csv",names=names)

df.head()
【0】Pregnancies:怀孕次数
【1】Glucose:葡萄糖
【2】BloodPres分类目录归档:机器学习
import pandas as pd
names=['preg','plas','pres','skin','test','mass','pedi','age','class']
df = pd.read_csv("./pima-indians-diabetes.csv",names=names)
df.head()
【0】Pregnancies:怀孕次数
【1】Glucose:葡萄糖
【2】BloodPresfrom sklearn.feature_selection import SelectKBest
from sklearn.datasets import load_iris
iris = load_iris()
X,y = iris.data,iris.target
X[:5,:]
X_new = SelectKBest(k=2).fit_transform(X,y)

X_new[:5,:]  # 计算相关系数后 发现这两列和y值相关度最高
结果:
X_new[:5,:]  # 计算相关系数后 发现这两列和y值相关度最高
1
# 工具库
import pandas as pd


# 泰坦尼克数据集
df_train = pd.read_csv('titanic.csv')

# 了解一下数据集
df_train.head()
df_train.shape # 查看维度df_train.info() # 数据集信息import pandas as pd
from sklearn import preprocessing
from sklearn import tree
from sklearn.datasets import load_boston # 波士顿房价
boston_house = load_boston()boston_feature_name = boston_house.feature_names
boston_features = boston_house.data
boston_target = boston_house.targetboston_featuimport pandas as pd
from sklearn import preprocessing
from sklearn import tree
from sklearn.datasets import load_iris # 花瓣种类
# 加载数据
iris = load_iris()
dir(iris) # iris包含的内容有哪些 如果不懂某些方法 可用 help(iris)
['DESCR', 'data', 'feature_names', 'filename', 'target', 'target_names']
iris_feature_names = ir# 用于数据处理和分析的工具包
import pandas as pd
# 数据处理/特征工程的包
from sklearn import preprocessing
# 决策树建模包
from sklearn import tree
adult_data = pd.read_csv('./DecisionTree.csv')
# 读取前5行
adult_data.head(5)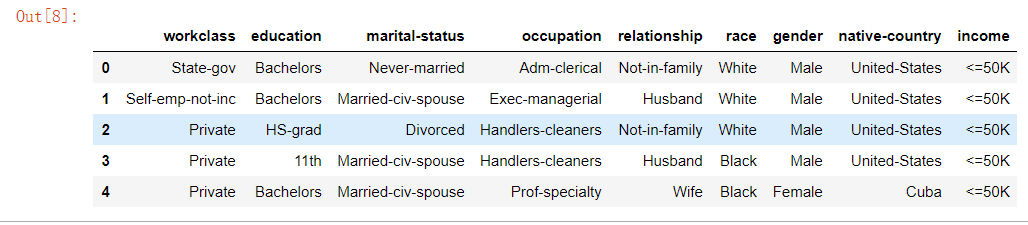
adult_data.info() # 读入数据的信息<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 e#conding=utf-8
import pandas as pd
import numpy as np
import matplotlib as mpl
import matplotlib.pyplot as plt
from scipy.optimize import minimize
from sklearn.preprocessing import PolynomialFeatures
# pandas 基础设置
pd.set_option('display.notebook_repr_html',False)
pd.set_option('disp#conding=utf-8
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from mpl_toolkits.mplot3d import axes3d
# pandas 基础设置
pd.set_option('display.notebook_repr_html',False)
pd.set_option('display.max_columns',Nonimport numpy as np
from keras.datasets import mnist
from keras.utils import np_utils
from keras.models import Sequential
from keras.layers import Dense,Dropout,Convolution2D,MaxPooling2D,Flatten # Flatten扁平化
from keras.optimizers import Adam# 载入数据
(x_train,y_train),(x_test,y_test) = mnist.load_datimport numpy as np
from keras.datasets import mnist
from keras.models import Sequential
from keras.layers import Dense, Activation, Flatten, Reshape
from keras.layers import Conv2D, Conv2DTranspose, UpSampling2D
from keras.layers import LeakyReLU, Dropout
from keras.layers import BatchNormalization