把需要的工具库引入
# 用于数据处理和分析的工具包
import pandas as pd
# 数据处理/特征工程的包
from sklearn import preprocessing
# 决策树建模包
from sklearn import tree
读取数据
adult_data = pd.read_csv('./DecisionTree.csv')
# 读取前5行
adult_data.head(5)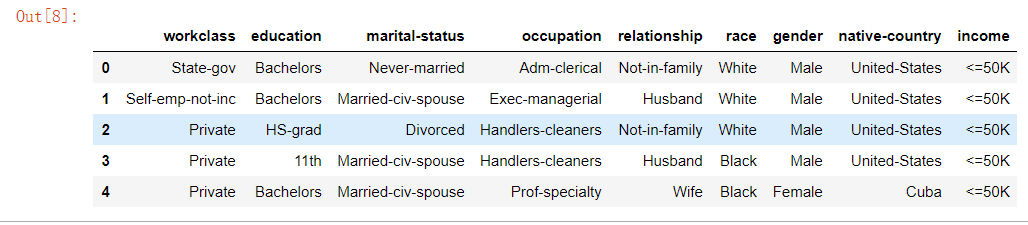
adult_data.info() # 读入数据的信息<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 entries, 0 to 999
Data columns (total 9 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 workclass 1000 non-null object
1 education 1000 non-null object
2 marital-status 1000 non-null object
3 occupation 1000 non-null object
4 relationship 1000 non-null object
5 race 1000 non-null object
6 gender 1000 non-null object
7 native-country 1000 non-null object
8 income 1000 non-null object
dtypes: object(9)
memory usage: 70.4+ KBadult_data.shape # 维度(1000, 9)
adult_data.columns # 所有列结果:
Index(['workclass', 'education', 'marital-status', 'occupation',
       'relationship', 'race', 'gender', 'native-country', 'income'],
      dtype='object')
区分一下特征(属性)和目标
feature_columns = ['workclass', 'education', 'marital-status', 'occupation',
       'relationship', 'race', 'gender', 'native-country']
label_column = ['income']
#区分特征和目标列
features = adult_data[feature_columns]
label = adult_data[label_column]features.head(2) # 查看特征头2行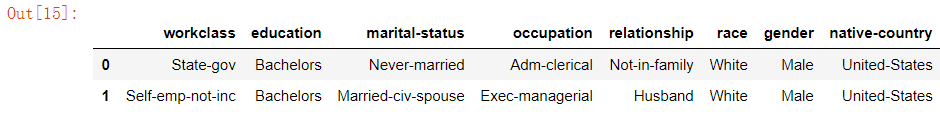
处理特征
计算机很难识别数据信息,需要处理
features = pd.get_dummies(features) # 处理特征 文本型表示成数值型features.head(2)构建模型 ☆
#初始化一个决策树分类器
clf = tree.DecisionTreeClassifier(criterion='entropy', max_depth=4)  # 最大4层
#用决策树分类器拟合数据
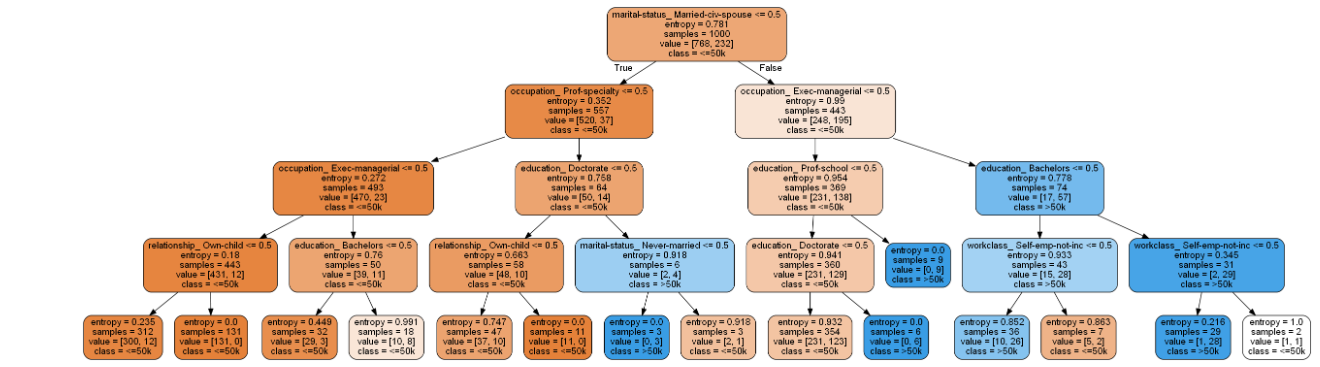
clf = clf.fit(features.values, label.values)clfclf.predict(features.values) # 将模型用于预测可视化一下这颗决策树
import pydotplus
from IPython.display import display,Image
dot_data = tree.export_graphviz(clf,
out_file=None,
feature_names=features.columns,
class_names = ['<=50k', '>50k'],
filled = True,
rounded =True
)import os
os.environ["PATH"] += os.pathsep + 'C:/Program Files (x86)/Graphviz2.38/bin/' #注意修改你的路径
graph = pydotplus.graph_from_dot_data(dot_data)
display(Image(graph.create_png()))