from keras.applications.vgg16 import VGG16
from keras.models import Sequential
from keras.layers import Conv2D,MaxPool2D,Activation,Dropout,Flatten,Dense
from keras.optimizers import SGD
from keras.preprocessing.image import ImageDataGenerator,img_to_array,load_img
import numpy as np
#VGG16是用imagenet训练出来的
vgg16_model = VGG16(weights='imagenet',include_top=False, input_shape=(150,150,3))
# 运行后会下载vgg16模型 路径为 C:\Users\daxia\.keras\models
# 搭建全连接层
top_model = Sequential()
top_model.add(Flatten(input_shape=vgg16_model.output_shape[1:]))  # 去掉关于批次的维度
top_model.add(Dense(256,activation='relu'))
top_model.add(Dropout(0.5))
top_model.add(Dense(2,activation='softmax'))

# 定义新的模型 拼接模型
model = Sequential()
model.add(vgg16_model)
model.add(top_model)
train_datagen = ImageDataGenerator(
    rotation_range = 40,     # 随机旋转度数
    width_shift_range = 0.2, # 随机水平平移
    height_shift_range = 0.2,# 随机竖直平移
    rescale = 1/255,         # 数据归一化
    shear_range = 20,       # 随机错切变换
    zoom_range = 0.2,        # 随机放大
    horizontal_flip = True,  # 水平翻转
    fill_mode = 'nearest',   # 填充方式
)
test_datagen = ImageDataGenerator(
    rescale = 1/255,         # 数据归一化
)
batch_size = 32

# 生成训练数据
train_generator = train_datagen.flow_from_directory(
    'image/train',
    target_size=(150,150),
    batch_size=batch_size,
    )

# 测试数据
test_generator = test_datagen.flow_from_directory(
    'image/test',
    target_size=(150,150),
    batch_size=batch_size,
    )
train_generator.class_indices
# 定义优化器,代价函数,训练过程中计算准确率
model.compile(optimizer=SGD(lr=1e-4,momentum=0.9),loss='categorical_crossentropy',metrics=['accuracy'])

model.fit_generator(train_generator,
                    steps_per_epoch=len(train_generator),
                    epochs=20,
                    validation_data=test_generator,
                    validation_steps=len(test_generator))
不恰当的初始权值可能使得网络的损失函数在训练过程中陷入局部最小值,达不到全局最优的状态。因此,如何消除这种不确定性,是训练深度网络是必须解决的一个问题。 momentum 动量能够在一定程度上解决这个问题。momentum 动量是依据物理学的势能与动能之间能量转换原理提出来的。当 momentum 动量越大时,其转换为势能的能量也就越大,就越有可能摆脱局部凹域的束缚,进入全局凹域。
# pip install h5py
model.save('mask_model_vgg16.h5')
# 测试
from keras.models import load_model
import numpy as np

label = np.array(['image_mask','image_nomask'])
# 载入模型
model = load_model('mask_model_vgg16.h5')
def process_img(image):
    image = image.resize((150,150))
    image = img_to_array(image)
    image = image/255
    image = np.expand_dims(image,0)
    return image
# 导入图片
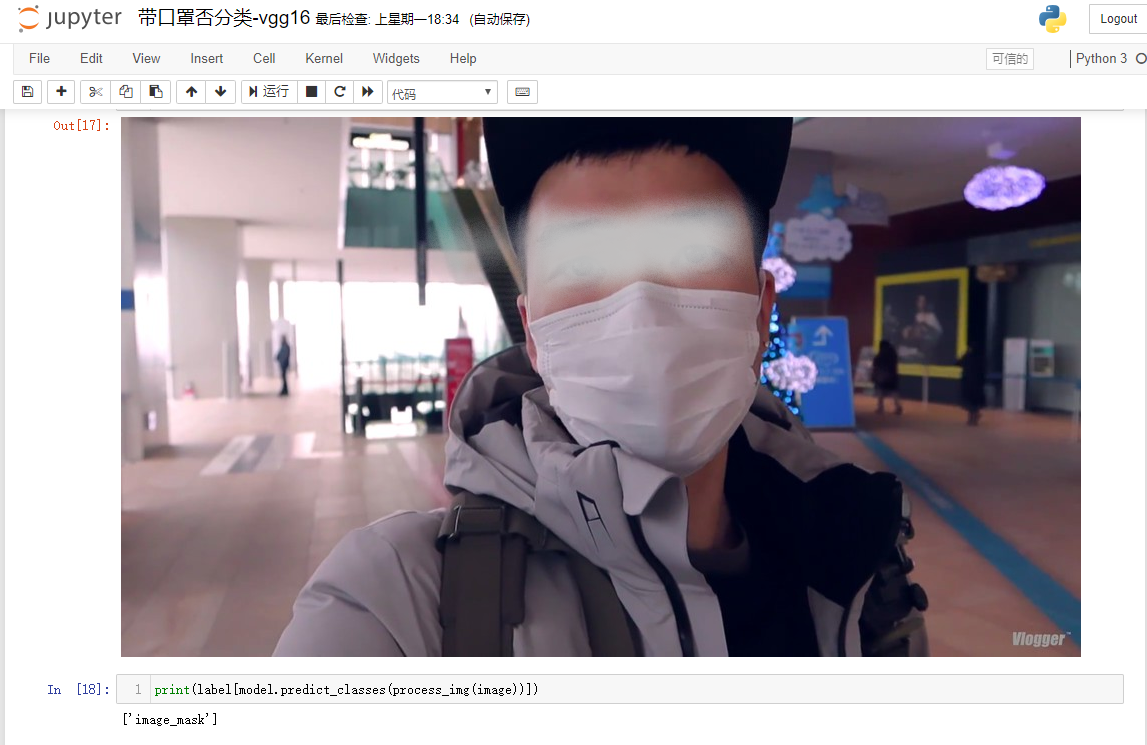
image = load_img('image/test/image_mask/0511.jpg')
image
print(label[model.predict_classes(process_img(image))])
小结
VGG16的突出特点是简单,体现在:
卷积层均采用相同的卷积核参数
卷积层均表示为conv3-XXX,其中conv3说明该卷积层采用的卷积核的尺寸(kernel size)是3,即宽(width)和高(height)均为3,3*3是很小的卷积核尺寸,结合其它参数(步幅stride=1,填充方式padding=same),这样就能够使得每一个卷积层(张量)与前一层(张量)保持相同的宽和高。XXX代表卷积层的通道数。
池化层均采用相同的池化核参数
池化层的参数均为2×
模型是由若干卷积层和池化层堆叠(stack)的方式构成,比较容易形成较深的网络结构(在2014年,16层已经被认为很深了)。
综合上述分析,可以概括VGG的优点为: Small filters, Deeper networks.