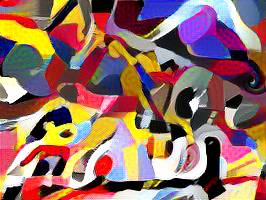
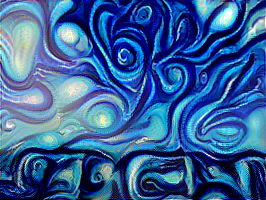
效果图
from keras.preprocessing.image import load_img, img_to_array
#from scipy.misc import imsave    # 最新版本的imsvae方法被弃用了
# from imageio import imwrite,imread
from imageio import imwrite as imsave
import numpy as np
from scipy.optimize import fmin_l_bfgs_b
import time
import matplotlib.pyplot as plt

from keras.applications import vgg16
# Keras并不处理如张量乘法、卷积等底层操作,需要调用backend
from keras import backend as K
# 设置参数
base_image_path = 'image/content/test2.jpg'
style_reference_image_path = 'image/style/styles1.jpg'
result_prefix = 'image/output/output'
iterations = 20
total_variation_weight = 8.5e-5  # 图片平滑处理
style_weight = 1.0  #风格权值
content_weight = 0.025  # 内容权值

# 设置产生图片的大小(将原来的图片进行等比缩放)
width, height = load_img(base_image_path).size
# 行
img_nrows = 200
# 列
img_ncols = int(width * img_nrows / height)
# 图片预处理
def preprocess_image(image_path):
    # 使用Keras内置函数读入图片并设置为指定长宽
    img = load_img(image_path, target_size=(img_nrows, img_ncols))
    # 转为numpy array格式
    img = img_to_array(img)
    #:keras中tensor是4维张量,所以给数据加上一个维度
    img = np.expand_dims(img, axis=0)
    # vgg提供的预处理,主要完成(1)减去颜色均值(2)RGB转BGR(3)维度调换三个任务。
    # 减去颜色均值可以提升效果
    # RGB转BGR是因为这个权重是在caffe上训练的,caffe的彩色维度顺序是BGR。
    # 维度调换是要根据系统设置的维度顺序theano/tensorflow将通道维调到正确的位置,如theano的通道维应为第二维
    img = vgg16.preprocess_input(img)
    return img
# 反向操作
def deprocess_image(x):
    x = x.reshape((img_nrows, img_ncols, 3))
    # 加上颜色均值
    x[:, :, 0] += 103.939
    x[:, :, 1] += 116.779
    x[:, :, 2] += 123.68
    # 'BGR'->'RGB'
    x = x[:, :, ::-1]
    x = np.clip(x, 0, 255).astype('uint8')
    return x
# 设置Gram矩阵的计算图,首先用batch_flatten将输出的feature map扁平化,
# 然后自己跟自己的转置矩阵做乘法,跟我们之前说过的过程一样。注意这里的输入是深度学习网络某一层的输出值。
def gram_matrix(x):
    # permute_dimensions按照给定的模式重排一个张量
    # batch_flatten将一个n阶张量转变为2阶张量,其第一维度保留不变,
    # 这里的扁平化主要是保留特征图的个数,让二维的特征图变成一维(类似上图)
    features = K.batch_flatten(K.permute_dimensions(x, (2, 0, 1)))
    # 格拉姆矩阵
    gram = K.dot(features, K.transpose(features))
    return gram

# 设置风格loss计算方式,以风格图片和待优化的图片的某一卷积层的输入作为输入。
# 计算他们的Gram矩阵,然后计算两个Gram矩阵的差的平方,除以一个归一化值
def style_loss(style, combination):
    assert K.ndim(style) == 3
    assert K.ndim(combination) == 3
    S = gram_matrix(style)
    C = gram_matrix(combination)
    channels = 3
    size = img_nrows * img_ncols
    return K.sum(K.square(S - C)) / (4. * (channels ** 2) * (size ** 2))

# 设置内容loss计算方式,以内容图片和待优化的图片的representation为输入,计算他们差的平方。像素级对比
def content_loss(base, combination):
    return K.sum(K.square(combination - base))

# 施加全变差正则,全变差正则化常用于图片去噪,可以使生成的图片更加平滑自然。
def total_variation_loss(x):
    assert K.ndim(x) == 4
    a = K.square(x[:, :img_nrows-1, :img_ncols-1, :] - x[:, 1:, :img_ncols-1, :])
    b = K.square(x[:, :img_nrows-1, :img_ncols-1, :] - x[:, :img_nrows-1, 1:, :])
    return K.sum(K.pow(a + b, 1.25))
# 读入内容和风格图,包装为Keras张量,这是一个4维张量
base_image = K.variable(preprocess_image(base_image_path)) # 内容图
style_reference_image = K.variable(preprocess_image(style_reference_image_path)) # 风格图

# 初始化一个待优化图片的占位符,这个地方待会儿实际跑起来的时候把噪声图片或者内容图片填进来。
combination_image = K.placeholder((1, img_nrows, img_ncols, 3))

# 将三个张量串联到一起,形成一个形状为(3,img_nrows,img_ncols,3)的张量
input_tensor = K.concatenate([base_image, style_reference_image, combination_image], axis=0)
# 载入模型
model = vgg16.VGG16(input_tensor=input_tensor, weights='imagenet', include_top=False)
print('Model loaded.')

# 这是一个字典,建立了层名称到层输出张量的映射,通过这个字典我们可以通过层的名字来获取其输出张量。
# 使用model.get_layer(layer_name).output的效果也是一样的。
outputs_dict = dict([(layer.name, layer.output) for layer in model.layers])

# 初始化loss值
loss = K.variable(0.)

# 计算内容损失取内容图像和待优化图像即可
# 这里只取了一层的输出进行对比,取多层输出效果变化不大
# layer_features就是图片在模型的block5_conv2这层的输出了,记得我们把输入做成了(3,nb_rows,nb_cols, 3)这样的张量,
# 0号位置对应内容图像的输出,1号是风格图像的,2号位置是待优化的图像的。
layer_features = outputs_dict['block5_conv2']
base_image_features = layer_features[0, :, :, :]
combination_features = layer_features[2, :, :, :]
# 计算内容损失
loss += content_weight * content_loss(base_image_features, combination_features)

# 计算风格损失
# 与上面的过程类似,只是对多个层的输出作用而已,求出各个层的风格loss,相加求平均即可。
feature_layers = ['block1_conv1', 'block2_conv1',
                  'block3_conv1', 'block4_conv1',
                  'block5_conv1']

for layer_name in feature_layers:
    layer_features = outputs_dict[layer_name]
    style_reference_features = layer_features[1, :, :, :]
    combination_features = layer_features[2, :, :, :]
    # 计算风格损失
    sl = style_loss(style_reference_features, combination_features)
    loss += (style_weight / len(feature_layers)) * sl

# 求全变差正则,加入总loss中
loss += total_variation_weight * total_variation_loss(combination_image)
# 得到loss函数关于combination_image的梯度
grads = K.gradients(loss, combination_image)

outputs = [loss]
# 我们希望同时得到梯度和损失,所以这两个都应该是计算图的输出
# 0号位置是loss,1号位置是grads
outputs += grads
# 编译计算图。前面的代码都在规定输入输出的计算关系,到这里才将计算图编译了。
# 这条语句以后,f_outputs就是一个可用的Keras函数,给定一个输入张量,就能获得其loss值和梯度了。
# 我们这里是一次计算同时可以得到loss和grads值
f_outputs = K.function([combination_image], outputs) # 第一个参数输入,第二个参数输出
# 获取loss和grads
def eval_loss_and_grads(x):
    # 把输入reshape层矩阵
    x = x.reshape((1, img_nrows, img_ncols, 3))
    # 这里调用了我们刚定义的计算图
    outs = f_outputs([x])
    loss_value = outs[0]
    # outs是一个长为2的tuple,0号位置是loss,1号位置是grads。把grads扁平化
    grad_values = outs[1].flatten().astype('float64')
    return loss_value, grad_values
# 定义了两个方法,一个用于返回loss,一个用于返回grads
class Evaluator(object):
    def __init__(self):
        # 初始化损失值和梯度值
        self.loss_value = None
        self.grads_values = None

    def loss(self, x):
        # 调用函数得到梯度值和损失值,但只返回损失值,而将梯度值保存在成员变量self.grads_values中
        assert self.loss_value is None
        loss_value, grad_values = eval_loss_and_grads(x)
        self.loss_value = loss_value
        self.grad_values = grad_values
        return self.loss_value

    def grads(self, x):
        # 这个函数不用做任何计算,只需要把成员变量self.grads_values的值返回去就行了
        assert self.loss_value is not None
        grad_values = np.copy(self.grad_values)
        self.loss_value = None
        self.grad_values = None
        return grad_values
evaluator = Evaluator()

# 使用内容图片作为待优化图片
x = preprocess_image(base_image_path)

# 显示原始图片
img = load_img(base_image_path, target_size=(img_nrows, img_ncols))
plt.imshow(img)
plt.axis('off')
plt.show()

for i in range(iterations):

    print('Start of iteration', i)
    start_time = time.time()
    # 使用(L-BFGS)算法来最小化loss的值
    # 参数1:传入一个带返回值的函数,然后最小化返回值
    # 参数2:初始值(初始图片)
    # 参数3:传入一个带返回值的函数,返回值是梯度
    # 参数4:迭代次数
    # 返回值1:优化后的值(改变的图片)
    # 返回值2:loss值
    # 返回值3:计算过程的一些信息
    x, min_val, info = fmin_l_bfgs_b(evaluator.loss, x.flatten(), fprime=evaluator.grads, maxfun=20)
    print('Current loss value:', min_val)

    # 反向操作,加上颜色均值,'BGR'->'RGB'
    img = deprocess_image(x.copy())

    # 保存每一张产生的新图片
    fname = result_prefix + '_at_iteration_%d.png' % i
    print('Image saved as', fname)
    imsave(fname, img)

    # 计算迭代1次花费的时间
    end_time = time.time()
    print('Iteration %d completed in %ds' % (i, end_time - start_time))

    # 显示图片
    plt.imshow(img)
    plt.axis('off')
    plt.show()
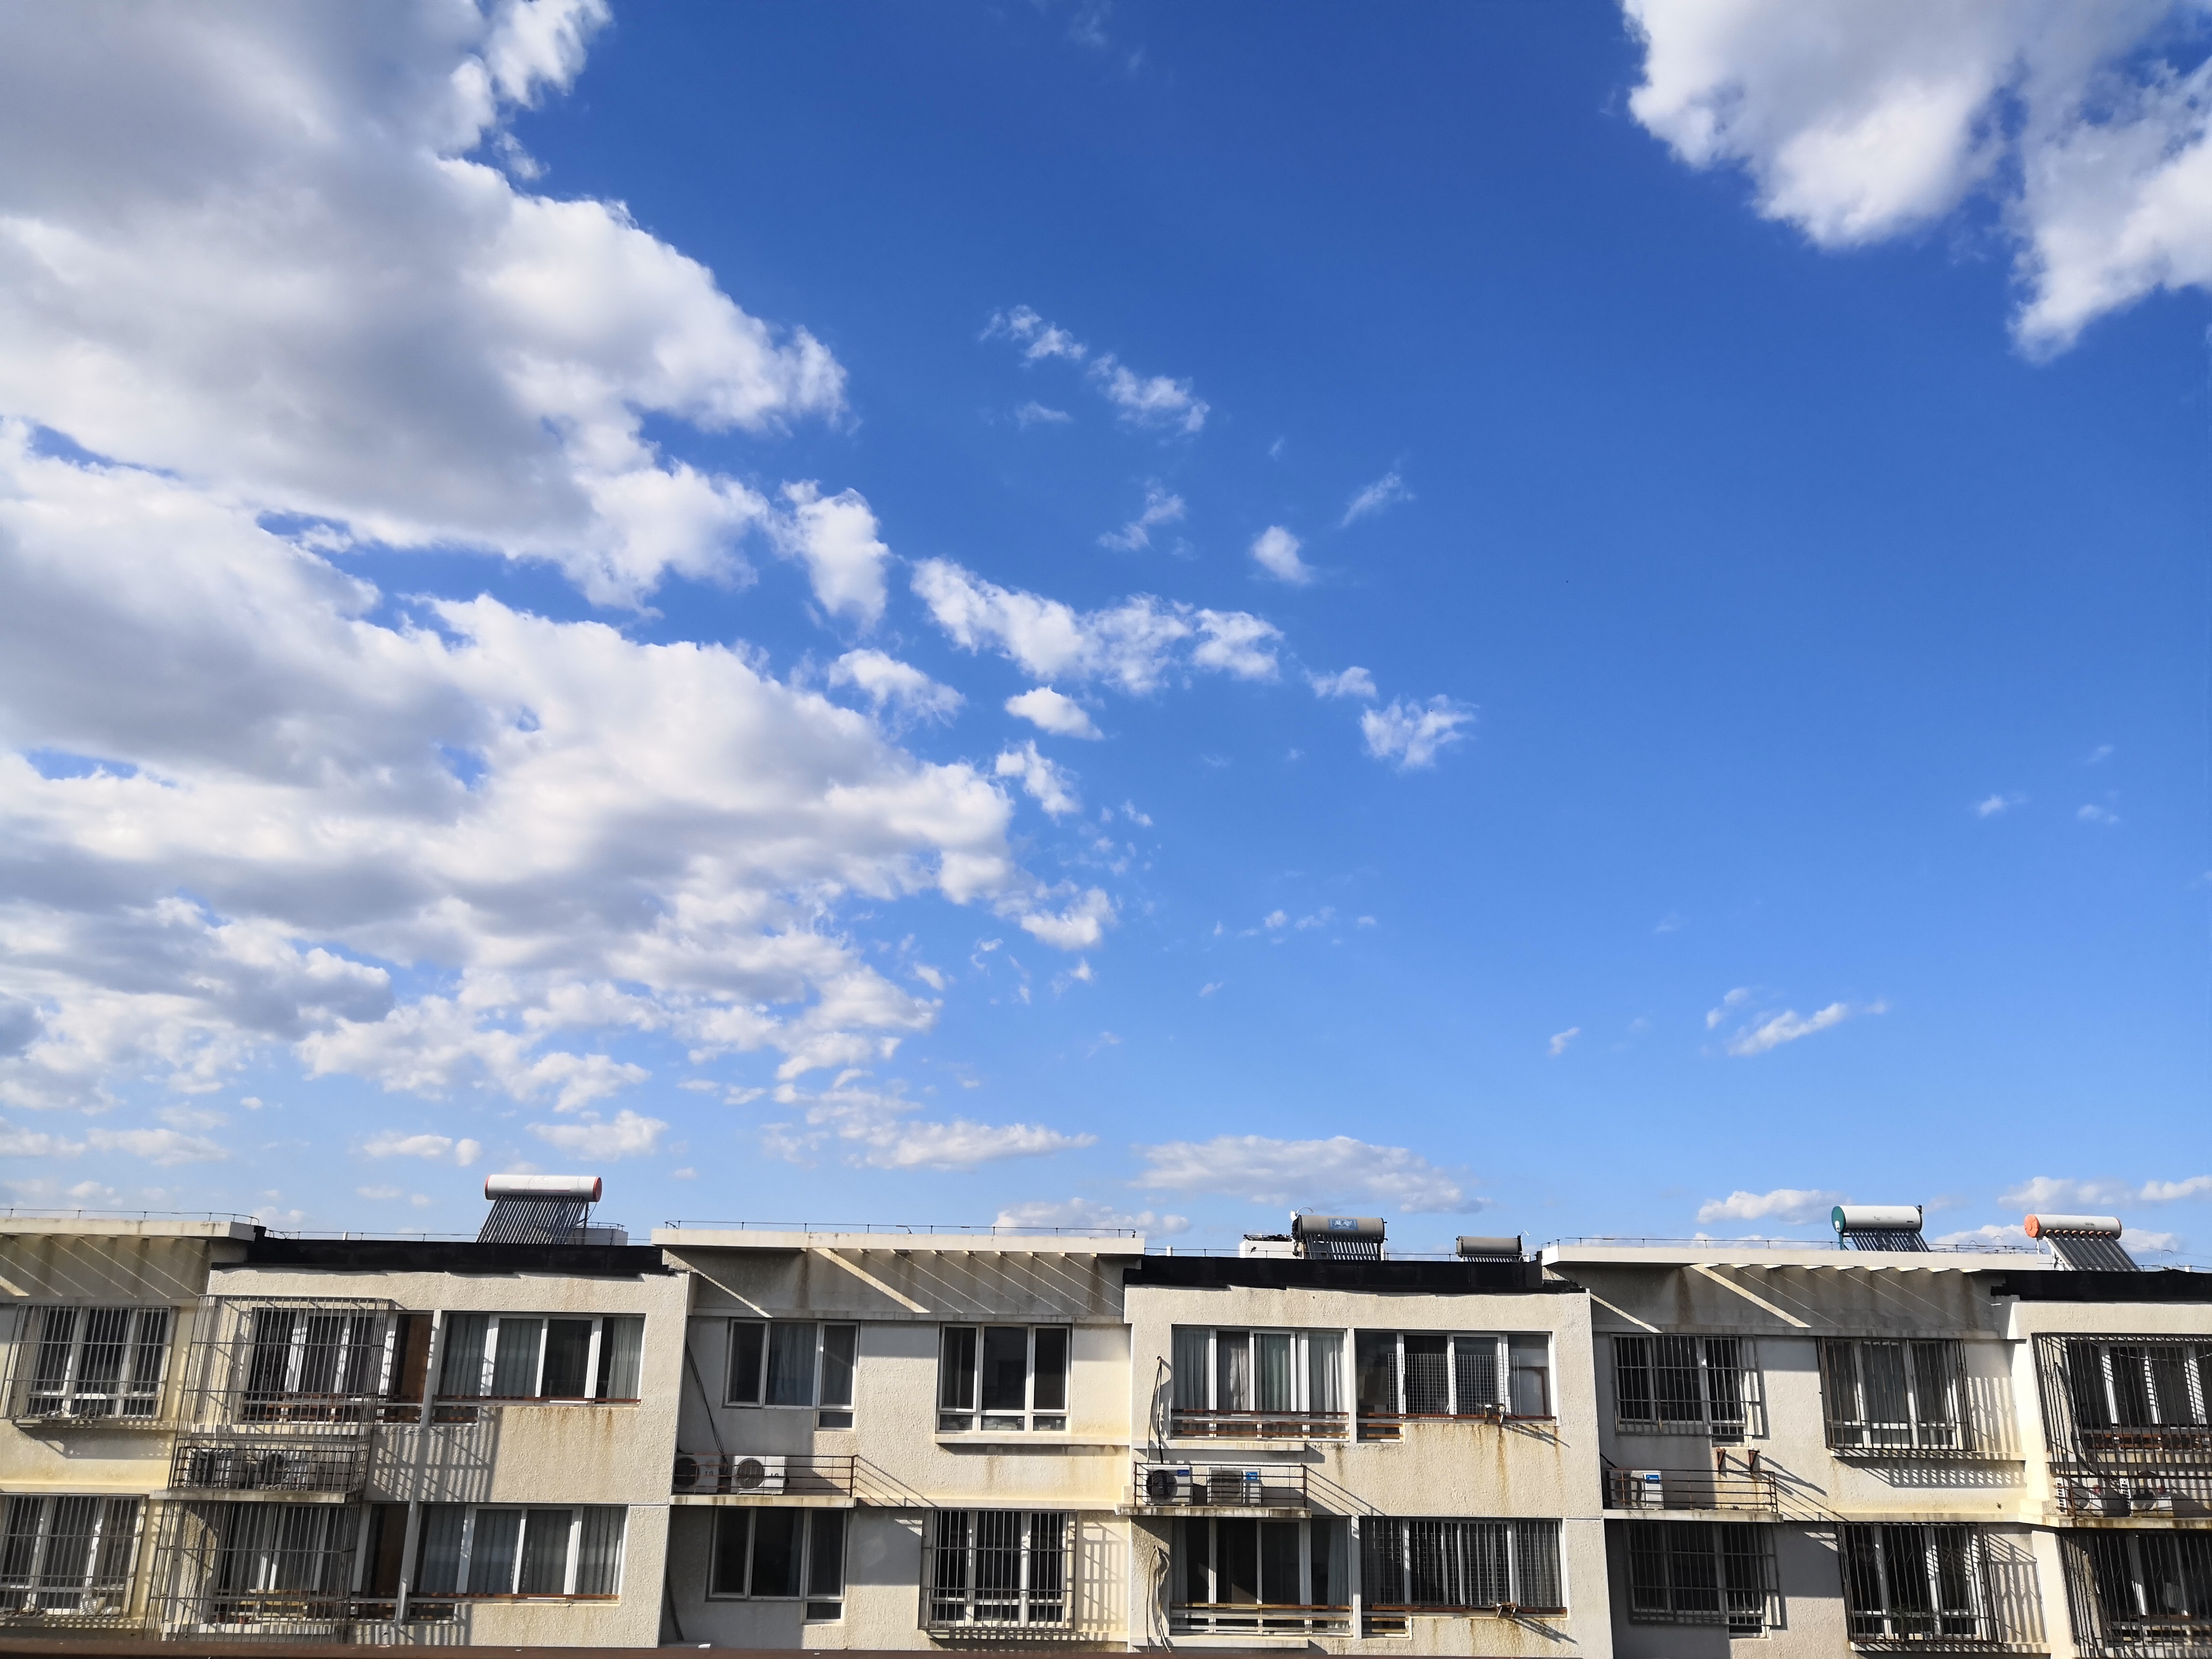
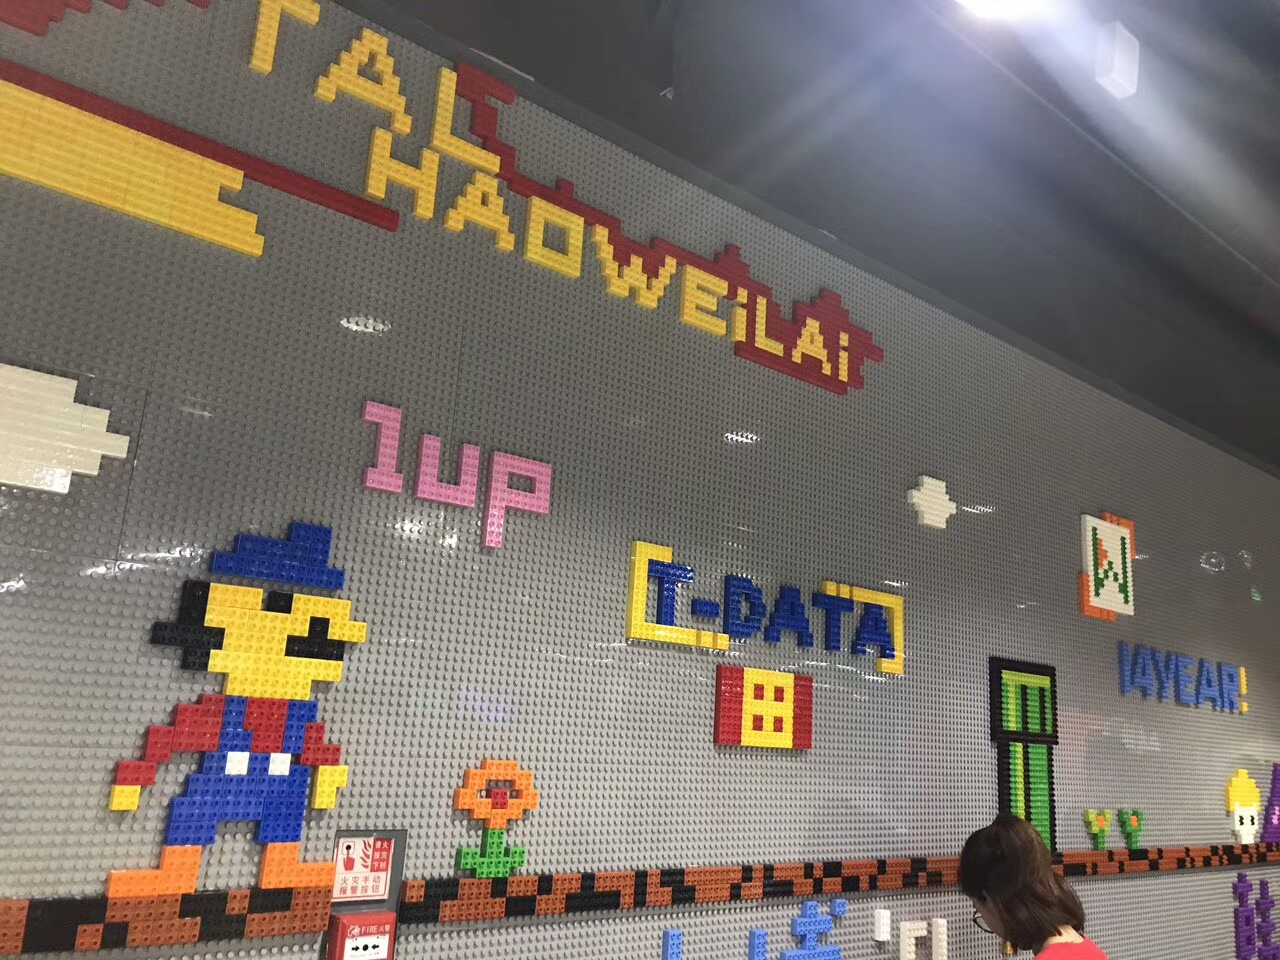
原始图:
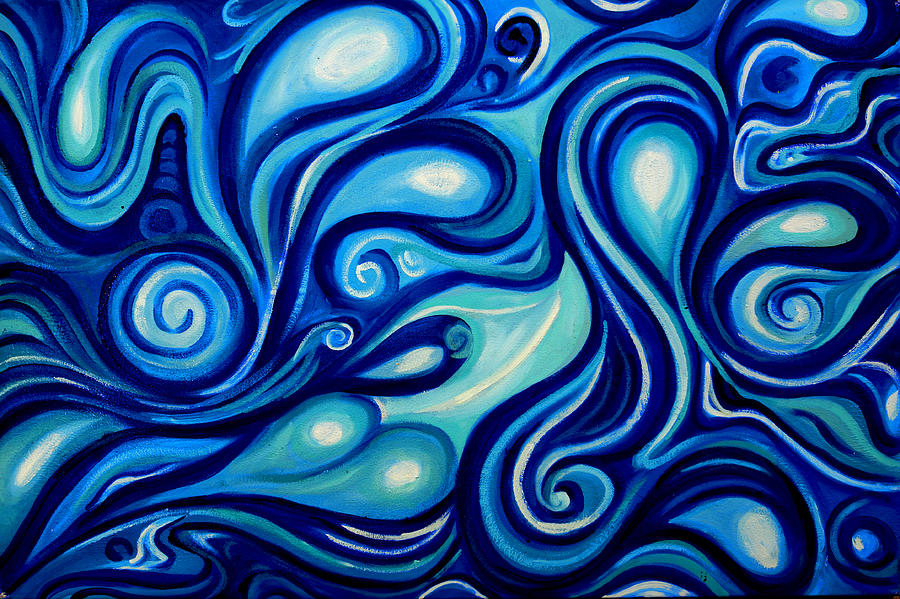
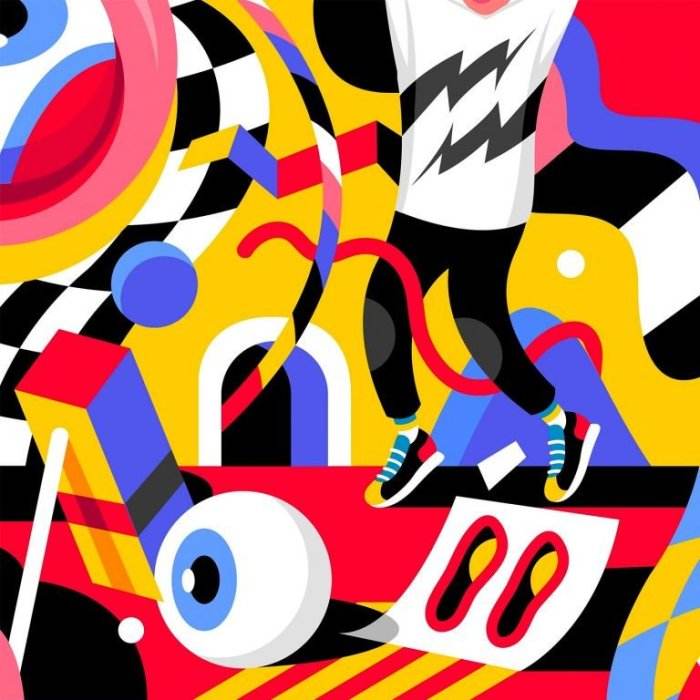
样式图:
结果图: