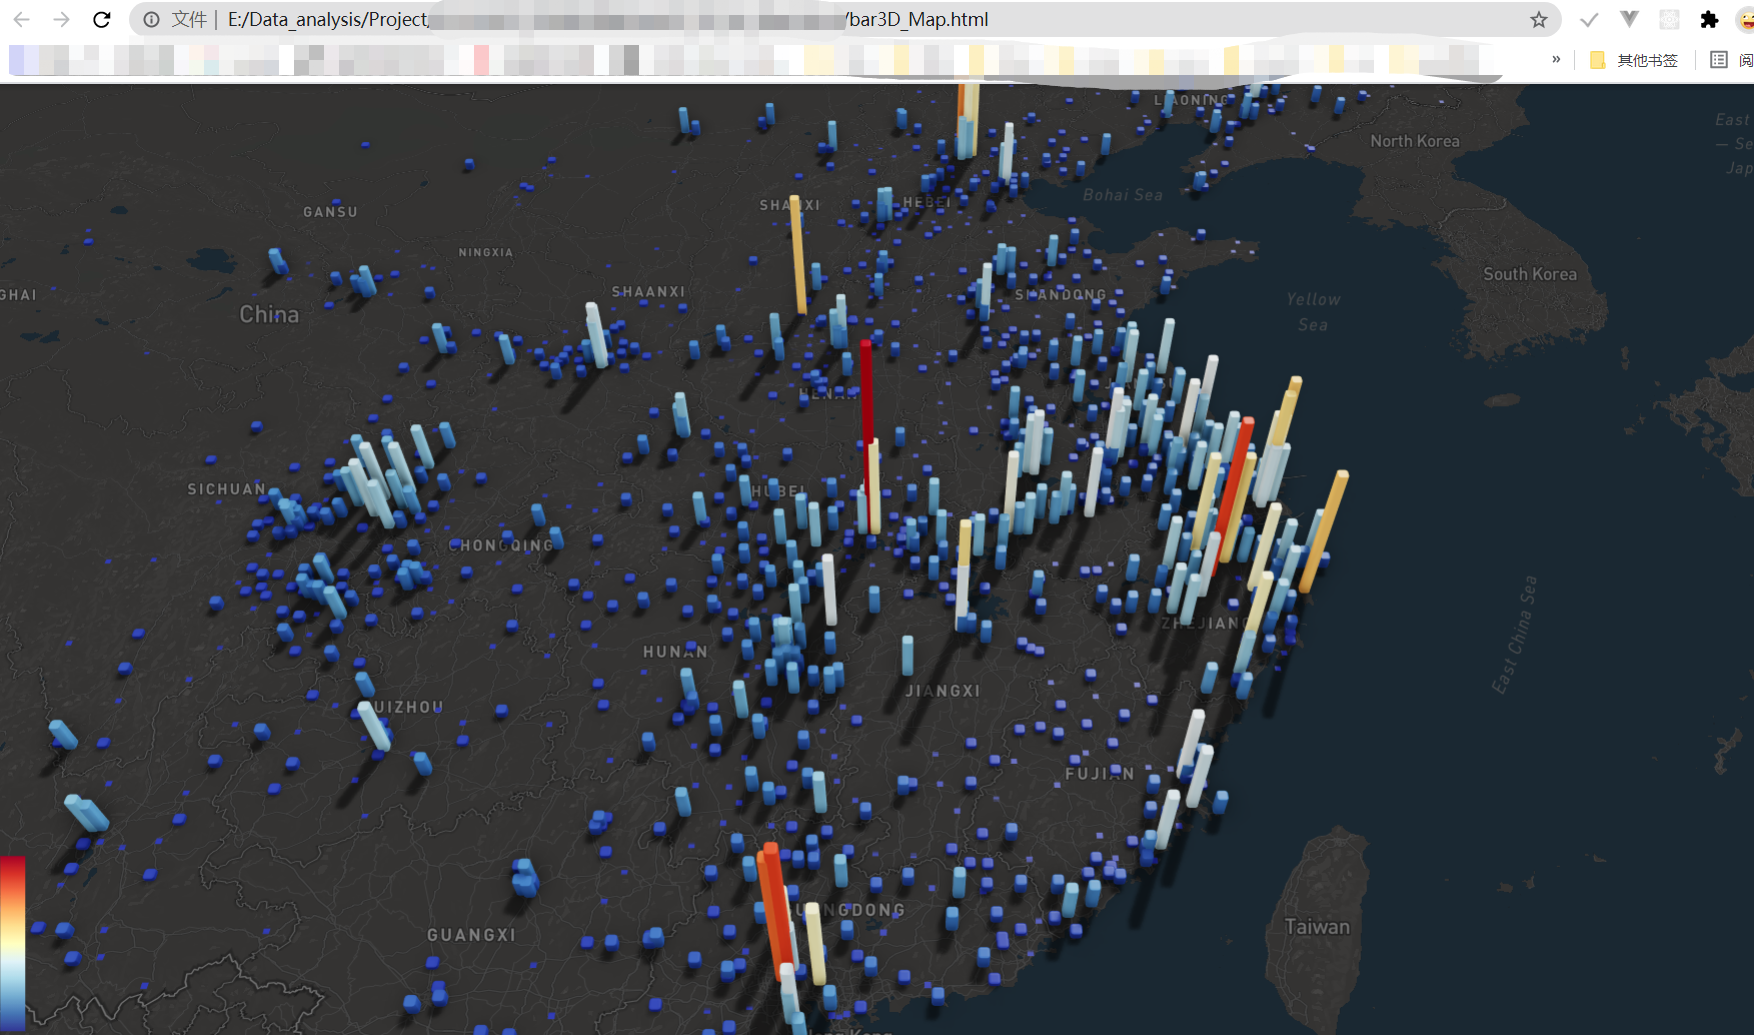
1、数据清洗、整合
源数据
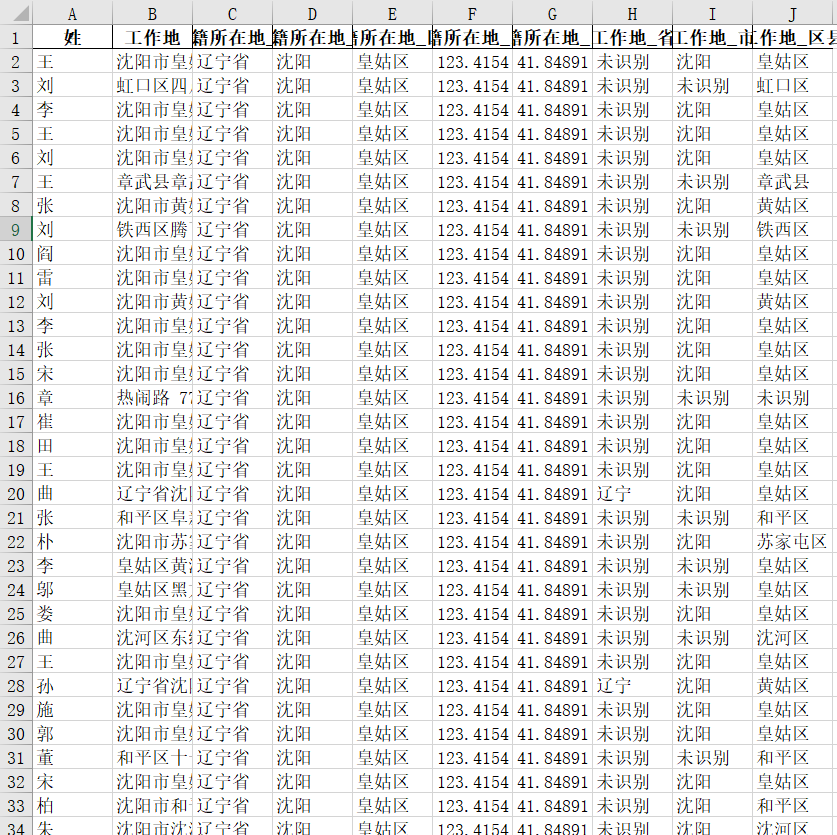
查看数据,数据清洗
# 查看数据,数据清洗

import os
os.chdir('C:/Users/Hjx/Desktop/项目09中国姓氏排行研究/')
# 创建工作路径

df01 = pd.read_csv('data01.csv',encoding = 'utf-8')
df02 = pd.read_csv('data02.csv',encoding = 'utf-8')
df_city = pd.read_excel('中国行政代码对照表.xlsx')
# 读取数据

df = pd.concat([df01,df02])
df = pd.merge(df,df_city,left_on='户籍地城市编号',right_on = '行政编码')
df['工作地'] = df['工作地'].str[:15]   # 只提取工作地前15个字符即可
del df['行政编码']
del df['户籍地城市编号']
# 合并数据,添加经纬度字段
# 删除无用字段

print('读取数据共%i条' % len(df))
df.head(20)
数据整理
# 分别提取“工作地”中的省、市、区县
# 新建字段“工作地-省”,“工作地-市”,“工作地-区县”,如果数据中“工作地”字段无法提取省和市,则用“未识别”填充单元格
# *通过查看识别后的单元格,如果字数超过5则为“未识别”

df['工作地_省'] = df['工作地'].str.split('省').str[0]
# 识别工作地-省

df['工作地_市'] = df['工作地'].str.split('省').str[1].str.split('市').str[0]
df['工作地_市'][df['工作地_省'].str.len() > 5] = df['工作地_省'].str.split('市').str[0]
# 识别工作地-市
# 在未识别出省的数据中,可能会有市的信息

df['工作地_区县'] = ''
df['工作地_区县'][(df['工作地_市'].str.len() < 5)&(df['工作地'].str.contains('区'))] = df['工作地'].str.split('市').str[1].str.split('区').str[0] + '区'
df['工作地_区县'][(df['工作地_市'].str.len() > 5)&(df['工作地'].str.contains('区'))] = df['工作地'].str.split('区').str[0] + '区'
df['工作地_区县'][(df['工作地_市'].str.len() < 5)&(df['工作地'].str.contains('县'))] = df['工作地'].str.split('市').str[1].str.split('县').str[0] + '县'
df['工作地_区县'][(df['工作地_市'].str.len() > 5)&(df['工作地'].str.contains('县'))] = df['工作地'].str.split('县').str[0] + '县'
# 识别工作地-区县

df['工作地_省'][df['工作地_省'].str.len() > 5] = '未识别'
df['工作地_市'][df['工作地_市'].str.len() > 5] = '未识别'
df['工作地_区县'][(df['工作地_区县'].str.len() > 5) | (df['工作地_区县'].str.len() < 2)] = '未识别'
# 整理未识别单元格

df.columns = ['姓','工作地','户籍所在地_省','户籍所在地_市','户籍所在地_区县','户籍所在地_lng','户籍所在地_lat',
              '工作地_省','工作地_市','工作地_区县']
print('读取数据共%i条' % len(df))
# 数据整理
df.head(20)
2、查看姓氏“普遍指数”
将数据按照“姓”做统计,找到数量最多的TOP20
# 将数据按照“姓”做统计,找到数量最多的TOP10

name_count = df['姓'].value_counts()[:20]
result1_01 = pd.DataFrame({'count':name_count, 'count_pre':name_count/name_count.sum()})
# 筛选top20的姓氏,计数并计算占比
result1_01
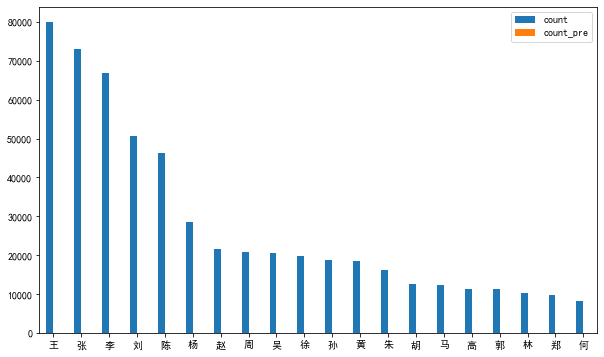
bokeh出联动柱状图
# bokeh出联动柱状图

from bokeh.models import HoverTool
from bokeh.layouts import gridplot
# 导入模块
output_file("xingshipaihang.html")
name_lst = result1_01.index.tolist()
source = ColumnDataSource(result1_01)
# 创建ColumnDataSource数据

hover1 = HoverTool(tooltips=[("姓氏计数", "@count")])  # 设置标签显示内容
result1 = figure(plot_width=800, plot_height=250,x_range = name_lst,
                 title="中国姓氏TOP20 - 计数" ,
                 tools=[hover1,'reset,xwheel_zoom,pan'])   # 构建绘图空间
result1.vbar(x='index', top='count', source=source,width=0.9, alpha = 0.7,color = 'red')
result1.ygrid.grid_line_dash = [6, 4]
result1.xgrid.grid_line_dash = [6, 4]
# 柱状图1


from math import pi
from bokeh.palettes import Category20c
from bokeh.transform import cumsum
top20=result1_01
top20['angle'] = result1_01['count_pre']* 2*pi
top20['color'] = Category20c[len(top20)]

result3 = figure(plot_height=350, title="Pie Chart", toolbar_location=None,
           tools="hover", tooltips="@index: @count_pre", x_range=(-0.5, 1.0))

result3.wedge(x=0, y=1, radius=0.4,
        start_angle=cumsum('angle', include_zero=True), end_angle=cumsum('angle'),
        line_color="white", fill_color='color', legend_field='index', source=top20)

result3.axis.axis_label=None
result3.axis.visible=False
result3.grid.grid_line_color = None


p = gridplot([[result1], [result3]])
# 组合图表
show(p)
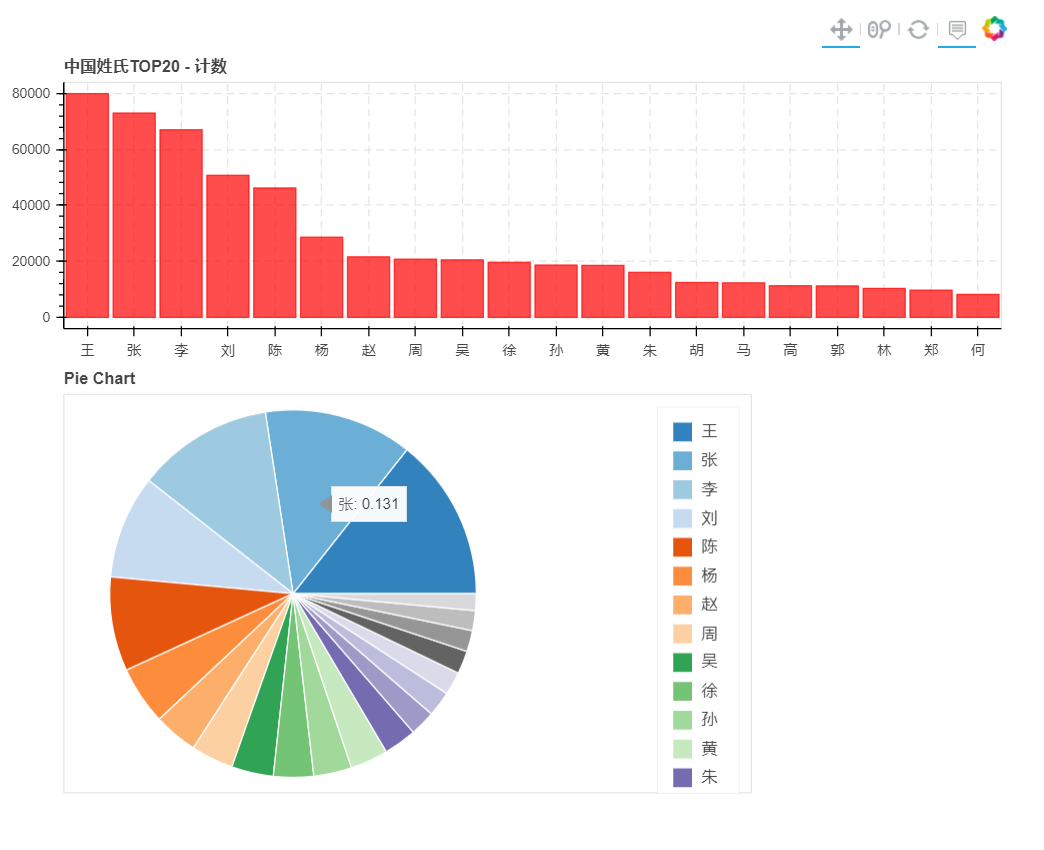
查看“何”姓的全国分布
# 查看“何”姓的全国分布

data_he1 = df[df['姓'] == '何']
data_he2 = data_he1.groupby(['姓','户籍所在地_lng','户籍所在地_lat'])['户籍所在地_市'].count()
data_he2 = data_he2.reset_index()
writer = pd.ExcelWriter('E:\\Data_analysis\\Project\\03\\he2.xlsx')
data_he2.to_excel(writer,'sheet1',index=False)
writer.save()
# 导出数据

print('导出完成!')
使用excel3d查看分布
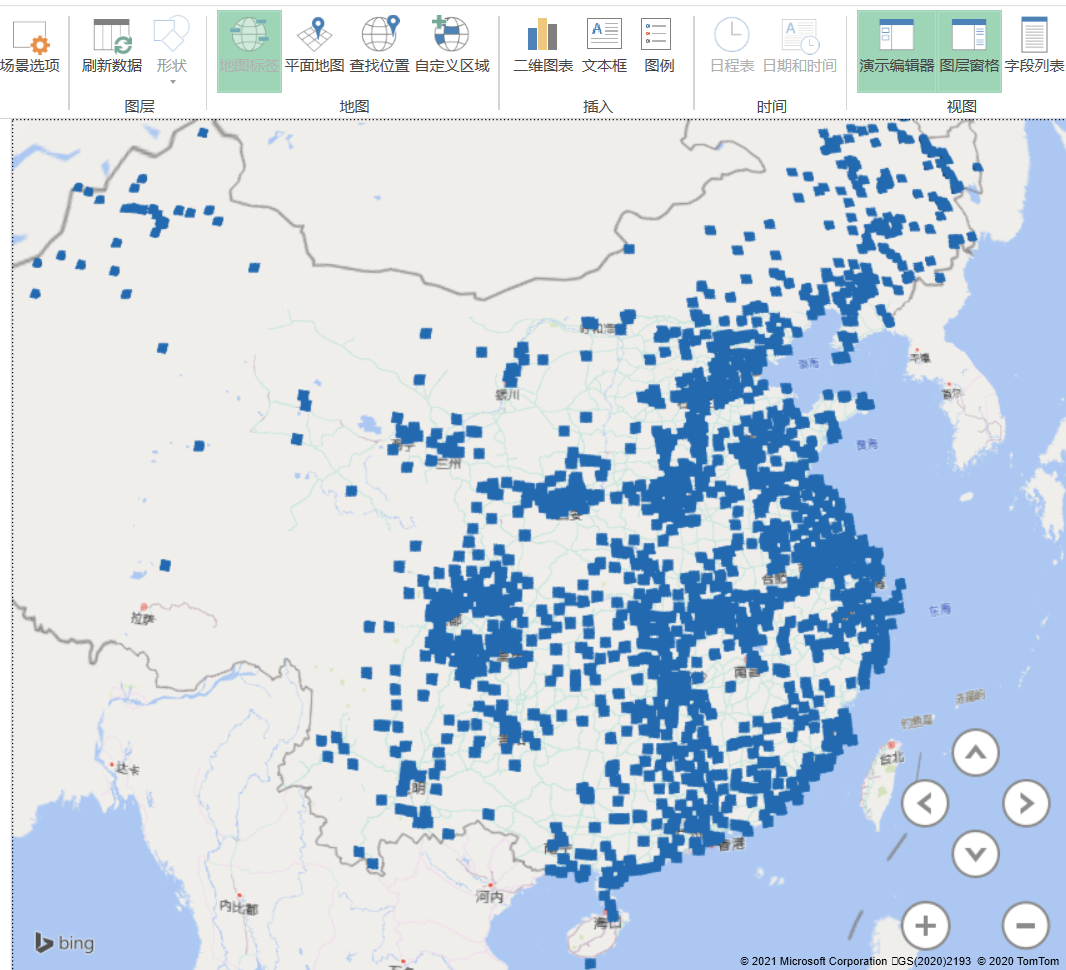
使用echart作图