Agent 服务阶梯压测与容量承诺:拐点识别、SSE 判定与配额约束
导读:本文用一次完整实践回答 LLM/Agent 服务压测最常被问的三个问题——同时能撑多少人聊、瓶颈在哪、容量承诺怎么给。核心方法是 JMeter 阶梯加压逐档找软拐点(P95 抬头、稳定仍绿)与硬拐点(错误率抬头、连接层开始拒绝),并强调 SSE 流式接口"HTTP 200 但无可用 content 一律记失败"的判定口径(本次实测曾出现 3 并发档的空心 200);关键结论是共享 LLM 配额下不能按节点数线性扩容("10×3=30"仅在瓶颈全在本机时成立),最终以"常态 ≤10 并发/单实例、发版门禁错误率 ≤1%、P95 ≤35s"作为可落地的容量承诺。适合给 Agent/LLM 服务做压测、容量评估与发版门禁设计的性能工程师。 分类:性能测试 | 标签:压测、性能测试、Agent、容量评估
给 LLM/Agent 服务做压测,业务方最常问的三个问题:同时能撑多少人聊?瓶颈在哪?能不能对容量做承诺?这篇文章用一次完整的实践来回答——怎么用 JMeter 阶梯加压逐档找拐点;流式接口的"成功"到底怎么判定;为什么共享 LLM 配额下不能按节点数线性扩容;以及最后怎么给出一个既不吹牛、又能落地的容量承诺。
说明:本文所有数值保留原报告数量级,仅作方法示意,数据已脱敏。
一、为什么要做 Agent 服务压测
Agent 服务和传统 Web 服务在压测上有本质区别:
- 单次请求耗时极长:一轮完整问答要走「模型推理 + 工具/技能调用 + 流式吐字」,5~60s+ 是常态,不能按传统接口的秒级甚至毫秒级标准衡量;
- 成功/失败判定复杂:SSE 流式返回 HTTP 200 不代表成功,可能拿到一个"空心"响应;
- 容量瓶颈在共享资源:模型配额、知识库、上游 API 通常是全局共享的,多节点扩容不等于线性扩容;
- 业务影响大:Agent 服务一旦过载,用户看到的不是"慢",而是"没答上来"。
因此,Agent 压测的核心目标不是"压出最高吞吐",而是找到服务从"能扛"到"开始劣化"再到"彻底失败"的边界,为容量承诺提供依据。
二、方法与档位
阶梯压测的原则是不一次性打满,逐档加压:一般按 1 → 5 → 10 → 20 → 50 → 100 并发的阶梯往上走,每档跑固定轮数,记录成功率、延迟百分位与吞吐,观察在哪一档出现劣化。
本次实践实际执行的档位是 2/3/5/10/15/20 并发逐档(视轮次需要补测),每线程每档 3~5 轮。几个测量口径需要提前对齐:
- 并发 = 同时进行中的对话数(每人一轮完整问答),不是每秒请求数(QPS)。单次问答几十秒,用传统高 RPS 标准解读吞吐没有意义;
- 样本少时百分位会抖,对比以错误率和 P95/P99 为主,不要单看平均数;
- 题库策略分层:容量基线用 1 套混合词表即可(覆盖知识库检索 / 工具调用 / 纯问答主路径);要定位某条链路瓶颈时,再按路径拆 2~3 套分路径词表、同并发各跑一轮对比;发版门禁则固定 1 份代表题(每条主路径 1~2 题),保证版本间可比;
- 流量可归因:压测期间给所有请求打统一标识,可在可观测平台按标识归因每档的 token 消耗,也能把测试流量和真实流量区分开。
三、关键判定口径
1. SSE 流式接口的"成功"判定
流式接口返回 HTTP 200 不等于成功。本轮统一口径:响应必须真正收到可用的 content(SSE delta 或 JSON 内容)才算成功;HTTP 200 但 content 为空,一律记失败。
更细的判定是看首帧/末帧:流式问答要么看"是否收到了首个内容帧"(确认链路真的开始吐字、首包到达),要么看"是否收到了结束帧"(确认回答完整结束)。只数 HTTP 状态码会漏掉两种假成功:
- 空心 200:HTTP 200、包体不小,但解析后没有任何可用 content。本次 3 并发档就出现过一例:HTTP 200、包体 2 万多字节,断言仍报
response missing content (SSE delta or JSON),属偶发空响应而非超时; - 断流 200:中途断流但连接层没报错。
这类"假成功"在高并发下容易被监控漏掉,必须写进断言,并在发版门禁里按错误处理。
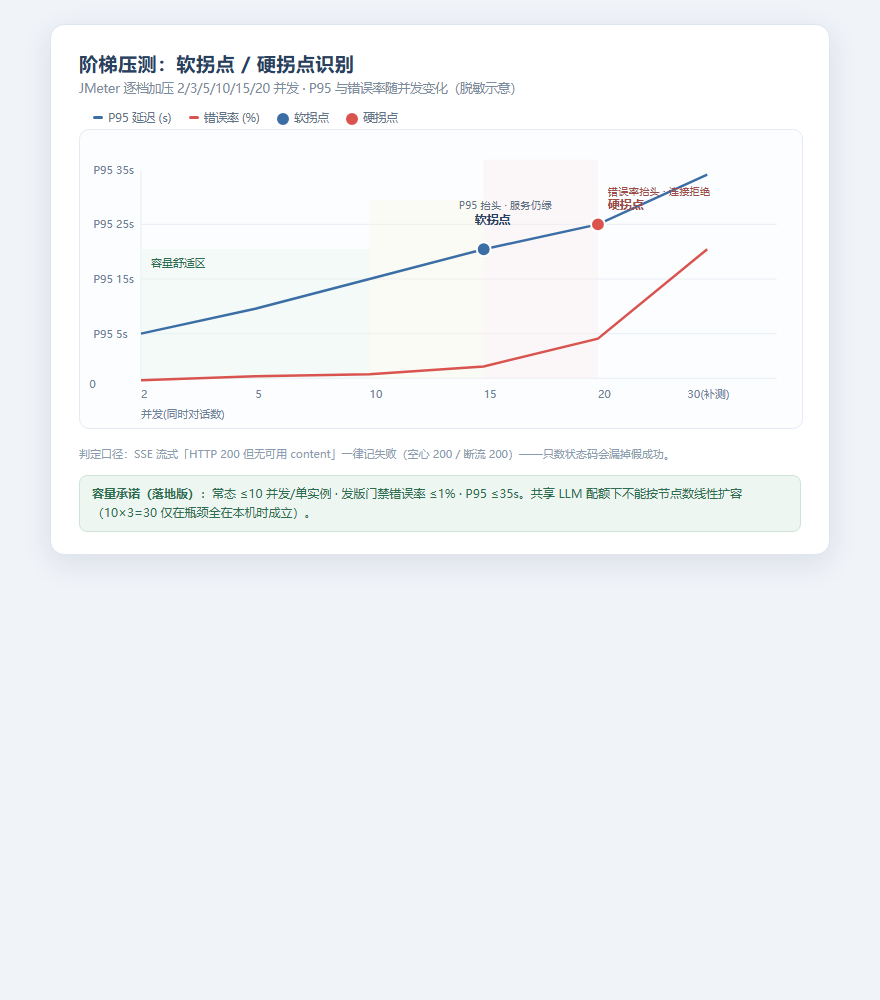
2. 软拐点与硬拐点
- 软拐点:成功率或响应时间开始劣化的点——延迟百分位开始抬头、排队成本上升,但服务本身没崩;
- 硬拐点:出现彻底失败的点——错误率抬头、最大延迟失控、连接层开始拒绝或断开。
阶梯压测最重要的产出,就是用软拐点划出容量舒适区的边界,用硬拐点定出不可承诺的上限。
软/硬拐点识别曲线(同一批示意数据):
3. 共享 LLM 配额下不能按节点数线性扩容
"有负载均衡、3 台机器,是不是就能承诺 10×3=30 人同时问?"——不能直接乘。10×3=30 只在"瓶颈全在各节点本机、三台互不抢上游"时才近似成立;而 Agent 服务几乎必然共享 LLM 配额 / 知识库 / 上游 API,共享资源的容量往往远不到 ×3:
| 情况 | 大约等于 |
|---|---|
| 瓶颈主要在本机 Agent,上游够宽 | 接近 20~30 同时会话 |
| 瓶颈在共享 LLM / 知识库 / 上游(很常见) | 只比单机略好,不能按 ×3 承诺 |
| 会话粘滞、负载不均 | 还要再打折 |
这是 Agent 压测与普通服务压测最大的区别之一:扩容节点之前,先搞清楚共享配额在哪、余量多少。
四、环境对照:同一方法,两套测试环境
同样的压测方案(JMeter 阶梯 + 同一套题库)在测试环境 A 和测试环境 B 各跑一轮。两环境机器 / 模型 / 配额都不同,对照仅作量级参考。
测试环境 A(主测)
| 并发 | Loops | N | 错误率 | 平均 ms | 中位 ms | P90 | P95 | P99 | 最大 | 吞吐 req/s |
|---|---|---|---|---|---|---|---|---|---|---|
| 3 | 5 | 15 | 6.7% | 20442 | 18846 | 29038 | 31421 | 31671 | 31734 | 0.114 |
| 5 | 5 | 25 | 0.0% | 21419 | 20951 | 25820 | 30065 | 32078 | 32453 | 0.180 |
| 10 | 4 | 40 | 0.0% | 22340 | 22780 | 28326 | 29380 | 35212 | 38453 | 0.254 |
| 15 | 5 | 75 | 0.0% | 24886 | 24788 | 33153 | 35271 | 36638 | 38040 | 0.424 |
延迟一览(秒):
| 并发 | 中位 | P95 | P99 | 最大 |
|---|---|---|---|---|
| 3 | 18.8 | 31.4 | 31.7 | 31.7 |
| 5 | 21.0 | 30.1 | 32.1 | 32.5 |
| 10 | 22.8 | 29.4 | 35.2 | 38.5 |
| 15 | 24.8 | 35.3 | 36.6 | 38.0 |
趋势解读:
- 3 并发:中位 18.8s,错误率 6.7%(1/15)。失败样本 HTTP 仍 200,断言
response missing content(SSE delta 或 JSON 无 content),属偶发空响应而非超时; - 5 并发:中位 21.0s,0% 错误,P95 相对 3 并发反略降;
- 10 并发:中位 22.8s,P95 约 29s,吞吐 0.254 req/s,0% 错误;
- 15 并发(补测):中位 24.8s、0% 错误、吞吐升至 0.424 req/s,但 P95 升至 35.3s(相对 10 档 +约 6s),越过"半分钟体验"门槛边缘。
拐点判断:10→15 为软拐点——中位仍缓升,P95 开始明显抬头,稳定性仍全绿,未出现硬拐点式的尾部崩溃。
测试环境 B(对照)
| 并发 | Loops | N | 错误率 | 平均 ms | 中位 ms | P90 | P95 | P99 | 最大 | 吞吐 req/s |
|---|---|---|---|---|---|---|---|---|---|---|
| 2 | 5 | 10 | 0.0% | 9911 | 8943 | 15182 | 15371 | 15522 | 15560 | 0.135 |
| 5 | 3 | 15 | 0.0% | 16142 | 11652 | 21559 | 31603 | 48429 | 52636 | 0.145 |
| 10 | 5 | 50 | 0.0% | 16752 | 14465 | 29143 | 32300 | 33986 | 34309 | 0.316 |
| 15 | 5 | 75 | 0.0% | 24646 | 22238 | 41957 | 46460 | 61476 | 78156 | 0.292 |
延迟一览(秒):
| 并发 | 中位 | P95 | P99 | 最大 |
|---|---|---|---|---|
| 2 | 8.9 | 15.4 | 15.5 | 15.6 |
| 5 | 11.7 | 31.6 | 48.4 | 52.6 |
| 10 | 14.5 | 32.3 | 34.0 | 34.3 |
| 15 | 22.2 | 46.5 | 61.5 | 78.2 |
趋势解读:2 并发接近无人排队的基线;10 并发以内仍相对平稳;10→15 拐点迹象明显——中位 +约 54%、P95 +约 44%,最大延迟冲到 78.2s,体感就是"排队成本陡增"。
同档对照
10 并发:
| 环境 | 中位 | P95 | 最大 | 错误率 | 吞吐 req/s |
|---|---|---|---|---|---|
| 环境 A | 22.8s | 29.4s | 38.5s | 0% | 0.254 |
| 环境 B | 14.5s | 32.3s | 34.3s | 0% | 0.316 |
15 并发:
| 环境 | 中位 | P95 | 最大 | 错误率 |
|---|---|---|---|---|
| 环境 A | 24.8s | 35.3s | 38.0s | 0% |
| 环境 B | 22.2s | 46.5s | 78.2s | 0% |
要点:10 并发时环境 A 中位比环境 B 慢约 57%;15 并发时环境 A 中位仍略慢,但尾部(P95/最大)明显更稳(约 35s/38s vs 46s/78s)。两环境机器、模型、配额都不同,这份对照的结论只有一个:压测结论不能跨环境直接搬,量级参考即可,换部署环境必须重测。
五、线上验证:受控压测与三档水位
测试环境的结论要兑现成线上承诺,还需要在生产环境做一轮受控验证。线上压测有两条硬约束:
- 只压"首轮问答/引导":报销、预定等只走到引导步骤,不真提交、不真落库,避免脏数据,把对生产的影响降到最小;
- 安全窗口与监控:选在业务低峰时段执行(晚间),压测结束后立即核对告警;后续要压"真提交"类链路,需要专用账号与回滚方案。
线上三档水位
| 水位 | 建议人数 | 含义 |
|---|---|---|
| 舒适区(低) | ≤ 10 人同时聊 | 本轮 0 失败,P95 约 1.5 分钟内 |
| 警戒区(中) | 11~15 人 | 未单独测 15,按 10→20 插值预估,建议有监控再放量 |
| 压力上限(高) | ≈ 20 人 | SSE 失败率约 5%,已出现网关无响应 / 偶发 404 |
分档明细(对话链路,SSE 流式回答):
| 并发 | 样本数 | 失败 | 错误率 | 平均 | 中位 | P95 | 最大 |
|---|---|---|---|---|---|---|---|
| 2 | 6 | 0 | 0% | 53.1s | 63.4s | 82.4s | 82.7s |
| 5 | 15 | 0 | 0% | 41.9s | 29.3s | 85.4s | 100.5s |
| 10 | 30 | 0 | 0% | 44.3s | 35.8s | 86.6s | 89.7s |
| 20 | 60 | 3 | 5% | 37.5s | 24.3s | 86.3s | 90.2s |
注意一个容易踩的坑:20 并发时中位反而变短(短答题混入 + 失败样本耗时极短),看容量必须盯"错误率 + P95",不要只看平均/中位。
瓶颈定位
- 建会话不是瓶颈:创建会话(POST /api/sessions)平均约 100ms,20 并发也基本在 1s 内;鉴权(GET /api/me)同样在 1s 内 → 登录态与会话创建正常;
- 主瓶颈在"对话 SSE"整段链路:中位约 25~60s,P95 稳定在 85s 上下,覆盖模型推理、工具/技能调用、流式吐字;
- 20 并发时连接层开始露馅:失败样本为连接无响应(
NoHttpResponseException,连接被对端关闭/未响应,偏网关或上游过载)与偶发 404(瞬时过载/会话状态异常)。此时瓶颈已从"只是慢一点"变成"偶发直接失败"——用户会感知到"没答上来"。
六、容量承诺怎么给
汇总两轮测试环境 + 一轮线上验证,容量建议如下:
| 维度 | 建议口径 |
|---|---|
| 容量承诺 | 常态 ≤10 并发 / 单实例(同时进行中的对话) |
| 发版门禁 | 10 并发 + 固定代表题库 + 错误率 ≤1%(空 content 也算错)+ P95 ≤35s |
| 延迟体验 | 产品要"半分钟内"→ 卡 P95 ≤30s(对应 ≤10 并发);接受略慢 → P95≤35s 时 15 并发仅作内部预警 |
| 超时策略 | 单次硬超时建议 60~90s,失败要有明确提示 |
| 限流 / 告警 | 15 并发(P95≈35s)作为告警 / 限流触发点,不对外承诺 |
| 成本控制 | 每轮问答约 3 万+ tokens(脱敏示意),上线前定 Token 日预算与超限策略 |
关于"多实例扩容"的正确姿势:
- 先别乘:单实例承诺仍按 ≤10 并发;
- 多实例经负载均衡后先按 15~20 试算,再实测 20 / 30 总并发验收,通过后再定最终数;
- 始终记得共享配额(LLM / 知识库 / 上游)才是总容量的天花板,"10×3=30"只在理想化假设下成立。
对外一句话口径:
大约同时 10 人聊得动、多数半分钟左右出结果、出错极少;15 人以上靠限流保体验,不保证尾部延迟。
写在最后
给 Agent / LLM 服务的容量承诺,本质上是在错误率、P95 延迟、共享配额三个数之间找边界。流程上走完四步——阶梯压测找拐点、明确 SSE 成功判定口径、多环境对照、线上受控验证——承诺才算有依据。压测结论不要跨环境搬,也不要对"×N 扩容"想当然;对用户,则从一开始就讲清楚"多少人能聊、多久出结果、出错概率多大",比承诺一个好看的数字实在得多。