模型没变慢,慢在编排与工具:一次基于 trace 的线上 Agent 运行时体检
导读:本文基于线上全量 trace 对两个 Agent 技能做「运行时体检」,起因是一次空转 12 分 20 秒被强制中断的提问(模型逐人查 149 人、撞递归上限 350 步)。核心结论:模型升级并没有变慢(同源同日 A/B 下单次生成与首 token 反而更快),慢在编排与工具——一轮问答平均 14~16 次模型调用加 20~23 次工具调用,沙箱脚本约占工具耗时 76%,且平台「0% 错误率」只是流未断的假象,真实异常(递归越界)从 9/14 起明显上升。给出的方向是「Proxy 化下沉+SKILL.md 执行纪律」,并附 7 条「代理化信号」清单与量化验收目标。适合做 Agent 应用性能优化、评测与架构下沉的工程师阅读。
分类:AI评测 | 标签:Agent、trace分析、性能分析、编排
说明:本文所有业务数据均为脱敏示意(保留量级与量级趋势);技能名、版本号、内部工具名、内部域名均已泛化,文中无任何内部接口号与内部 ID 枚举。
引子:一次「空转 12 分钟没回答」的线上事故
9 月 15 日早上 7:02,一位员工向线上 AI 助手提问:
「9.7–9.14 的数据里,为什么只有 2 人通过认证?有没有新增的实名和人脸?」
助手没有回答出来。它在后台"空转"了 12 分 20 秒,最后被系统强制中断,用户什么都没等到。
这不是"助手答不出",而是它为了找答案,自己写脚本、逐个查了 149 人的认证状态,循环了 350 步还没跑完,触达平台硬性上限被掐断(trace 时间跨度 07:02:41 → 07:14:53)。
处理过程是一段典型的「写脚本 → 跑 → 看结果 → 觉得不对 → 换一种写法再跑」循环,其中三步特别耗时,合计约 8 分半,占了 12 分钟的主体:
| 环节 | 助手做了什么 | 耗时 | 结果 |
|---|---|---|---|
| 漏斗分析脚本 | 按名单计算"呼叫 → 认证 → 转化"的漏斗 | 约 4 分 37 秒 | 某口径下结果全为 0,口径对不上提问,白跑 |
| 拉取列表脚本 | 拉取名单数据列表继续分析 | 约 2 分钟 | 执行到一半被系统杀掉(内存超限,错误码 137) |
| 逐人查询脚本 | 遍历 149 人,逐个查状态 | 约 1 分 57 秒 | 149 人中 70 人查不到结果 |
为什么一次普通提问会拖成 12 分钟?四个原因叠加:
- 缺少"一条批量查询"的能力(最主要)——状态只能一个个查,如同核对几百人的名单却没有"直接拉一张表"的办法;
- 统计口径没有先跟用户确认——按人、按组、按时间窗?助手猜着把几套口径都查了一遍,工作量成倍放大;
- 数据不全刺激反复重试——70 人查不到,越查越觉得"不对",陷入"查 → 不对 → 再查"的循环;
- 缺少"刹车"——没有"到多少步必须给阶段性结论"的限制,只能一路跑到死。
全程数据:29 次模型生成、28 次工具调用、411 个观测;工具运行合计约 530 秒,占 739 秒总耗时的约 72%;最后一次模型生成已经规划好第 29 次工具调用,还没执行就被系统掐断——整个任务就是"循环到被系统掐死"。
这个案例,正是我们这次"线上 Agent 运行时体检"的起因。同一时期,用户反复反馈:「最新模型升级后,问答变慢了,总是服务开小差」。于是我们基于线上全量 trace,对两个销售线索类技能做了一次系统性的体检。体检只回答一个问题:
到底是不是模型升级把线上 Agent 变慢了?
先说方法论:先定义指标契约,再谈数据
Agent 场景的"耗时""错误率"有多种算法,口径不写死就无法比较。这次我们先做好两件事:定义指标契约、声明数据质量,再动手拉数据。
采样窗口与样本
- 主窗口:9/10(周四)、9/11(周五)、9/14(周一),上海自然日全天;补充 9/15 全天、9/16(截至 11:00,部分日)。
- 抽样:每天每技能分层抽 20 条拉明细(共 120 条),分层口径 ok 50% / 中断 30% / 其它补齐,seed=42,可复算。
- 全量:窗口内所有 trace 与所有 ERROR observation 做全量统计,不只看抽样。
指标契约(先定义,后采集):
| 指标 | 定义 | 单位 | 数据来源 |
|---|---|---|---|
| 用户感知耗时 | 单条 trace 墙钟(含全部编排与模型) | 秒 | trace 列表接口 |
| 单次生成耗时 | 单次模型调用的墙钟 | 秒 | 明细接口抽样 |
| 首 token(TTFT) | timeToFirstToken | 秒 | 明细接口抽样 |
| 模型 / 工具调用次数 | trace output 内的线程级计数 | 次 | 列表接口(全量可得) |
| 空窗(静默) | 一轮内最大无输出间隔 | 毫秒 | 评分接口 |
| 中断率 | (client_abort + hard_cancel) / 已评分 trace | — | 评分接口 |
| 硬失败 | 该 trace 下存在 ERROR 级 observation | 条 | 异常接口(按天全量翻页) |
数据质量与缺口(先声明哪些"算不准",再下结论):
| 项 | 状态 | 说明 |
|---|---|---|
| 全量 trace 耗时 / 结果 / 调用次数 | ✅ 三天可比 | 列表接口字段完整 |
| 明细(observation 级) | ✅ 抽样 120 条 | 每天每技能 20 条 |
| 成本 | ❌ 不可用 | 计价字段全为 0,未配置计价 |
| 明细上限 | ⚠️ 有 2 条无法导出 | 单条 observation 达 86MB / 81MB,超接口 80MB 上限(本身即"跑飞"证据) |
| 补充日 9/16 | ⚠️ 部分日 | 截至 11:00,仅作趋势参考 |
| 终轮正文缺失率 | ⚠️ 口径受限 | 明细只有消息快照,缺尾会误判,不作为结论指标 |
方法论上值得强调两点:一是口径先行——"错误率""耗时"在 Agent 场景必须先写死算法,否则跨日不可比;二是全量 + 分层抽样双轨——全量看趋势与尾部,抽样看明细与根因,互相印证。
关键发现一:模型本身没变慢
模型确实换版了:窗口内从旧模型切换到灰度新模型(9/11 起灰度,9/14 全量)。但把单次模型调用拆开看:
- 单次生成 p50:线索漏斗查询 5.35s → 5.27s,商户查询 4.73s → 4.61s;
- 首 token(TTFT)p50:0.567s → 0.52s,p95:1.103s → 0.841s。
9/11 是双模型共存日,可以做同源同日 A/B(同一天、同一批任务、同一个技能,只有模型不同):
| 技能 | 模型 | 生成次数 | 单次生成 p50 | p95 |
|---|---|---|---|---|
| 线索漏斗查询 | 旧模型 | 214 | 5.67s | 30.27s |
| 线索漏斗查询 | 新模型(灰度) | 46 | 4.57s | 21.77s |
| 商户查询 | 旧模型 | 254 | 5.60s | 25.94s |
| 商户查询 | 新模型(灰度) | 27 | 3.50s | 16.16s |
结论很干净:新模型的单次生成与首 token 都更快,「模型升级导致推理变慢」是伪命题。(以上数据均已脱敏示意,保留量级。)
那用户感受到的"变慢"是什么?看端到端数据就明白了。
关键发现二:慢在编排与工具,不在模型
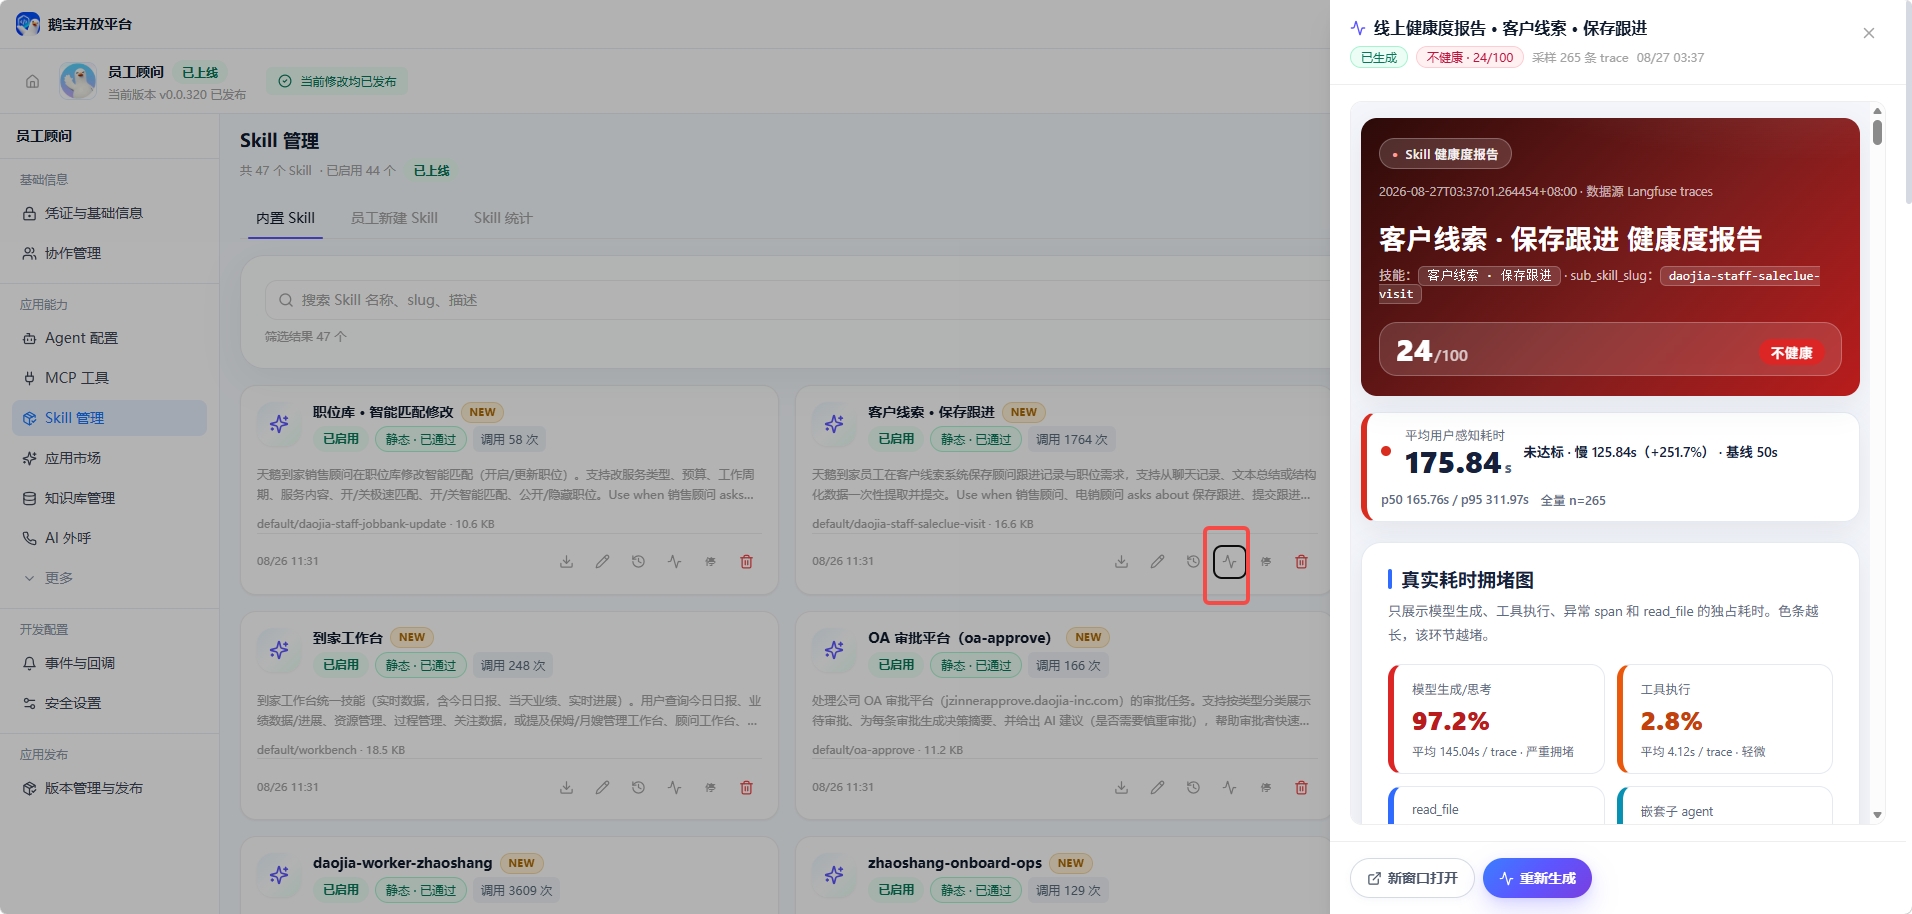
用户感知耗时(单条 trace 墙钟,秒;数据已脱敏示意):
| 技能 | 日期 | n | mean | p50 | p90 | p95 | max |
|---|---|---|---|---|---|---|---|
| 线索漏斗查询 | 9/10 | 567 | 219.7 | 145.3 | 427.5 | 614.5 | 3576.5 |
| 线索漏斗查询 | 9/11 | 747 | 227.2 | 141.4 | 514.8 | 736.9 | 3030.6 |
| 线索漏斗查询 | 9/14 | 623 | 216.4 | 144.4 | 406.6 | 583.1 | 5215.6 |
| 线索漏斗查询 | 9/15 补充 | 606 | 232.6 | 153.3 | 495.4 | 798.7 | 2003.3 |
| 商户查询 | 9/10 | 66 | 212.2 | 148.3 | 437.8 | 509.3 | 911.1 |
| 商户查询 | 9/11 | 73 | 247.2 | 155.5 | 524.0 | 765.3 | 2162.8 |
| 商户查询 | 9/14 | 41 | 149.5 | 116.8 | 286.7 | 420.9 | 716.3 |
三天里端到端 p50 基本持平(145s / 141s / 144s),没有"越升越慢"的趋势——问题不在变慢曲线,而在绝对值:一次问答中位数要等 2 分半,p95 要等 11 分钟。这不是模型升级引入的,是一直存在的结构问题。
慢在哪?先看一次对话的"工作量":
- 平均一轮对话 14~16 次模型调用 + 20~23 次工具调用、183~237 个 observation;
- 单次工具调用 ≥60s 的,每天 / 每 20 条样本里就有 9~14 次,最长的一次子代理任务 712s,沙箱脚本执行打满 300s 超时。
时间去向拆解(抽样 60 条,独占耗时占比):
| 技能 | 日期 | 模型生成 | 工具执行 | 编排链路 | 异常 span | read_file |
|---|---|---|---|---|---|---|
| 线索漏斗查询 | 9/10 | 50.0% | 47.1% | 2.9% | 0.0% | 0.04% |
| 线索漏斗查询 | 9/11 | 50.5% | 35.6% | 13.9% | 0.0% | 0.06% |
| 线索漏斗查询 | 9/14 | 54.5% | 35.6% | 7.0% | 2.8% | 0.12% |
| 商户查询 | 9/10 | 61.0% | 14.4% | 24.5% | 0.0% | 0.10% |
| 商户查询 | 9/11 | 56.4% | 16.3% | 27.3% | 0.0% | 0.06% |
| 商户查询 | 9/14 | 55.4% | 36.8% | 7.2% | 0.6% | 0.05% |
工具调用排行进一步说明问题(3 天抽样 60 条合计,线索漏斗查询技能工具调用合计 1,191 次):
| 工具 | 次数 | 次/trace | 总耗时(s) | 耗时占比 |
|---|---|---|---|---|
| read_file | 475 | 7.9 | 10.4 | 0.1% |
| execute(沙箱脚本) | 332 | 5.5 | 5,481.1 | 75.9% |
| 合作方接口调用 | 118 | 2.0 | 88.4 | 1.2% |
| 内部 HTTP 读取 | 73 | 1.2 | 80.6 | 1.1% |
| 内部 HTTP 写入 | 60 | 1.0 | 35.3 | 0.5% |
| task(子代理) | 10 | 0.2 | 1,481.3 | 20.5% |
商户查询技能工具调用合计 1,392 次:execute 占 35.2%、task(子代理)占 52.6%——执行类工具(沙箱脚本 + 子代理)合计占工具耗时的 90% 以上。
注意 read_file:每条 trace 平均要读 8 次左右技能文档,但耗时几乎为 0——它是"上下文噪音",不是慢因;真正慢的是 Agent 在沙箱里写脚本跑查询、起子代理干杂活。
再看复杂度的分布:中位数三天没变(线索漏斗查询模型调用 p50 为 13/12/13),变的是尾部——9/14 起 p95 模型调用 43.6 → 76.8、工具调用 135.6 → 279.4,单 trace 工具调用 ≥300 次的占比从 2.6% 升到 4.3%(商户查询 4.5% → 9.8%)。一句话概括:
多数对话的复杂度没有变,但少数对话在"跑飞"。
关键发现三:「0% 错误率」是假象
平台侧的 trace 结果登记只认三种取值:ok / client_abort / hard_cancel。而流式架构下异常往往被兜底吞掉——兜底文案机制会下发一条「服务开小差了,请稍后重试」来完成这一轮,于是这一轮在平台侧仍被记为 ok。抽样里就有多例"递归越界"的 trace,结果却标着 ok。
也就是说:自动回复 ≠ 用户可感知的正确完成。看板上的"错误率 0%"只是"流没断"的证据,不是"答对了"的证据。
要摸真实健康度,得看 ERROR observation 全量扫描(窗口内两个技能"至少有 1 个 ERROR observation"的 trace 占比):
- 线索漏斗查询:4.8% → 6.0% → 13.8%(9/15 进一步升到 18.5%);
- 商户查询:1.5% → 6.8% → 9.8%(9/15 升到 17.5%)。
「服务开小差」的主要对应事件很明确:图执行递归上限 350 触顶。窗口内线索漏斗查询出现该事件的 trace 数 22 → 28 → 70 → 62,占当天 3.9% → 3.7% → 11.2% → 10.2%;商户查询 1 → 2 → 4 → 7。机制是:模型一旦陷入多轮循环,先撞上递归上限 350,图执行抛错、流中断,用户拿到兜底文案「服务开小差了,请稍后重试」。
和"慢"互相放大的还有静默窗与放弃率:
- 一轮对话内最大静默 p50 约 25~26s,p95 169~300s;
- 中断率(client_abort)常年偏高:线索漏斗查询 61%~74%,商户查询 39%~64%;补充日中断率 73.8%,全窗口最高。
用户等不到结果就走了——静默窗是「卡住了 / 开小差」体感的第一放大器。
模型归因:同源同日 A/B,别急着定罪
新模型上线与失败率上升在时间上重合,但能说"新模型导致跑飞"吗?我们用 9/11 双模型共存日做了一次干净对照:同一天、同一技能、同一批线上任务,只有模型不同。
- 递归越界 trace 中:新模型占 39%(11/28);
- 同时段随机对照样本中:新模型只占 17.5%(7/40);
- 折算下来,新模型侧的越界率约为旧模型的 2.9 倍。
但这只能算"强嫌疑",不能定论:事件只有 28 条、对照 40 条,样本量小;而且 9/14 同时上线了技能新版本(版本号示意 v0.0.x),9/15 又连发多版、9/16 收敛后异常随之回落——模型与技能版本同时变更,线上数据无法单独分离因果。要定论必须做受控 A/B:锁模型、跑同一批任务。
这条方法论值得单独拎出来:做模型归因,要排除环境干扰。跨天比较天然混入版本变更、流量差异、灰度比例变化;只有"同源同日共存"才是干净的对照。样本不够时,如实标注"强嫌疑、非定论",比拍脑袋下结论诚实得多。
「代理化信号」:判断 Agent 是否在"当人肉接口工程师"
整套分析指向一个判断:这两个技能在反复做"接口拼装与编排"的脏活——自己 read_file 读规范、execute 写脚本拼查询、起子代理多轮规划校验、用 HTTP 工具一个个打接口。轮次越多,越慢,也越容易撞上限。
我们沉淀了一张 7 条「代理化信号」决策清单,命中满 3 条就该把链路下沉成 Agent-facing proxy:
| # | 信号 | 本次是否命中 |
|---|---|---|
| 1 | 一次任务要调 3 个以上接口 | ✅ 命中(约 20~23 次/trace) |
| 2 | 依赖内部 ID / 枚举(资源编号、城市 / 品类编码、接口号等) | ✅ 命中 |
| 3 | 需要读写后复核(写回跟进、认领需回查) | ✅ 命中 |
| 4 | 状态机复杂(线索状态、认领 / 跟进等多状态流转) | ✅ 命中 |
| 5 | 输出要卡片 / 结构化组件(markdown 表格、CSV、附文件) | ✅ 命中 |
| 6 | 技能正文过长,需 read_file 反复读 | ✅ 命中(7.9~8.3 次/trace) |
| 7 | 长流程失败率高 | ✅ 命中(递归越界 9/14 起 10%+ trace) |
结论:7 条全中。这类技能绝不该继续往 skill 文档里加规则,该做的是架构层面的下沉。
问题归因同样可以归成四类,处理方向各不相同:
| 类型 | 证据 | 处理方向 |
|---|---|---|
| 对话理解失败 | 非主因(抽样中追问不足 10 次) | 非主因 |
| 接口拼装失败 | 入参校验错每天 6 条 trace 量级;execute 占工具耗时 75.9%;read_file 反复读规范 | 下沉 proxy |
| 状态判断失败 | 每轮 14~16 次模型调用;递归越界 350 步是"多轮规划 / 校验空转"的极端形态 | proxy 输出 scene/status,打断空转 |
| 系统能力失败 | token 额度耗尽、LLM 协议错、单 trace 86MB 超接口上限 | proxy 归因 + 平台修流中断兜底 |
结论:让 Agent 做业务助理,别让 Agent 做接口工程师
两句话总结这次体检:
「变慢」不是模型升级造成的:单次生成与首 token 都更快,端到端 p50 三天持平。用户感到的慢,是「一轮对话 14~16 次模型调用 × 5s + 20 次以上工具调用(沙箱脚本动辄 60~300s)」的乘加结果。 「服务开小差」主要是跑飞:模型在少数会话里陷入多轮循环,撞上递归上限 350,流中断,前端拿到兜底文案。这类失败从 9/14 起明显变多。
两个抱怨是同一个病根:Agent 被当成接口工程师用。修复方向是对齐的——「Proxy 化下沉」:
- 把"查询编排"做成 Agent-facing proxy:入参只收用户语义字段(城市、品类、时间窗、姓名 / 手机号、对比对象),禁止让 Agent 传内部 ID、接口号、token;出参分层:scene / status / missingSlots(控制层)、displaySummary(可对用户说)、contextId(只读内部);
- 编排、分页、聚合、脱敏、表格拼装全部放 proxy(现在这些是 Agent 用 execute 在沙箱里写 Python 做的);
- 目标:一次问答的接口调用从 20~23 次降到 3~5 次,单轮墙钟 p50 从约 145s 降到 60s 以内量级。
配套的还有:把模型调用上限做成每轮硬门禁并优雅收尾(在撞递归上限之前停下,给出"已尽力 + 当前进展 + 建议缩小范围")、同轮重复工具调用检测、execute 单轮时长预算与输出截断、流中断兜底区分「超时 / 额度 / 上游 / 跑飞」四类并给出可行动建议、上下文瘦身(单轮 prompt p50 从中位 10 万 token 降到 3 万以内,顺带消掉 token 额度耗尽)。验收标准(数据已脱敏示意):
| 指标 | 现状 | 目标 |
|---|---|---|
| 用户感知耗时 p50 | 145s / 148s | ≤ 60s |
| 用户感知耗时 p95 | 615s / 509s | ≤ 180s |
| 单轮工具调用次数 | 19.9~23.2 次/trace | 3~5 次 |
| 递归越界 trace 占比 | 9/14 后 10%+ | ≤ 1% |
| 中断率 | 61%~74% | ≤ 20% |
| 一轮内最大静默 p50 | 25s | ≤ 8s |
| 单轮 prompt tokens p50 | 10 万 | ≤ 3 万 |
结尾:执行纪律加固——不改业务脚本,只改 SKILL.md
架构下沉是根治,但远水救不了近火。同期我们对另一个高耗时技能做了「执行纪律加固」型优化,是一个可以立刻落地的近火方案:
不改变任何业务规则、接口与脚本(脚本与接口文档文件字节级一致,MD5 相同),只对 SKILL.md 增加防空转 / 防死循环 / 路径与读取纪律。
为什么需要它?线上数据同样触目惊心(数据已脱敏示意):平均用户感知耗时 238.7s(基线 50s,+377%),p95 933.6s,中断率 5.7%;LLM 轮次 p95 ≈ 29 轮 / 条,执行工具调用 559~664 次(占工具耗时 96%+);最慢两条 trace(1422s / 827s)都是递归上限掐断的空转循环;大量 read_file 打空(File not found)源于模型去猜测"版本化部署路径"失败,与真实技能目录不符。
SKILL.md 新增的强制纪律包括(业务脚本零改动):
- 无进展即停:连续 3 轮工具调用无新信息即停止;单任务模型轮次 > 30 仍未完成即停止并告知用户(防空转撞递归上限 350 轮);
- 路径只读本目录:只读本技能目录;禁止读取 / 猜测版本化部署路径;禁止全盘遍历;
- 同文件只读一次:读取缓存、同一文件本轮只读一次(read_file 目标 ≤ 2 次 / 任务);
- 失败最多重试 1 次:失败最多原样重试 1 次,禁止换参试错;
- 接口只走技能文档与脚本目录,禁止现场临时脚本探测;规划一次到位,不在对话层重复编排。
上线目标(数据已脱敏示意):平均用户感知耗时 ≤ 120s(基线 238.7s)、latency p95 ≤ 300s → 180s、read_file 次数 / 任务 ≤ 2、LLM 轮次 p95 ≤ 20、中断率 ≤ 3%、递归上限空转 trace 归零(新增监控)。回归验证包含冒烟用例与历史场景回归,确认业务链路零影响。
要诚实说明风险:执行纪律对模型是「软约束」,依赖模型遵循度,极端个案仍可能超时——所以建议平台侧同步调低递归上限或增加图级最大迭代做硬兜底。
回头看开头那个空转 12 分钟的案例:
- 在 SKILL.md 层补上"无进展即停、失败只重试 1 次"——是第一道闸;
- 平台侧把「递归上限」升级为「业务级轮次预算 + 强制收尾」——是第二道闸;
- 把批量查询能力下沉成 proxy——是根治。
让 Agent 做业务助理,别让 Agent 做接口工程师。 一次基于 trace 的运行时体检能帮你弄清楚:当用户说"变慢了"的时候,慢的到底是模型,还是你的编排。