用 Langfuse 做生产 LLM 应用的错误分析:从事件归一化、Skill 归因到 P0 修复
导读:这篇文章给出用 Langfuse 对生产 LLM 应用做错误分析的六步闭环:事件归一化 → Skill 归因 → 根因分类矩阵 → 时间趋势对照发布 → 僵尸会话/重复请求去重 → P0/P1/P2 分级修复。几个关键量级值得记住:同一失败会在多个观测上重复呈现约 2.9 倍、单条僵尸会话可占 48 小时失败总量近一半、框架级缺陷(思考模式字段未回传)约占失败四成五。适合做 LLM 应用线上故障排查与可观测性建设的后端/SRE 工程师,方法可直接复制。
分类:AI评测 | 标签:LLM、可观测性、Langfuse、错误分析
生产环境的 LLM 应用和 Demo 最大的区别是:它会把所有"没想到"都变成线上报错暴露出来。对话上下文越拖越长、工具返回格式漂移、模型通道配额烧完、内容风控误拦截——这些问题在本地跑十个用例时永远不会出现,一旦上了生产,就会以 trace、span、error 的形式堆满可观测平台。可观测平台(本文以开源项目 Langfuse 为例,github.com/langfuse/langfuse)只负责把数据存下来,真正有价值的是"怎么把一堆原始观测变成一份能拍板修哪里的报告"。
这篇文章把我们在自建 Langfuse 实例上,对自研 LLM 应用做生产错误分析的方法整理成一条六步闭环:事件归一化 → Skill/模块归因 → 根因分类矩阵 → 时间趋势与发布相关性 → 僵尸会话/重复请求放大识别 → P0/P1/P2 分级修复。文末附带脱敏后的数据示例与踩坑清单。文中所有指标数字均保留量级、仅为脱敏示意,不代表任何真实线上数据。
为什么需要生产错误分析
不做错误分析之前,我们的直觉是"看日志看告警就够了",实际跑了一轮发现有三件事传统手段给不了:
- 错误不在你以为的地方。 大量失败不是代码异常,而是协议拼装缺陷(思考模式字段未回传)、内容风控拦截、平台配额耗尽——这些错误不会抛异常、不进应用日志,只出现在模型调用链路的返回体里。只有完整的 Trace 才能把它们捞出来。
- 一次失败会重复呈现。 同一个失败会在 GENERATION、SPAN 等多个观测上重复出现,实测"重复呈现比"约 2.9 倍。直接数 ERROR 会把问题量级放大约 3 倍,告警阈值、人力排期全都会偏。
- 量级 ≠ 根因权重。 错误最多的 skill 不一定是代码最烂的 skill,可能是僵尸会话在反复重试、可能是平台配额在拖累所有 skill。量级只告诉你"去哪看",归因和分类才告诉你"改什么"。
一、分析流水线(六步)
第一步:事件归一化——把 spans/events 归一成可统计的事件类型
Langfuse 的观测模型里,一次模型调用失败会同时体现在 GENERATION、SPAN 等多个观测上,实测"ERROR 观测 / 失败事件"比值约为 2.88,即有约 190% 的重复呈现。如果不做归一化直接数原始 ERROR,问题量级会被放大约 3 倍。
做法:
- 定义一个标准化失败事件(示例口径:
type=EVENT / level=ERROR / name=model_call_failed),约定"一次失败 ≈ 一条事件",把它作为统计主口径; - ERROR 观测总量只作量级参考,不进入任何对比或占比计算;
- 主口径要选最稳定的一条链路。我们遇到的平台限制是:接口不支持按状态过滤、旧观测端点在部分时段服务端超时,所以选标准化事件而不是状态查询——并在报告开头写明"统计口径",否则别人拿到报告不知道该信哪个数。
这一步的直接产出是一句话:"48 小时内有 1262 条失败事件"而不是"有 3628 条 ERROR"——前者才是可以拿来做结论的量。
第二步:Skill/模块归因——哪个能力单元在错
自研 LLM 应用由多个能力单元(Skill)组成:业务 Skill(如员工咨询场景、生活服务场景)、子智能体(subagent 根节点)、公共工具(HTTP 调用工具、卡片消息工具)、场景入口。分析要让每条错误事件能回答"是哪个单元错的"。
工程上就是在事件写入时把归因信息塞进 metadata(示例字段:skill_attrs_json),分析时按 skill 聚合,14 天窗口得到这样的排行(脱敏示意):Top1 业务 Skill 出错 1024 次,占归因事件的约 45%;业务域各包合计约 1100 次;两个公共 HTTP 工具 285 次。这张排行表就是"该去催谁修"的直接依据。
两个必须同时记录的度量:
- 信号 Trace:根因不在噪声列表的 Trace(
is_signal_root_cause),代表真实问题; - 唯一 Trace:去重后的 Trace(同一 Trace 可能带多条 ERROR)。
两者差距越大,说明单条会话内重复报错越多——这正是隐患(见第五步僵尸会话)。
第三步:根因分类矩阵——错误类型 × 环节
把报错消息聚类成"错误模式",再归到"环节",形成错误类型 × 环节的根因矩阵。从近 14 天的全量数据(4746 条)提炼出的模式与环节对应关系如下(脱敏示意):
| 错误模式 | 典型文案 | 环节 |
|---|---|---|
| 思考模式字段未回传(400) | reasoning_content must be passed back | 模型层 · 协议/拼装 |
| 内容风控拦截(400) | Content Exists Risk | 模型层 · 内容安全 |
| 上下文超长(400) | maximum context length is 1048576 tokens | 模型层 · 输入超限 |
| 工具消息错序(400) | role='tool' must follow tool_calls | 编排层 · 消息拼装 |
| 鉴权失败(401) | 401 Unauthorized(调度/平台接口) | 平台层 · 鉴权 |
| 配额超限(429) | insufficient_quota | 平台层 · 配额 |
| 限流(429) | Throttling.BurstRate | 平台层 · 限流 |
| 工具入参校验失败(422/400) | body 需为合法字典 | 工具层 · 参数拼装 |
| 业务 HTTP 连接失败 | ConnectError | 工具层/网络层 |
| 流式超时 | StreamChunkTimeout(120s 无分片) | 网络层 · 超时 |
先归到"环节"再往下定位到具体代码,比直接看文案高效得多:模型层/平台层的问题多半是公共封装与运维,工具层是公共工具缺陷,编排层和业务层才轮到具体 skill 的负责人。
第四步:时间趋势与发布相关性——凡峰值必对照发布
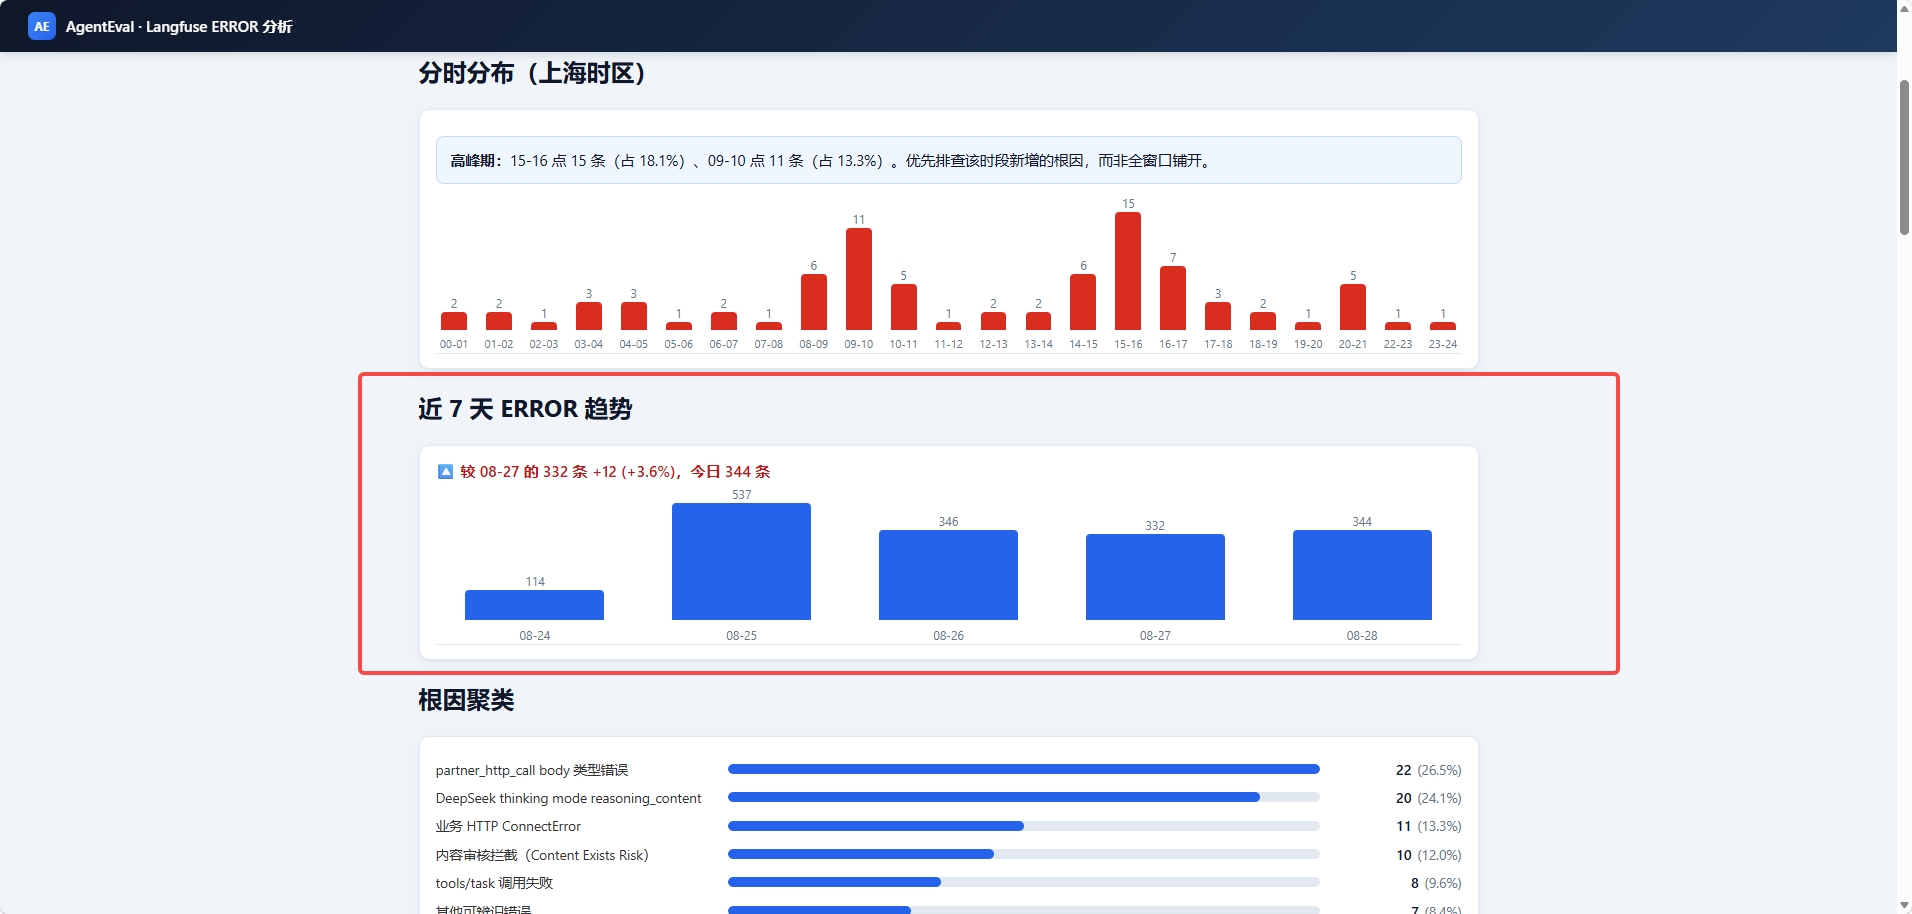
按小时画失败曲线,重点读三类信号:
- 工作时段持续存在——与真实用户流量相关,问题真实存在,值得长期投入;
- 单小时爆发且波及其他 skill——平台级事件,不是任何 skill 的代码问题;
- 错误集中在某段小时窗口——对照发布记录,疑似发布瞬时回归。
我们遇到的实例:
- 某一小时内失败量占 48 小时总量的近三成(约 374/1262),且该小时内"配额超限"类错误 100% 集中于此、所有 skill 同时失败——这是平台级配额耗尽,正确动作不是改某个 skill,而是检查云上模型通道的配额/余额、加告警、做熔断降级;
- 工具消息错序类错误集中出现在某天凌晨 05:00~07:00 两小时内(前后两段各 10+、24 条)——反向核对当日发布记录即可确认回归面;
- 版本维度:Top skill 的错误跨多个发布版本持续存在,说明不是单一版本回归;但当时没有按版本的流量分母,错误率算不出来,需要补流量统计后再对比。
第五步:僵尸会话/重复请求放大——去重口径
错误分析最常见的假阳性是:某次小概率失败被客户端/框架自动重试,或者某条测试会话疯狂打接口,把错误数放大成"看起来是系统性问题"。
实测放大案例(脱敏示意):单条会话在 34 小时内产生 625 条失败事件,占 48 小时失败总量的近一半(49.5%),输入消息累计最长近 3000 条。如果不按会话去重,你会误判为"系统性问题全面爆发",实际是一条僵尸会话在打转,把配额和日志一起打爆。
去重口径必须两套同时算:
- 按
request_id去重 → "受影响独立请求数"; - 按
thread_id去重 → "受影响会话数";
再单独标记超长/高频会话进排查清单(如 48 小时窗口:受影响请求 619、受影响会话 167——比值约为 3.7,说明平均每条会话内有多轮失败)。
第六步:P0/P1/P2 分级修复建议
把根因映射到责任面和优先级,每条建议都带验收口径。
- P0(立即处理):持续产生大量失败或会导致全量瘫痪的问题。例如:
- 框架层:思考模式多轮协议缺陷——消息组装/持久化层未回传
reasoning_content,导致使用思考模型的会话从第 2 轮起持续 400(该模式约占失败事件 45%); - 平台层:模型通道配额耗尽——提升配额/余额,加配额与限流告警,配额耗尽时熔断降级(切换备用模型/通道),避免单小时全量瘫痪;
- 稳定性:模型调用失败设重试硬上限 + 指数退避,检测"连续 N 次失败仍继续"并熔断转人工,堵住单会话数百次的僵尸循环。
- 框架层:思考模式多轮协议缺陷——消息组装/持久化层未回传
- P1(本周):影响面明确但非瘫痪。例如:内容风控拦截面的输入特征排查(输入预检/降敏);按 skill 补齐流量分母统计(请求量、成功率),让错误率与版本对比可算,而不只有绝对错误数。
- P2(排期):零散问题。例如:工具消息拼装修复;429/限流退避策略验证;网络读取异常加重试。
每条建议附验收口径(如"同一条多轮会话从第 2 轮起不再报 400"),否则"修没修好"无法判定。
二、口径与坑(去重、噪声、发布窗口)
去重:先归一事件,再按请求/会话去重
归一化解决"同一失败重复呈现"(ERROR 观测 ≈ 2.9 倍于失败事件),request_id / thread_id 去重解决"重试与僵尸会话放大"。三步缺一不可:量级看事件、广度看请求、聚集看会话。
噪声:把"无有效原因"的 ERROR 单独归类
近 14 天全量 4746 条事件中,"仅标记 ERROR(无有效原因)"一类高达 1541 条(约 32%)。它们没有 statusMessage、没有可辨识根因,必须单独归类而不是摊进任何根因。我们使用"信号/噪声"两分法:
- 信号(signal)= 根因不在噪声列表的事件(
is_signal_root_cause); - 归因 = 事件带 skill metadata,能落到某个能力单元;
- 噪声举例:enrich 噪声(如退款咨询场景里 9 次错误有一半是 enrich 环节噪声)、名称被截断的子智能体——启发式归因的展示问题,实际根因要归并到父级统计,避免一个真实问题被拆成几十条"未知"。
发布窗口:峰值先对照发布,再谈修复
错误在特定小时集中出现时,先查发布记录和变更单,再写修复单。否则很容易把平台级事件误判成"某个 skill 的问题",把运维问题修成业务问题。
渠道 / 节点分布:错误从哪个入口来
除 skill 维度外,还要按渠道(入口)和报错节点(observation)看分布。近 14 天渠道分布(脱敏示意):
| 渠道/入口 | 错误次数 |
|---|---|
| PC 网页端 | 2684 |
| 无渠道标记 | 969 |
| 定时调度 | 569 |
| 企业微信 | 249 |
| 通义入口 | 171 |
| 飞书 | 90 |
| 微信 | 9 |
| 飞书机器人 | 5 |
报错节点(observation 名称)分布(脱敏示意):自研 LLM 调用节点 964、model_call_failed 963、LangGraph 586、model 575、tools 537、业务类根节点 428、HTTP 调用工具 352、HTTP POST 工具 233、HTTP GET 工具 54、task 15、卡片消息工具 9。
渠道分布的价值:大部分错误来自 PC 端与定时调度;若某渠道错误占比异常(如调度端出现成片 401),应优先查该入口的鉴权链路而不是通用模型封装。
未归因事件的启示
14 天窗口 4746 条事件中,归因到 skill 的 2254 条、未归因 2492 条。未归因部分的主体是模型层错误(思考模式字段未回传、内容风控)——它们发生在 skill 归因之外,是平台层的公共 LLM 封装问题,而不是某个业务 skill 的逻辑问题。分析要分两条线随访:平台线(模型封装、通道稳定性)与业务线(具体 skill 的编排与工具逻辑)。
三、数据示例(脱敏示意)
以下数字保留原始量级,skill 名、会话 ID、版本号、时间戳均已替换,仅作方法示意。
示例一:48 小时主口径概览(脱敏示意)
| 指标 | 数值 |
|---|---|
| ERROR 观测总数(同一失败在 GENERATION/SPAN 重复呈现) | 约 3600(Day1 1600 / Day2 2000) |
| 标准化失败事件(model_call_failed,一次失败≈一条) | 1262 |
| ERROR 观测 / 失败事件 比值 | 2.88 |
| 受影响独立用户请求(request_id 去重) | 619 |
| 受影响会话(thread_id 去重) | 167 |
示例二:根因分解矩阵(48 小时,脱敏示意)
| 错误模式 | 数量 | 占比 | 受影响请求 | 主要环节 | 性质判断 |
|---|---|---|---|---|---|
| 思考模式字段未回传(400) | 571 | 45% | 365 | 模型层 · 协议/拼装 | 框架代码缺陷 |
| 内容风控拦截(400) | 390 | 31% | 384 | 模型层 · 内容安全 | 输入触发风控 |
| 配额超限(429) | 206 | 16% | 198 | 平台层 · 配额 | 全部集中 1 小时,平台级 |
| 限流(429) | 48 | 4% | 46 | 平台层 · 限流 | 水位偏高 |
| 工具消息错序(400) | 37 | 3% | 37 | 编排层 · 消息拼装 | 工具消息拼装缺陷 |
| 工具调用缺响应(400) | 4 | <1% | 4 | 编排层 · 消息拼装 | 同上 |
| 网络读取异常 | 2 | <1% | 2 | 网络层 | 偶发 |
示例三:Skill 排行(14 天,脱敏示意)
| 排名 | Skill(示例名) | 类型 | 次数 | 信号 Trace/唯一 Trace | 主要根因 |
|---|---|---|---|---|---|
| 1 | skill-a(员工咨询场景) | 业务 Skill | 1024 | 576/577 | 模型层 400(内容风控 + 字段未回传 + 鉴权) |
| 2 | 业务域根节点 | 子智能体 | 714 | 293/464 | 仅标记 ERROR + tools/task 失败 |
| 3 | HTTP POST 工具 | 公共工具 | 168 | 109/109 | 业务 HTTP 连接失败 |
| 4 | HTTP 调用工具 | 公共工具 | 117 | 93/93 | 入参 body 类型错误 |
| 5 | 业务主包 | 业务 Skill | 51 | 46/46 | tools/task 子智能体失败 |
| 6 | 服务履约交互子包 | 业务 Skill | 31 | 31/31 | tools/task 失败 |
| 7 | 服务预约场景 | 场景 | 20 | 13/20 | tools/task 失败 |
| 8 | 服务提供方根节点 | 子智能体 | 18 | 8/10 | 仅标记 ERROR |
| 9 | 订单类子包 | 业务 Skill | 11 | 10/11 | tools/task 失败 |
| 10 | 服务人员检索子包 | 业务 Skill | 11 | 10/11 | 初筛环节失败 |
按包汇总(脱敏示意):skill-a 约 1028 次 · 业务域(主包+子包+task 子智能体)约 1100 次 · 公共 HTTP 工具 285 次 · 场景/其他约 45 次。
示例四:僵尸会话放大(48 小时,脱敏示意)
| 会话(示意 ID) | 失败事件 | 请求数 | 时间跨度 | 输入消息量 | 主要错误 |
|---|---|---|---|---|---|
| thread_a | 625(约总量 50%) | 367 | 34 小时 | 数百~近 3000 条 | 内容风控 + 字段未回传 |
| thread_b | 94 | 30 | 约 6 小时 | — | 400 系列 |
| thread_c | 45 | 12 | 跨约 1.5 天 | — | 400 系列 |
示例五:高频报错文案(14 天,脱敏示意)
- 思考模式字段需回传(400):1014 次
- 内容风控 Content Exists Risk(400):712 次
- 入参应为合法字典(HTTP 工具):285 次
- 鉴权失败 401(调度/平台接口):254 次
- 上下文超长(1048576 token 超限):88 次
- 工具消息顺序错误(400):58 次
- 流式读取超时(120s 无分片):22 次
- 限流 429:27 次
四、小结
一套能闭环的生产错误分析,不是"打开 Langfuse 数一下 ERROR",而是一条可复用的流水线:
- 归一化——定义"一次失败 ≈ 一条事件"的标准口径,别被重复呈现的观测带偏(约 2.9 倍);
- 归因——让每条事件回答"哪个 skill 错的",聚合出排行榜(信号 Trace / 唯一 Trace 都统计);
- 分类——错误类型 × 环节的根因矩阵,先定层级再定位代码(模型层/平台层修公共封装,业务层才催具体负责人);
- 趋势——按小时/版本/发布窗口看时间规律,凡峰值先对照发布,区分业务流量、平台故障、发布回归;
- 去重——按 request_id/thread_id 去重,揪出僵尸会话(单会话可占一半总量),别被重试放大骗;
- 分级——根因映射到 P0/P1/P2,每条建议带验收口径。
这套方法在 48 小时窗口内定位到一个框架级缺陷(思考模式多轮协议未回传字段,约占失败的四成五)和一个平台级故障窗口(配额耗尽导致单小时全量失败爆发);在 14 天窗口内区分了模型层与业务层两类问题——前者该修公共封装与通道稳定性,后者才落到具体 skill 的编排与工具逻辑。有了口径和闭环,错误分析报告才能从"一堆截图"变成"一张能拍板修哪里的清单",也才能沉淀成下一次线上问题 10 分钟定位的底子。