分类标签归档:scrapy

爬取研究生招生网

编写yanzhao.py

爬取速度不要太快,尽量爬取你需要的分类

研招网还是很好爬取的,用谷歌浏览器查看浏览页面时的调用的接口,以及你要爬取的元素。

yanzhaoSpider

数据预览:
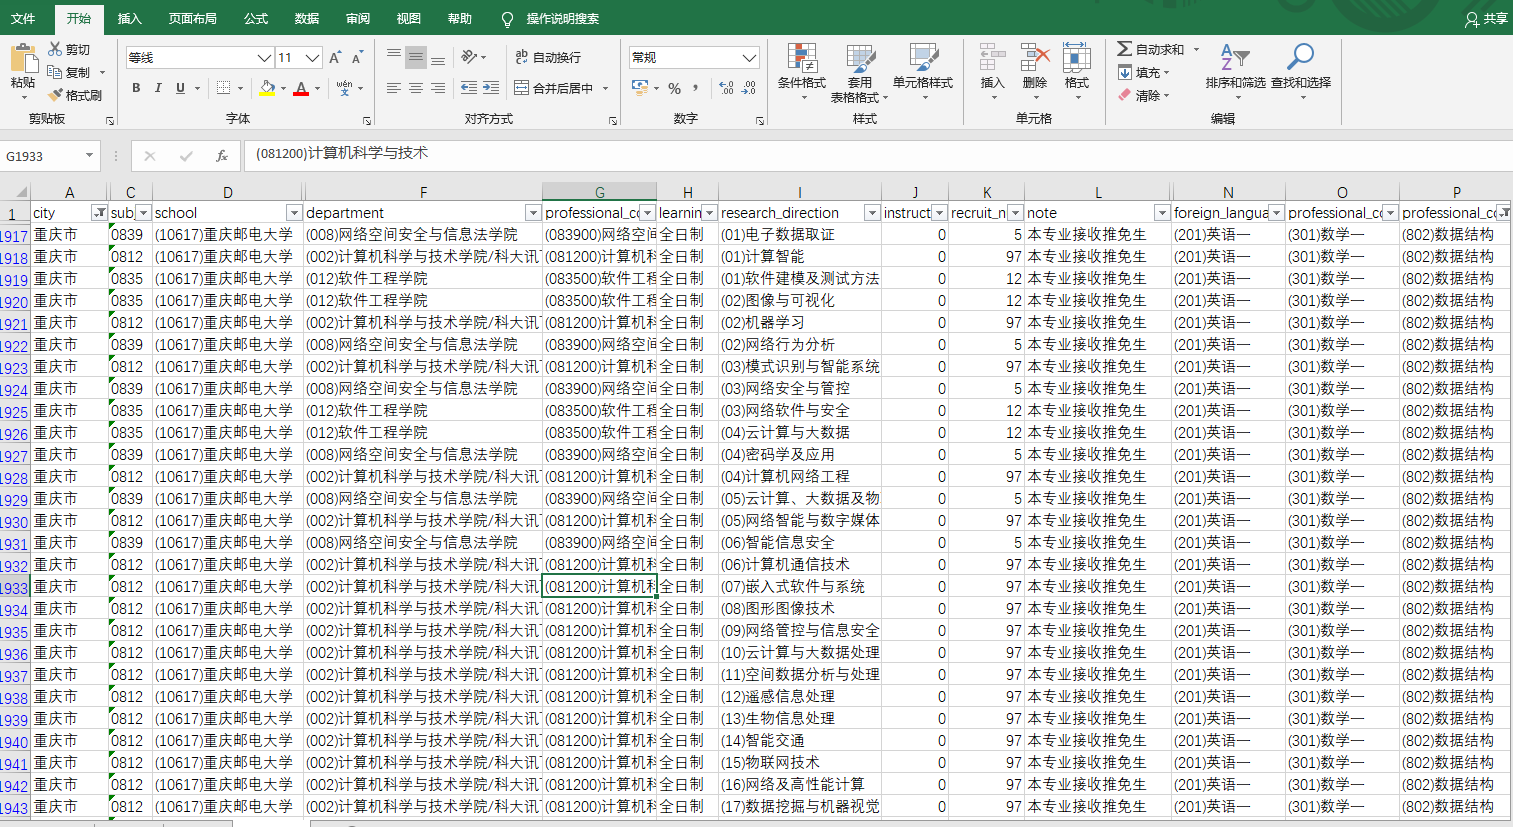
想要分析

  1. 专业招生人数
  2. 专业所考科目
  3. 学校城市

导包

# -*- coding: utf-8 -*-
import scrapy
from scrapy.http import Request
from urllib import parse
from yanzhaoSpider.utils.common import get_md5
from scrapy.http import FormRequ
阅读全文 →

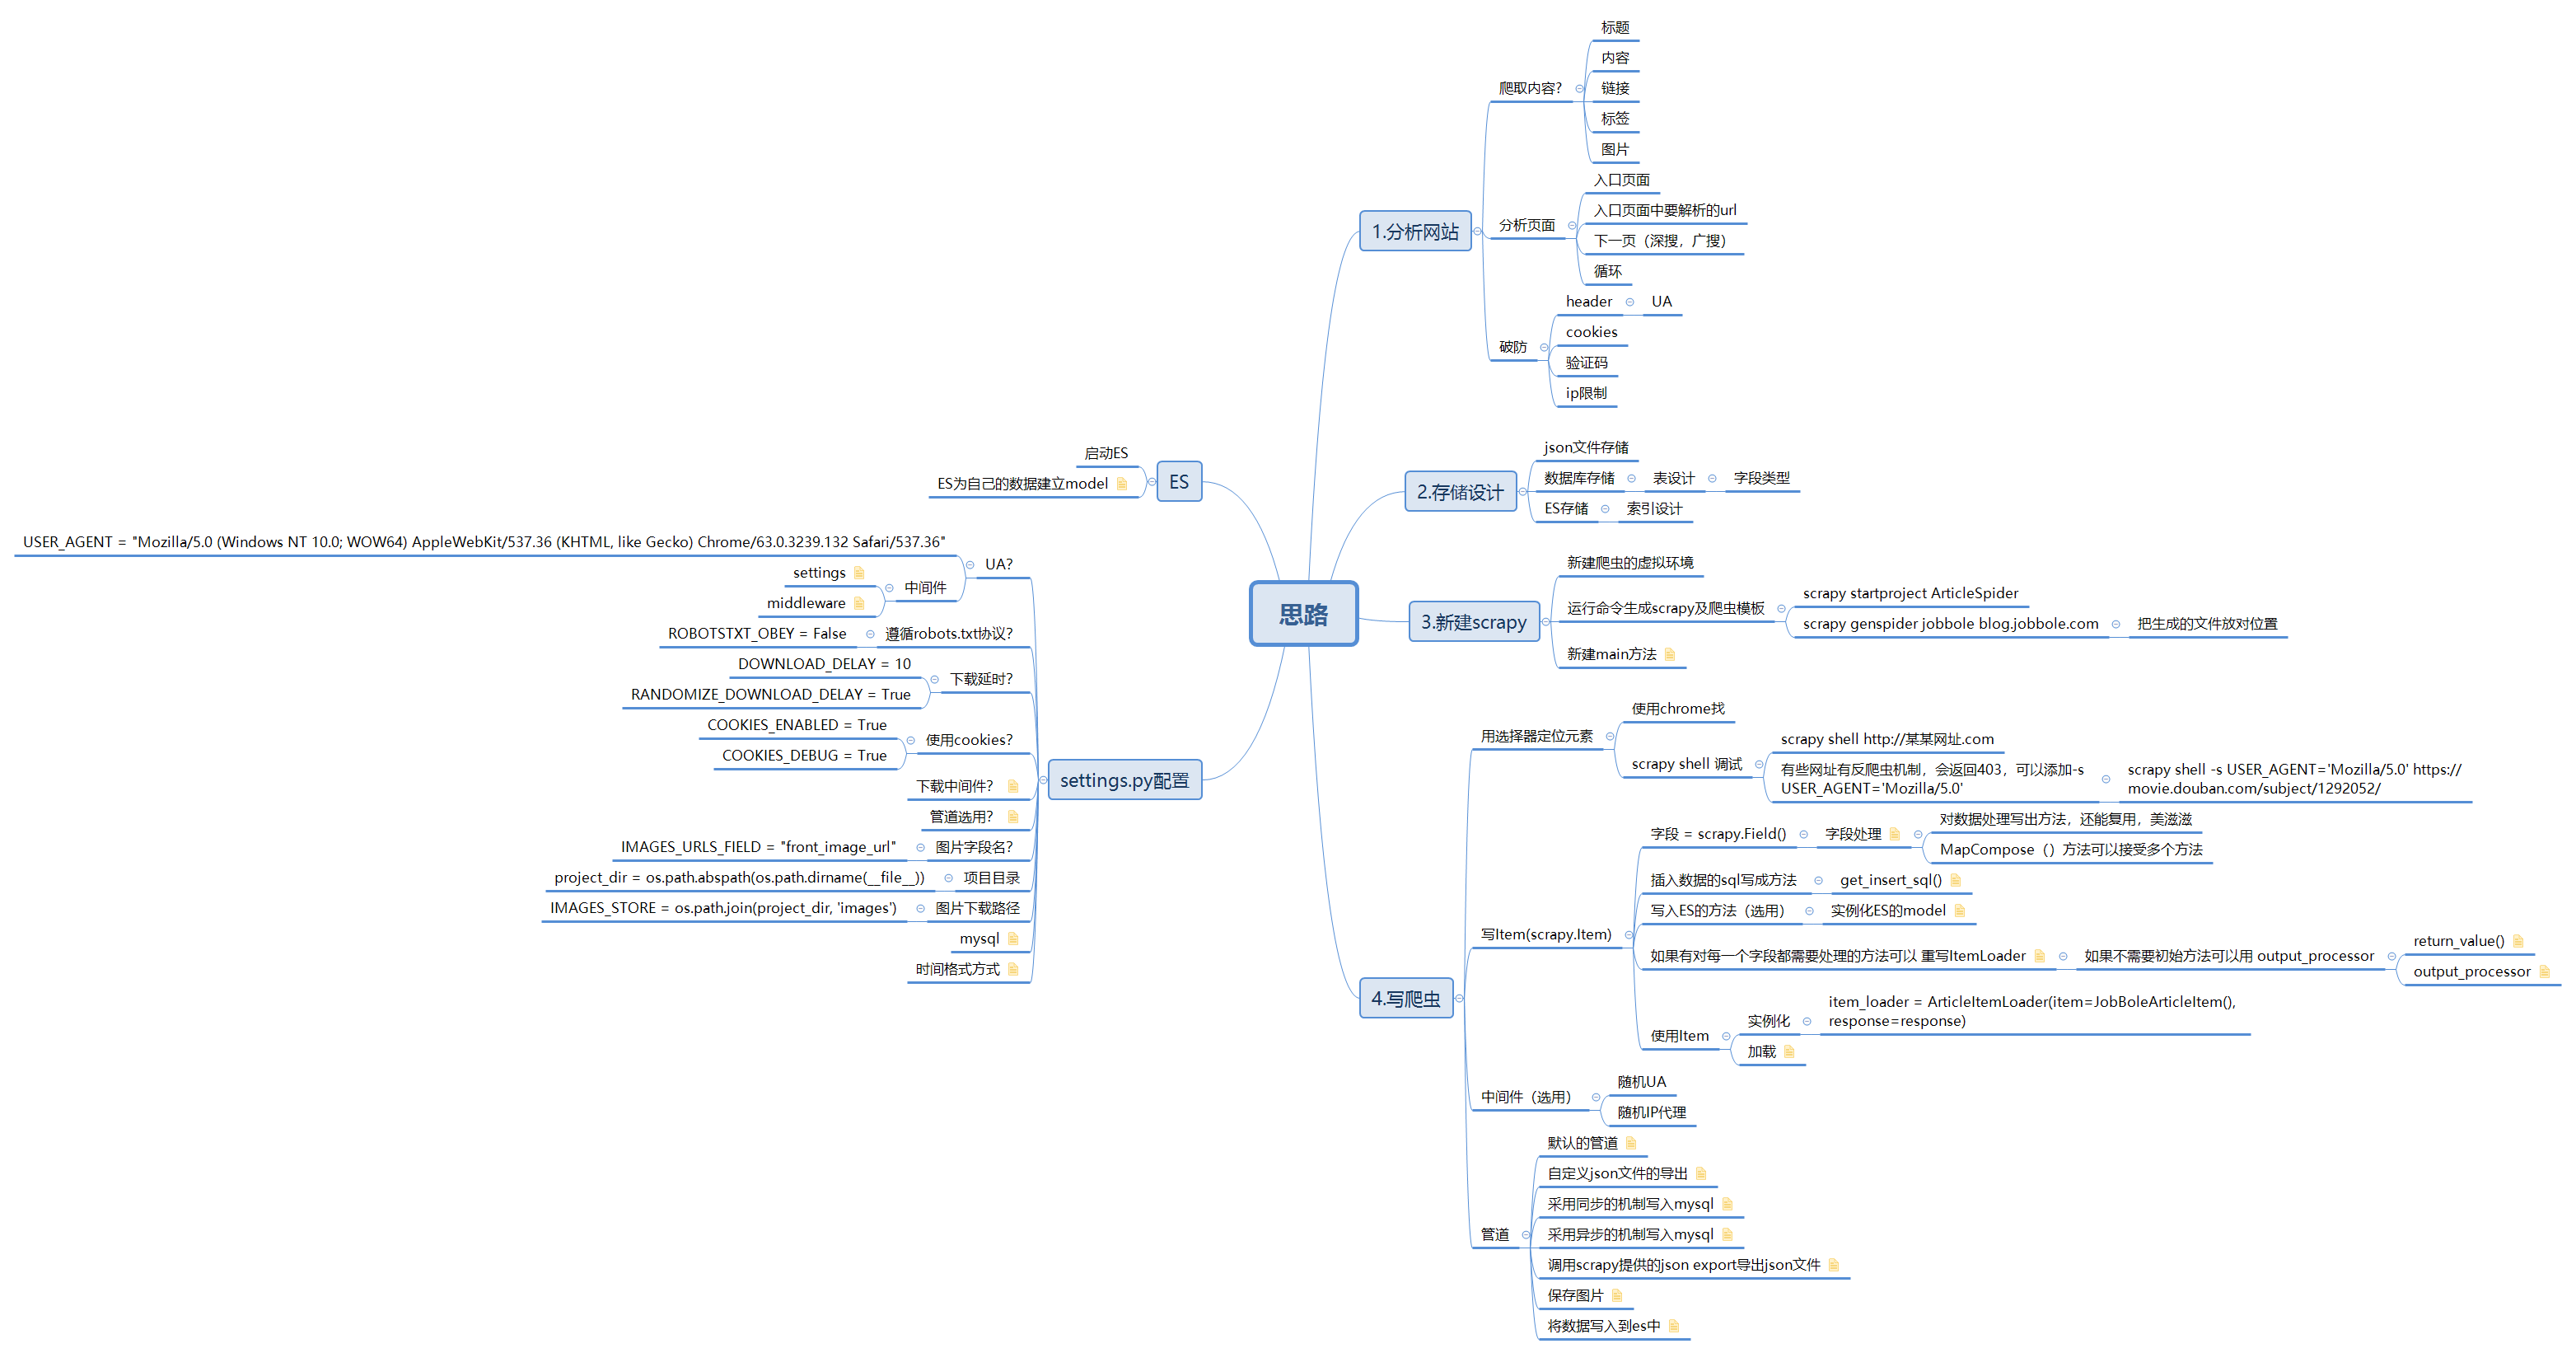
爬取网站思路

分析网站

爬取一个网站首先要了解这个网站,可以从以下几点去分析你要爬取的网站。

爬取内容

分析你需要哪些内容? 标题,文本内容,链接,tag,图片等等。

分析页面

分析你的入口页面,入口页面中要解析的url,如何进入下一页(深搜,广搜),如何循环。

破防

  • 头文件设置,header,UA
  • 是否使用cookies
  • 验证码如何应对
  • 有没有ip限制,接口调用频次限制

考虑存储设计

考虑用哪种方式存储数据?

  • json
  • mysql
  • ElasticSearch

新建scrapy

新建爬虫虚拟环境

mkvirtualenv my_spider --python==python3.7/python.e

阅读全文 →

爬取拉钩网

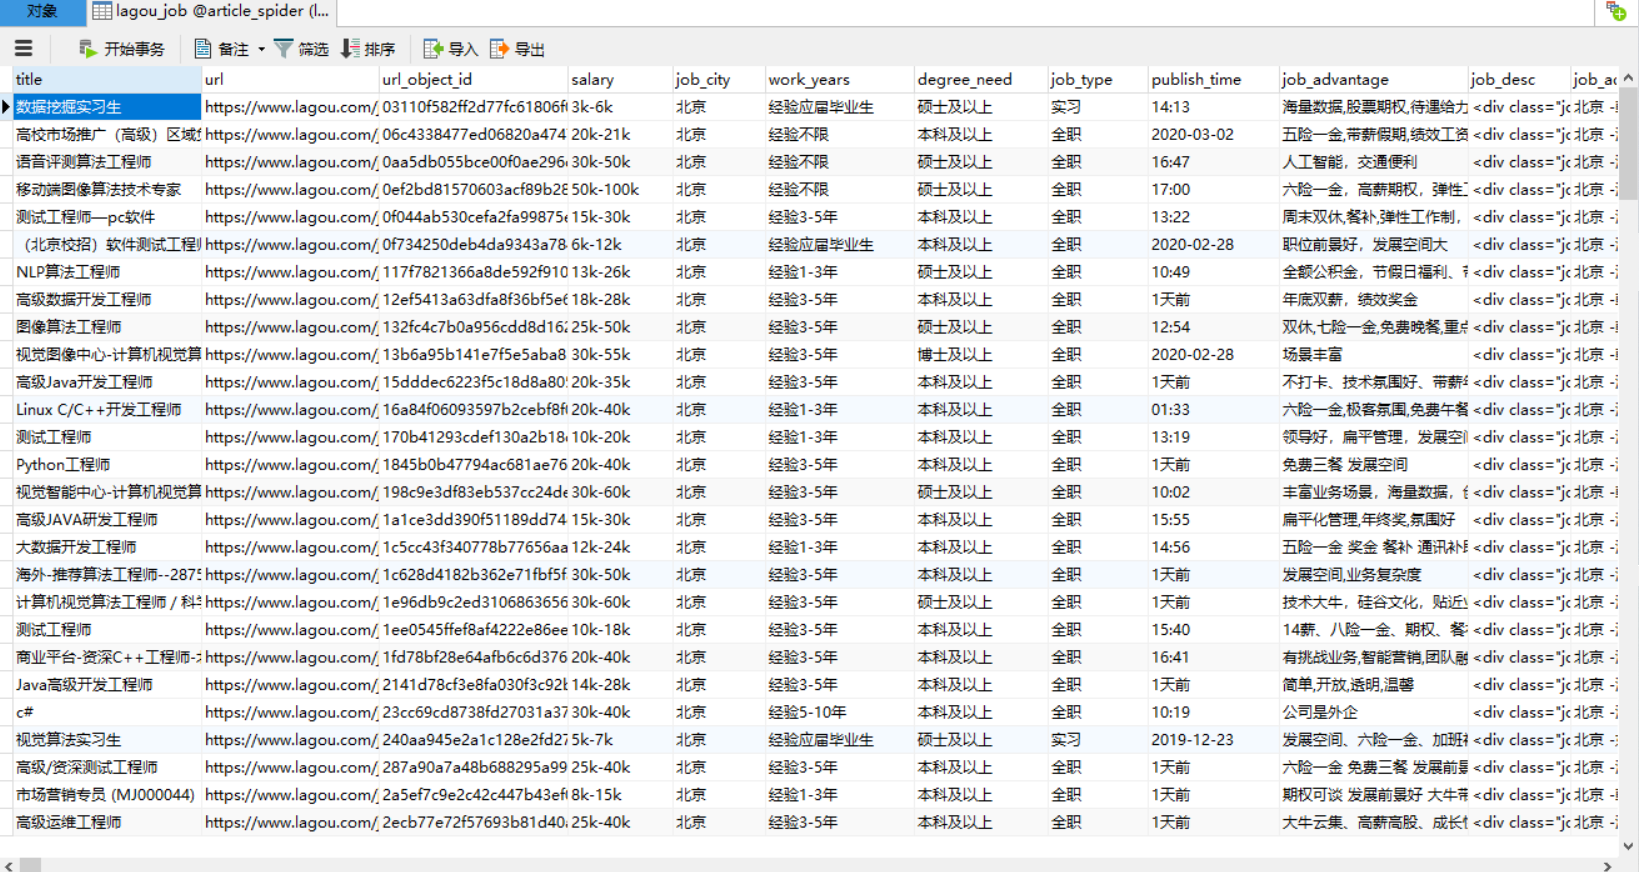
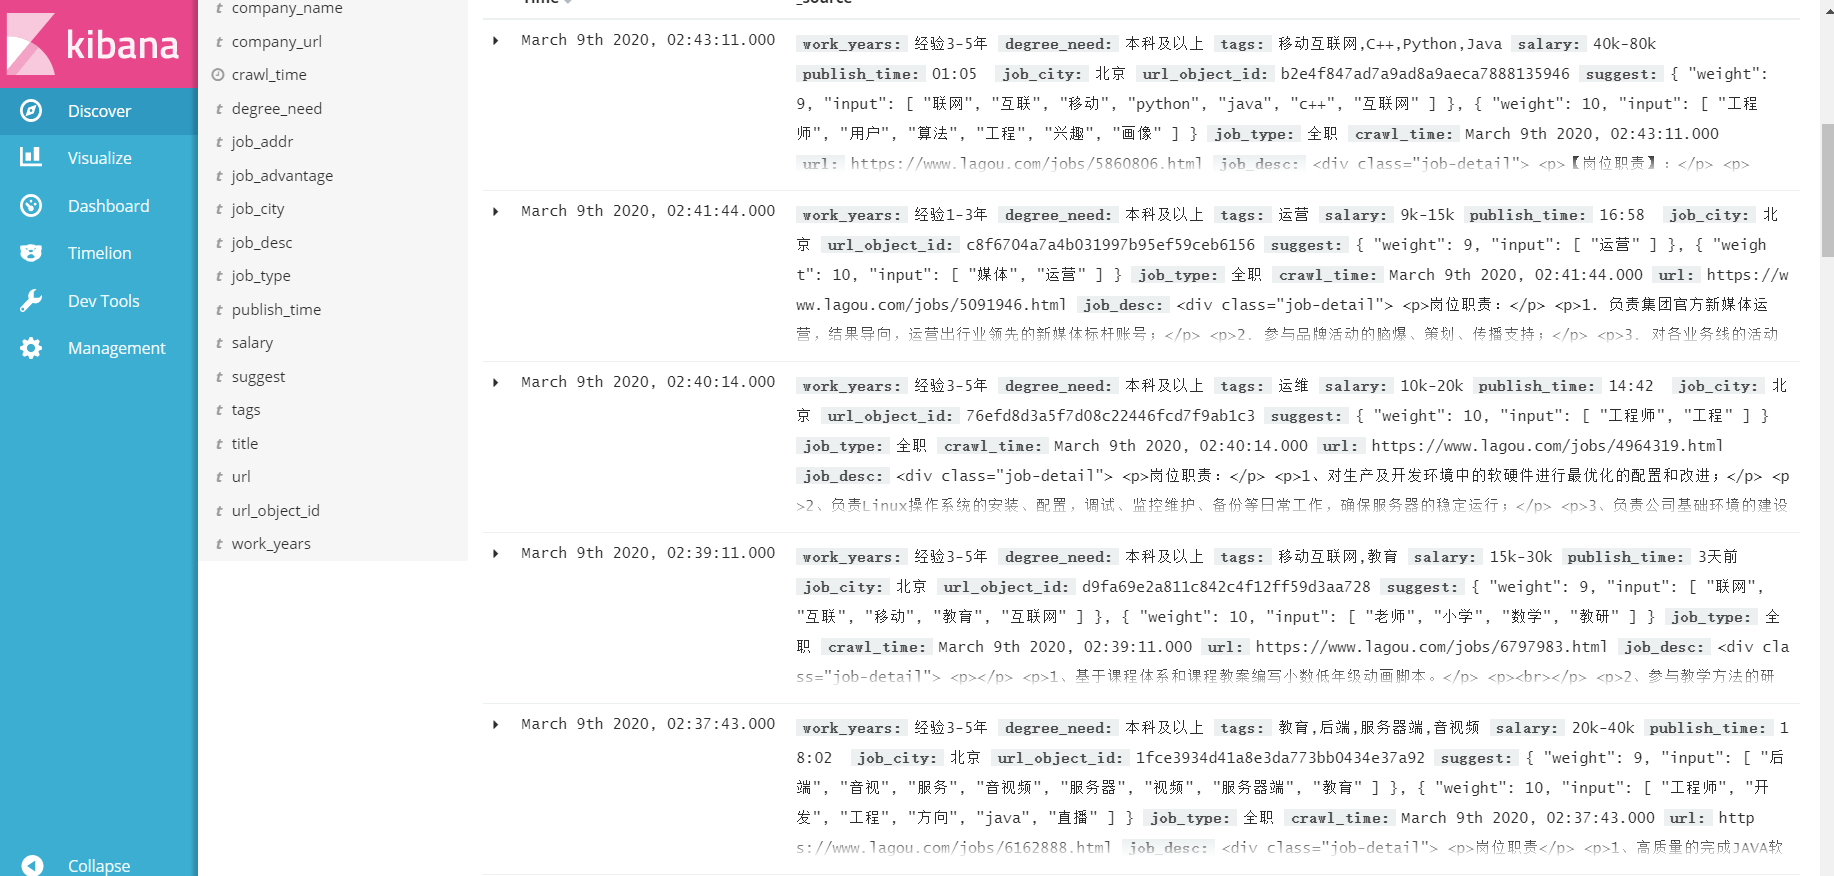
数据预览

编写lagou.py

文件位于 LagouSpider/spiders/lagou.py

导包

import scrapy
import pickle
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
from ..items import LagouJobItemLoader, LagouJobItem
from LagouSpdier.utils.common import get_md5
from datetime import dat

阅读全文 →

03.scrapy安装及目录结构

开始

1. 创建虚拟环境

打开cmd输入如下命令:

mkvirtualenv --python=C:\Python\Python35-32\python.exe article_spider

然后安装scrapy:

pip install -i https://pypi.douban.com/simple scrapy

注:出现 ==Failed building wheel for Twisted==时请去 https://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted 下载对应的whl,然后安装

pip install Twisted-18.9.0

阅读全文 →

04.xpath+css选择器

xpath简介

  1. xpath使用路径表达式在xml和html中进行导航
  2. xpath包含标准函数库
  3. xpath是一个w3c的标准

xpath语法

表达式 说明
article 选取所有article元素的所有子节点
/article 选取根元素article
article/a 选取所有属于article的子元素的a元素
//div 选取所有div子元素(不论出现在文档任何地方)
article//div 选取所有属于article元素的后代的div元素,不管它出现在哎article之下的任何位置
//@class 选取所有名为class的属性
/artic

阅读全文 →

05.编写spider

解析所有文章及提取下一页

# -*- coding: utf-8 -*-
import scrapy
import re
from scrapy.http import Request
from urllib import parse


# 提取字符串中的数字
def get_nums(str):
    match_re = re.match(".*(\d+).*", str)
    if match_re:
        nums = int(match_re.group(1))
    else:
        nums = 0
    return nums

阅读全文 →

06.保存数据

保存到json中

  1. 在pipelines.py中写入
import codecs
import json

# 用来配置保存到json文件
class JsonWhithEncondingPipeline(object):
    def __init__(self):
        self.file = codecs.open('article.json', 'w', encoding="utf-8")

    def process_item(self, item, spider):
        lines = json.du

阅读全文 →

07.模拟登陆

使用selenium登陆并保存cookie

# _*_ coding: utf-8 _*_
__author__ = 'daxiahy'
__date__ = '2019/2/26 21:38'
import time
import pickle
import scrapy
from selenium import webdriver
from scrapy.selector import Selector

def start_requests(self):
    brower = webdriver.Chrome(executable_path="

阅读全文 →

01.正则表达式

语法

  1. ==^== 破折号表示以什么为开头(破折号写在左侧)==$== 美元符号表示以什么为结尾
  2. ==.== 点号表示任意字符
  3. ==*== 星号表示前面的字符可以重复任意多遍(星号写在右侧)

例如:regex_str = "^b.*" 表示以b开头,后面出现任意字符任意多次都能匹配成功

import re

line = 'bobby123'
regex_str = "^b.*"
match_obj = re.match(regex_str, line)
if match_obj:
    print("yes")
  1. ==?==

阅读全文 →