编写yanzhao.py
爬取速度不要太快,尽量爬取你需要的分类
研招网还是很好爬取的,用谷歌浏览器查看浏览页面时的调用的接口,以及你要爬取的元素。
yanzhaoSpider
数据预览:
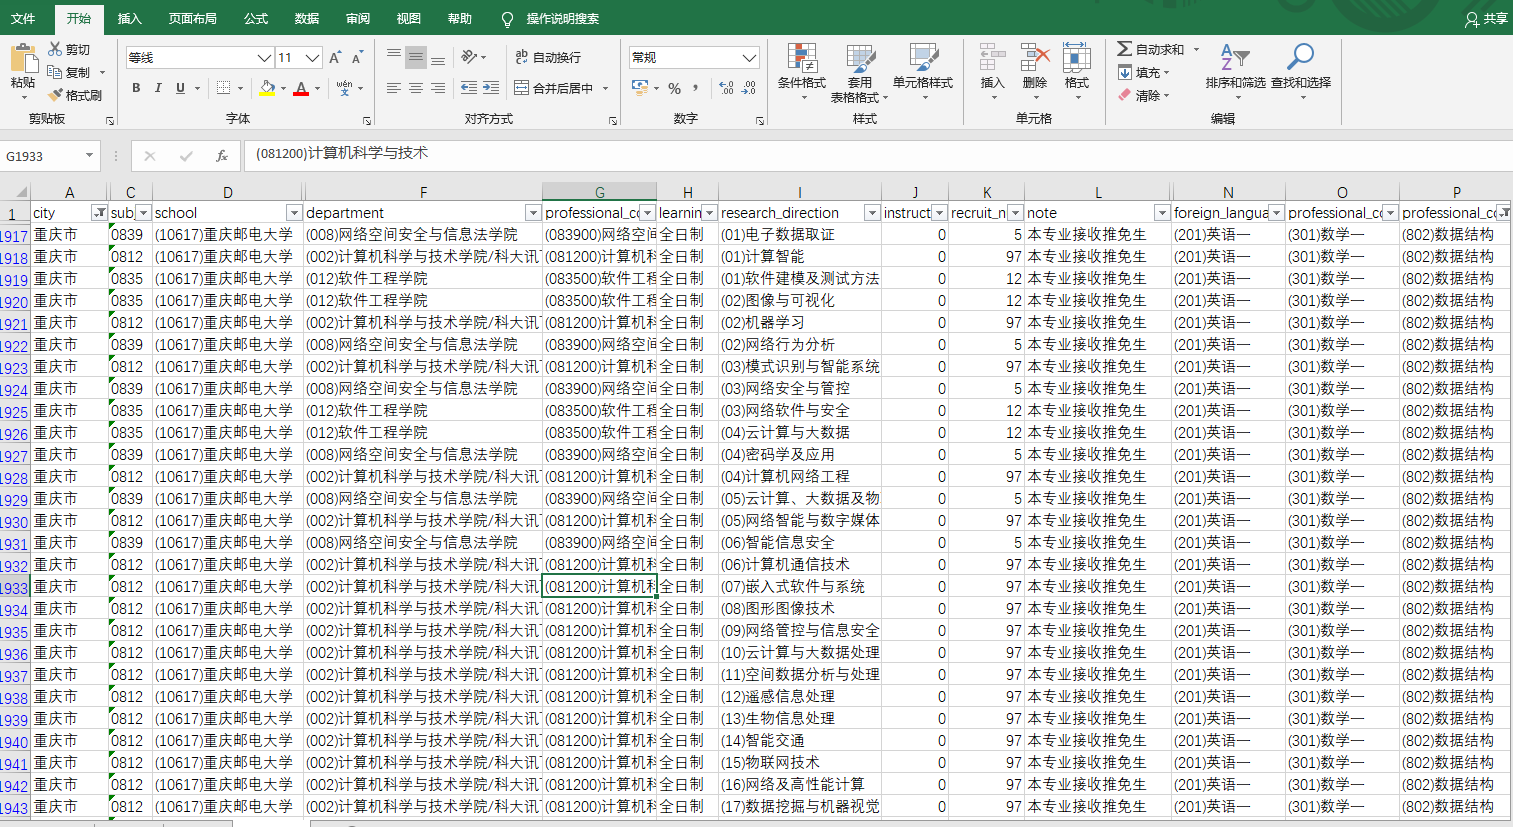
想要分析
- 专业招生人数
- 专业所考科目
- 学校城市
导包
# -*- coding: utf-8 -*-
import scrapy
from scrapy.http import Request
from urllib import parse
from yanzhaoSpider.utils.common import get_md5
from scrapy.http import FormRequest
from scrapy.selector import Selector
from yanzhaoSpider.items import yanzhaoItemLoader, yanzhaoItem
from urllib.parse import quote
from datetime import datetime
from .querySchAction import schAction
import re
def page_next(response):
    form_data = response.meta.get("form_data", "")
    selector = Selector(response=response)
    # 选择页
    pages = selector.css("ul > li.lip.selected > a::attr(onclick)").extract()[0]
    print("本页是:" + pages)
    # 页面表单信息
    form3 = selector.css("#form3 > input::attr(value)").extract()

    # 选择项的一下项,判断是否有下一页
    pages_next = selector.css("ul > li.lip.selected + li > a::attr(onclick)").extract()
    if pages_next:
        print("有下一页:", pages_next[0])
        # 正则提取下一页的值
        regex_str = ".*?(\d+)"
        match_obj = re.match(regex_str, pages_next[0])
        if match_obj:
            result = match_obj.group(1)
            if form3[0] == "确定":
                # 发送表单请求下一页=================================改解决办法有问题,需要改
                print("本页没有找到form3:", form3)
                next_response = schAction(form_data.get("ssdm"), form_data.get("dwmc"), form_data.get("mldm"),
                                          form_data.get("mlmc"), form_data.get("yjxkdm"), form_data.get("zymc"),
                                          form_data.get("xxfs"), result)
                return next_response
            else:
                # 发送表单请求下一页
                print("有下一页的form3:", form3)
                next_response = schAction(form3[0], form3[1], form3[2], form3[3], form3[4], form3[5], form3[6],
                                          result)
                return next_response
        else:
            return None
    else:
        print("没有有下一页")
        return None


class YanzhaoSpider(scrapy.Spider):
    name = 'yanzhao'
    allowed_domains = ['yz.chsi.com.cn']
    start_urls = ['https://yz.chsi.com.cn/zsml/queryAction.do']

    # 通过ssdm改变城市,yjxkdm一级学科代码 zymc专业名称
    def start_requests(self):
        city_lists = [{'mc': '北京市', 'dm': '11'}, {'mc': '天津市', 'dm': '12'}, {'mc': '河北省', 'dm': '13'},
                      {'mc': '山西省', 'dm': '14'}, {'mc': '内蒙古自治区', 'dm': '15'}, {'mc': '辽宁省', 'dm': '21'},
                      {'mc': '吉林省', 'dm': '22'}, {'mc': '黑龙江省', 'dm': '23'}, {'mc': '上海市', 'dm': '31'},
                      {'mc': '江苏省', 'dm': '32'}, {'mc': '浙江省', 'dm': '33'}, {'mc': '安徽省', 'dm': '34'},
                      {'mc': '福建省', 'dm': '35'}, {'mc': '江西省', 'dm': '36'}, {'mc': '山东省', 'dm': '37'},
                      {'mc': '河南省', 'dm': '41'}, {'mc': '湖北省', 'dm': '42'}, {'mc': '湖南省', 'dm': '43'},
                      {'mc': '广东省', 'dm': '44'}, {'mc': '广西壮族自治区', 'dm': '45'}, {'mc': '海南省', 'dm': '46'},
                      {'mc': '重庆市', 'dm': '50'}, {'mc': '四川省', 'dm': '51'}, {'mc': '贵州省', 'dm': '52'},
                      {'mc': '云南省', 'dm': '53'}, {'mc': '西藏自治区', 'dm': '54'}, {'mc': '陕西省', 'dm': '61'},
                      {'mc': '甘肃省', 'dm': '62'}, {'mc': '青海省', 'dm': '63'}, {'mc': '宁夏回族自治区', 'dm': '64'},
                      {'mc': '新疆维吾尔自治区', 'dm': '65'}]

        url = self.start_urls[0]
        UA = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) " \
             "Chrome/75.0.3770.90 Safari/537.36"
        # headers UA
        headers = {"User-Agent": UA,
                   "Host": "yz.chsi.com.cn",
                   "Content-Type": "application/x-www-form-urlencoded"}
        for i in city_lists:
            dm = i.get('dm')
            form_data = {"ssdm": dm,  # 城市
                         "dwmc": "",
                         "mldm": "08",  # 08  07  zyxw
                         "mlmc": "",
                         "yjxkdm": "0839",  # 0812  0775 0852 0854 0835
                         "zymc": "",  # 计算机技术
                         "xxfs": ""}

            # FormRequest()就是用来构造POST请求的类。
            request = FormRequest(url, formdata=form_data, meta={"form_data": form_data}, headers=headers,
                                  callback=self.parse_school)
            yield request

    # 解析目录页 有哪些学校
    def parse_school(self, response):
        # 解析页面内容 然后 交给详情页处理方法
        post_nodes = response.css('table > tbody > tr')
        form_data = response.meta.get("form_data", "")
        for post_node in post_nodes:
            post_url = post_node.css("a::attr(href)").extract_first("")
            if post_url:
                print(post_url)  # url
                # parse.urljoin(response.url, post_url)表示有绝对域名就直接使用,相对域名就拼接主域名
                yield Request(url=parse.urljoin(response.url, post_url), meta={"form_data": form_data},
                              callback=self.parse_major, dont_filter=True)  # dont_filter代表去重
            else:
                # 判断该页面有没有数据 没有数据就直接返回
                return

        # 判断是否存在下一页
        next_response = page_next(response)
        if next_response:
            self.parse_school(next_response)

    # 解析有哪些专业
    def parse_major(self, response):
        post_nodes = response.css('table > tbody > tr')
        # from3
        selector = Selector(response=response)
        form3 = selector.css("#form3 > input::attr(value)").extract()
        print("major页form4:", form3)
        for post_node in post_nodes:
            post_url = post_node.css("a::attr(href)").extract_first("")
            print(post_url)  # url
            # parse.urljoin(response.url, post_url)表示有绝对域名就直接使用,相对域名就拼接主域名
            yield Request(url=parse.urljoin(response.url, post_url), meta={"form3": form3}, callback=self.parse_detail,
                          dont_filter=True)

        # 判断是否存在下一页
        next_response = page_next(response)
        if next_response:
            self.parse_major(next_response)

    # 解析内容页
    def parse_detail(self, response):
        form3 = response.meta.get("form3", "")
        item_loader = yanzhaoItemLoader(item=yanzhaoItem(), response=response)
        try:
            item_loader.add_value("city", form3[0])  # 11 北京
            item_loader.add_value("mldm", form3[2])  # 门类代码 13+1
            item_loader.add_value("subject", form3[4])  # 0852 工程
        except Exception as e:
            print(e)
            item_loader.add_value("city", '')  # 11 北京
            item_loader.add_value("mldm", '')  # 门类代码 13+1
            item_loader.add_value("subject", '')  # 0852 工程

        item_loader.add_css("school",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(1) > td:nth-child(2)::text')
        item_loader.add_css("test_way",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(1) > td:nth-child(4)::text')
        item_loader.add_css("department",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(2) > td:nth-child(2)::text')
        item_loader.add_css("professional_code",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(3) > td:nth-child(2)::text')
        item_loader.add_css("learning_style",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(3) > td:nth-child(4)::text')
        item_loader.add_css("research_direction",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(4) > td:nth-child(2)::text')
        item_loader.add_css("instructors",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(4) > td:nth-child(4)::text')
        item_loader.add_css("recruit_num",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(5) > td:nth-child(2)::text')
        item_loader.add_css("note",
                            'div.zsml-wrapper > table > tbody > tr:nth-child(6) > td:nth-child(2) > span::text')
        # 考试范围可能有多种
        item_loader.add_css("political",
                            'div.zsml-wrapper > div > table > tbody > tr > td:nth-child(1)::text')
        item_loader.add_css("foreign_language",
                            'div.zsml-wrapper > div > table > tbody > tr > td:nth-child(2)::text')
        item_loader.add_css("professional_course1",
                            'div.zsml-wrapper > div > table > tbody > tr > td:nth-child(3)::text')
        item_loader.add_css("professional_course2",
                            'div.zsml-wrapper > div > table > tbody > tr > td:nth-child(4)::text')

        item_loader.add_value("insert_time", datetime.now())
        top_item = item_loader.load_item()
        yield top_item
编写item.py
from scrapy.loader import ItemLoader
import scrapy
from scrapy.loader.processors import MapCompose, TakeFirst, Join
from .settings import SQL_DATETIME_FORMAT, SQL_DATE_FORMAT
from w3lib.html import remove_tags
import re


city_lists = [{'mc': '北京市', 'dm': '11'}, {'mc': '天津市', 'dm': '12'}, {'mc': '河北省', 'dm': '13'},
              {'mc': '山西省', 'dm': '14'}, {'mc': '内蒙古自治区', 'dm': '15'}, {'mc': '辽宁省', 'dm': '21'},
              {'mc': '吉林省', 'dm': '22'}, {'mc': '黑龙江省', 'dm': '23'}, {'mc': '上海市', 'dm': '31'},
              {'mc': '江苏省', 'dm': '32'}, {'mc': '浙江省', 'dm': '33'}, {'mc': '安徽省', 'dm': '34'},
              {'mc': '福建省', 'dm': '35'}, {'mc': '江西省', 'dm': '36'}, {'mc': '山东省', 'dm': '37'},
              {'mc': '河南省', 'dm': '41'}, {'mc': '湖北省', 'dm': '42'}, {'mc': '湖南省', 'dm': '43'},
              {'mc': '广东省', 'dm': '44'}, {'mc': '广西壮族自治区', 'dm': '45'}, {'mc': '海南省', 'dm': '46'},
              {'mc': '重庆市', 'dm': '50'}, {'mc': '四川省', 'dm': '51'}, {'mc': '贵州省', 'dm': '52'},
              {'mc': '云南省', 'dm': '53'}, {'mc': '西藏自治区', 'dm': '54'}, {'mc': '陕西省', 'dm': '61'},
              {'mc': '甘肃省', 'dm': '62'}, {'mc': '青海省', 'dm': '63'}, {'mc': '宁夏回族自治区', 'dm': '64'},
              {'mc': '新疆维吾尔自治区', 'dm': '65'}]

def getCity(dm):
    for i in city_lists:
        if i.get('dm')==dm:
            return i.get('mc')
    return 0

def get_num(value):
    # 正则提取下一页的值
    regex_str = ".*?(\d+)"
    match_obj = re.match(regex_str,value)
    if match_obj:
        value = match_obj.group(1)
        return value


def str_format(value):
    value = value.replace(" ", "").replace(",", "").replace("'", "").strip()
    return value

def str_format2(value):
    value=str(value)
    value = value.replace(",", "").replace("[", "").replace("]", "").replace("'", "").strip()
    return value

def return_value(value):
    return value

def take_all(value):
    lis2 = list()
    for li in value:
        if li not in lis2:
            lis2.append(li)
    str=''
    for i in range(len(lis2)):
        str=str+value[i]+" "
    return str

class yanzhaoItemLoader(ItemLoader):
    # 自定义itemloader
    default_output_processor = TakeFirst()


class yanzhaoItem(scrapy.Item):
    # yanzhao信息
    city = scrapy.Field(
        input_processor=MapCompose(getCity)
    )
    mldm = scrapy.Field()
    subject = scrapy.Field()
    school = scrapy.Field()
    test_way = scrapy.Field()
    department = scrapy.Field()
    professional_code = scrapy.Field()
    learning_style = scrapy.Field()
    research_direction = scrapy.Field()
    instructors = scrapy.Field()
    recruit_num = scrapy.Field(
        input_processor=MapCompose(get_num))
    note = scrapy.Field()  # 可能为空
    political = scrapy.Field(
        input_processor=MapCompose(str_format),
        output_processor=MapCompose(return_value)
    )
    foreign_language = scrapy.Field(
        input_processor=MapCompose(str_format),
        output_processor=MapCompose(return_value)
    )
    professional_course1 = scrapy.Field(
        input_processor=MapCompose(str_format),
        output_processor=MapCompose(return_value)
    )
    professional_course2 = scrapy.Field(
        input_processor=MapCompose(str_format),
        output_processor=MapCompose(return_value)
    )
    insert_time=scrapy.Field()


    def get_insert_sql(self):
        insert_sql = """
            insert into yanzhao(city,mldm,subject,school,test_way,department,professional_code,learning_style,
            research_direction,instructors,recruit_num,note,political,foreign_language,professional_course1,
            professional_course2,insert_time) VALUES (%s,%s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s)
            ON DUPLICATE KEY UPDATE recruit_num=values(recruit_num), insert_time=VALUES(insert_time)
        """
        params = (
            self.get("city", 0),self.get("mldm", 0), self.get("subject", 0), self.get("school", 0), self.get("test_way", 0),
            self.get("department", 0),self.get("professional_code", 0), self.get("learning_style", 0),
            self.get("research_direction", 0), self.get("instructors", 0), self.get("recruit_num", 0),
            self.get("note", 0), take_all(self.get("political", 0)), take_all(self.get("foreign_language", 0)),
            take_all(self.get("professional_course1", 0)), take_all(self.get("professional_course2", 0)),
            self["insert_time"].strftime(SQL_DATETIME_FORMAT),
        )
        print(insert_sql, params)
        return insert_sql, params
编写中间件
from scrapy import signals
from fake_useragent import UserAgent
class RandomUserAgentMiddlware(object):
    #随机更换user-agent
    def __init__(self, crawler):
        super(RandomUserAgentMiddlware, self).__init__()
        self.ua = UserAgent()
        self.ua_type = crawler.settings.get("RANDOM_UA_TYPE", "random")

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler)

    def process_request(self, request, spider):
        def get_ua():
            return getattr(self.ua, self.ua_type)

        request.headers.setdefault('User-Agent', get_ua())
编写管道 pipline.py
import pymysql
from twisted.enterprise import adbapi


class YanzhaospiderPipeline(object):
    def process_item(self, item, spider):
        return item


class MysqlTwistedPipline(object):
    def __init__(self, dbpool):
        self.dbpool = dbpool

    @classmethod
    def from_settings(cls, settings):
        dbparms = dict(
            host = settings["MYSQL_HOST"],
            db = settings["MYSQL_DBNAME"],
            user = settings["MYSQL_USER"],
            passwd = settings["MYSQL_PASSWORD"],
            charset='utf8',
            cursorclass=pymysql.cursors.DictCursor,
            use_unicode=True,
        )
        dbpool = adbapi.ConnectionPool("pymysql", **dbparms)

        return cls(dbpool)

    def process_item(self, item, spider):
        #使用twisted将mysql插入变成异步执行
        query = self.dbpool.runInteraction(self.do_insert, item)
        query.addErrback(self.handle_error, item, spider) #处理异常

    def handle_error(self, failure, item, spider):
        #处理异步插入的异常
        print (failure)

    def do_insert(self, cursor, item):
        #执行具体的插入
        #根据不同的item 构建不同的sql语句并插入到mysql中
        insert_sql, params = item.get_insert_sql()
        cursor.execute(insert_sql, params)
编写设置
BOT_NAME = 'yanzhaoSpider'

SPIDER_MODULES = ['yanzhaoSpider.spiders']
NEWSPIDER_MODULE = 'yanzhaoSpider.spiders'


USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.90 Safari/537.36'
RANDOM_UA_TYPE = "random"
ROBOTSTXT_OBEY = False


DOWNLOADER_MIDDLEWARES = {
    'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': 2,
}

import os
import sys
BASE_DIR = os.path.dirname(os.path.abspath(os.path.dirname(__file__)))
sys.path.insert(0,os.path.join(BASE_DIR,'yanzhaoSpider'))

MYSQL_HOST = "127.0.0.1"
MYSQL_DBNAME = "article_spider"
MYSQL_USER = "root"
MYSQL_PASSWORD = "root"

SQL_DATETIME_FORMAT = "%Y-%m-%d %H:%M:%S"
SQL_DATE_FORMAT = "%Y-%m-%d"
爬虫的运行
运行该爬虫需要修改 yanzhao.py中start_requests方法中的 form_data表单参数,再去爬取你所关心的专业。 具体城市,门类代码,学科代码可以通过 Ss_url="https://yz.chsi.com.cn/zsml/pages/getSs.jsp" # 城市 Ml_url="https://yz.chsi.com.cn/zsml/pages/getMl.jsp" # 门类 Zy_url="https://yz.chsi.com.cn/zsml/pages/getZy.jsp" # 专业 zyxw zy_url="https://yz.chsi.com.cn/zsml/code/zy.do" # 专硕专业 这就几个接口获得
启动
scrapy crawl yanzhao -s JOBDIR=job_info/001