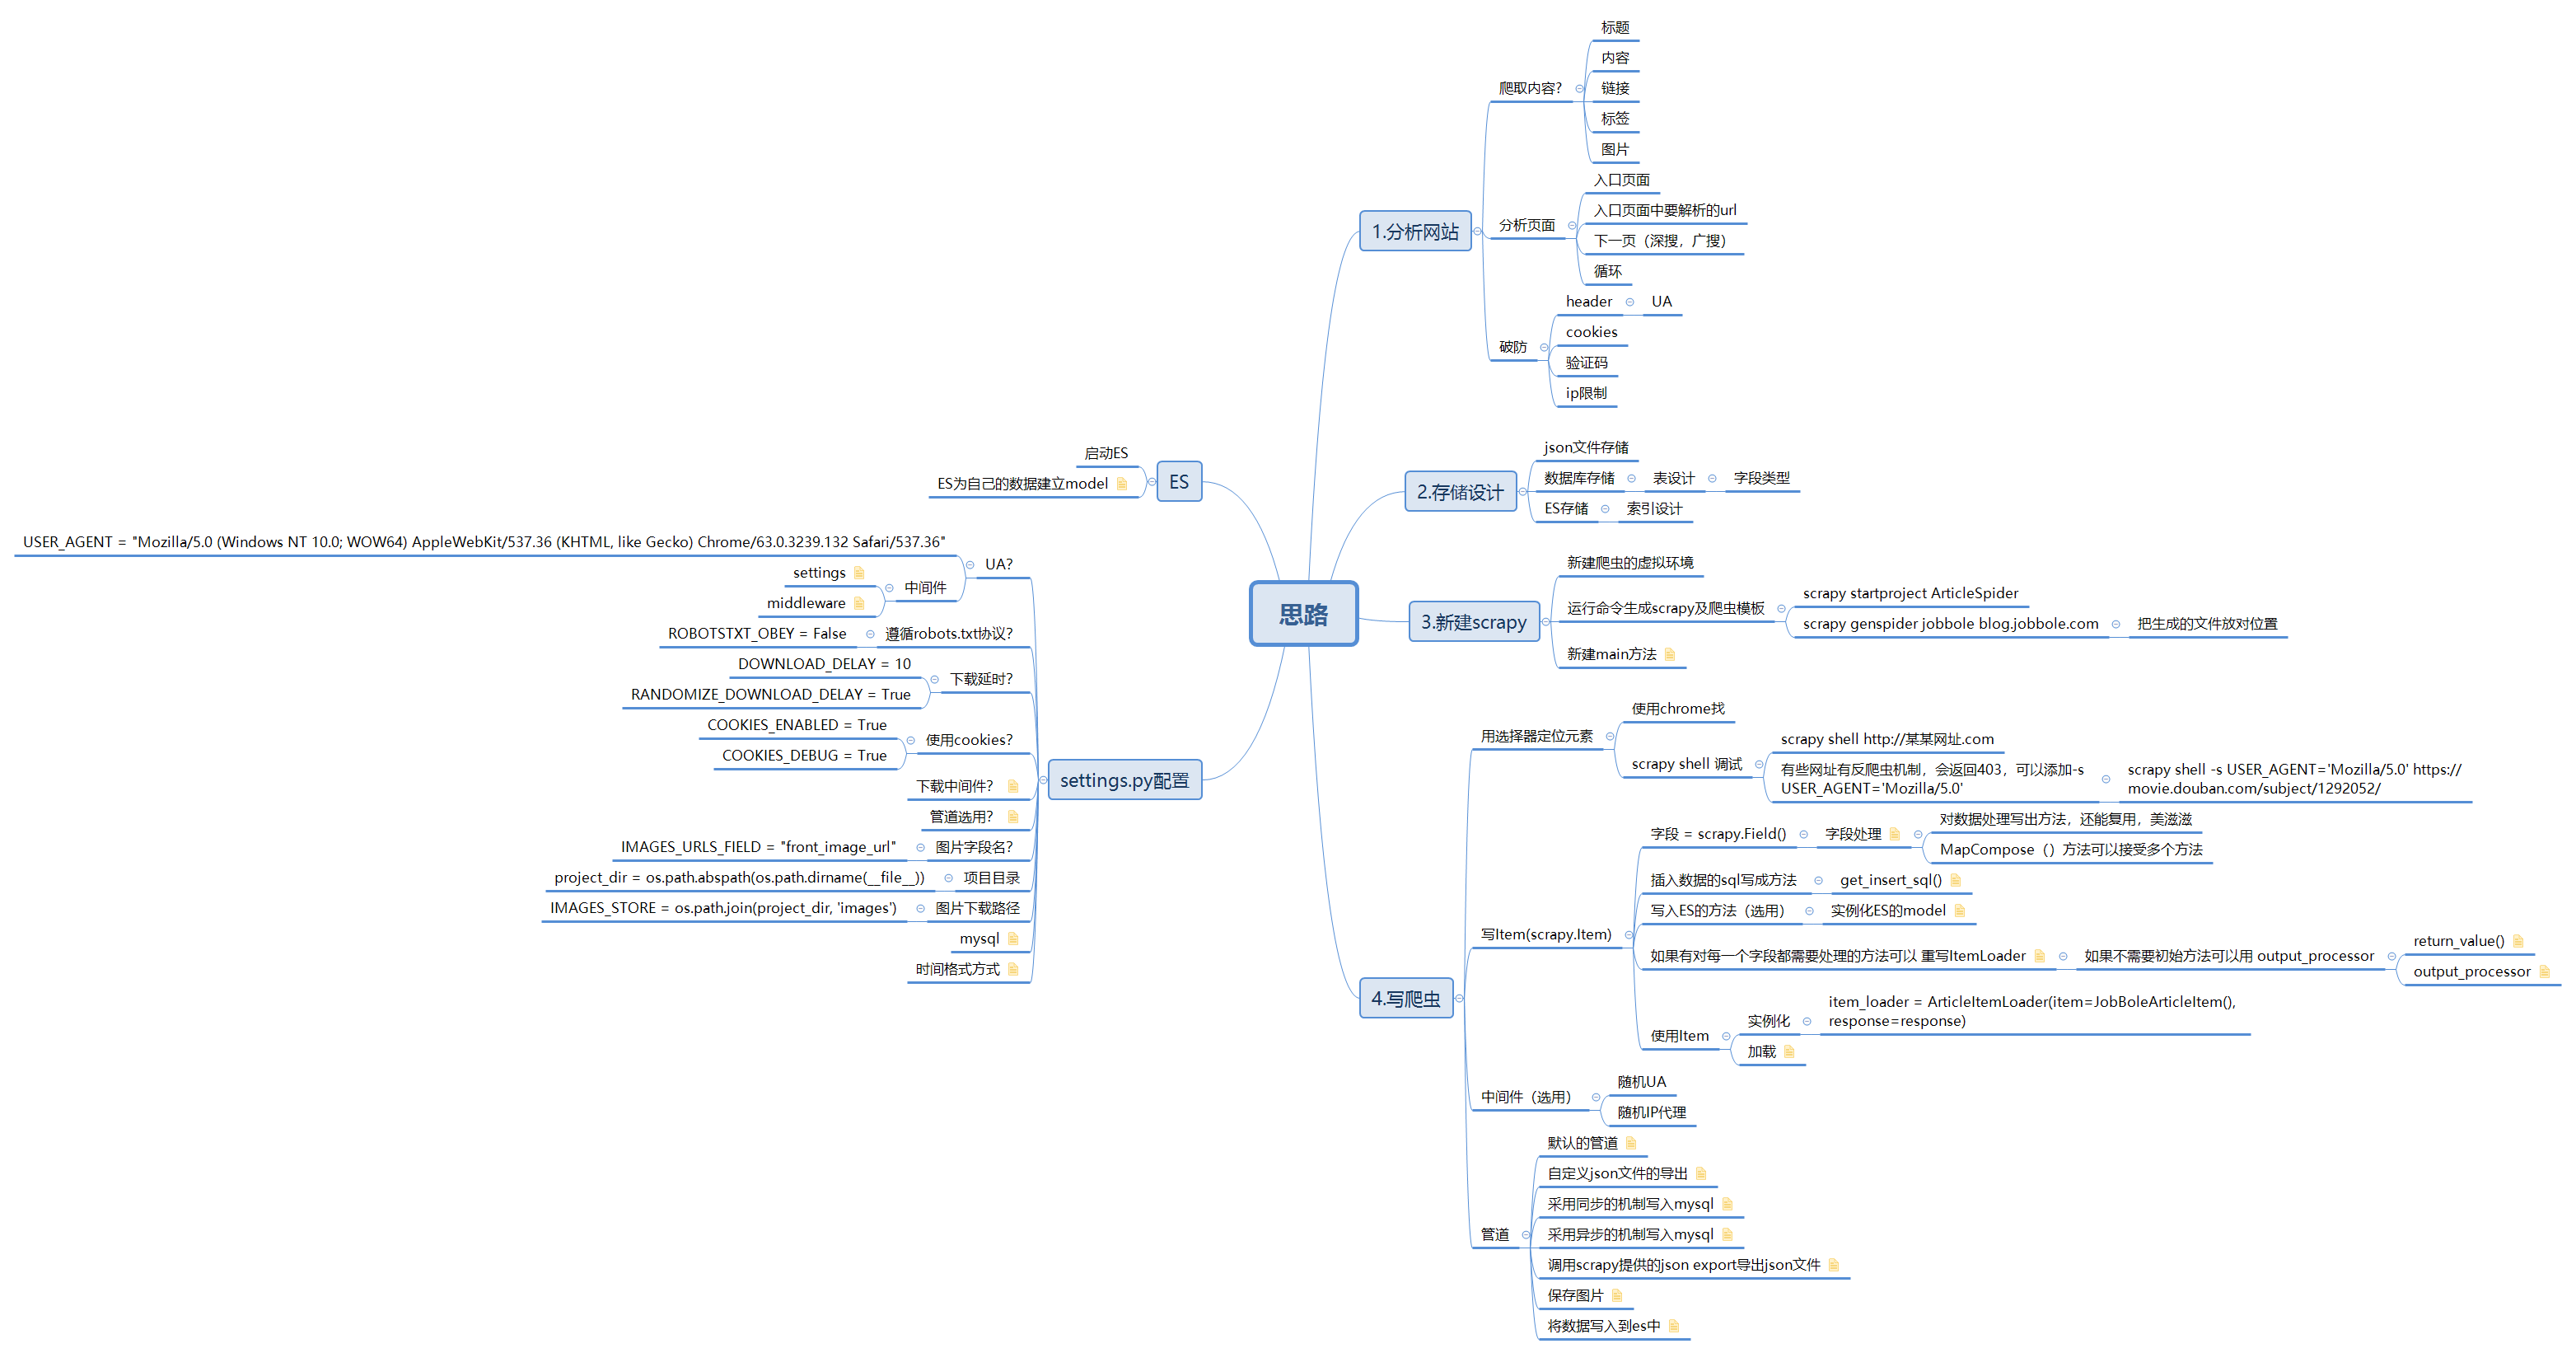
分析网站
爬取一个网站首先要了解这个网站,可以从以下几点去分析你要爬取的网站。
爬取内容
分析你需要哪些内容? 标题,文本内容,链接,tag,图片等等。
分析页面
分析你的入口页面,入口页面中要解析的url,如何进入下一页(深搜,广搜),如何循环。
破防
- 头文件设置,header,UA
- 是否使用cookies
- 验证码如何应对
- 有没有ip限制,接口调用频次限制
考虑存储设计
考虑用哪种方式存储数据?
- json
- mysql
- ElasticSearch
新建scrapy
新建爬虫虚拟环境
mkvirtualenv my_spider --python==python3.7/python.exe
workon my_spider
安装 scrapy
pip install scrapy运行命令生成scrapy及爬虫模板
scrapy startproject Lagou_Spider
scrapy genspider Lagou www.lagou.com
把生成的文件放对位置
新建main方法
# _*_ coding: utf-8 _*_

from scrapy.cmdline import execute

import sys
import os

print(os.path.dirname(os.path.abspath(__file__)))  # 打印目录
sys.path.append(os.path.dirname(os.path.abspath(__file__)))  # 寻找项目工程目录
execute(["scrapy", "crawl", "lagou"])
写爬虫
用选择器定位元素
使用chrome找
打开 chrome 按F12,慢慢找
scrapy shell 调试
scrapy shell http://某某网址.com有些网址有反爬虫机制,会返回403,可以添加-s USER_AGENT='Mozilla/5.0'
scrapy shell -s USER_AGENT='Mozilla/5.0' https://movie.douban.com/subject/1292052/写Item(scrapy.Item)
字段 = scrapy.Field()
字段处理
create_date = scrapy.Field(
        input_processor=MapCompose(date_convert),
    )
对数据处理写出方法,还能复用,美滋滋,
MapCompose()方法可以接受多个方法
插入数据的sql写成方法
get_insert_sql()
def get_insert_sql(self):
        insert_sql = """
            insert into jobbole_article(title, url, create_date, fav_nums)
            VALUES (%s, %s, %s, %s) ON DUPLICATE KEY UPDATE content=VALUES(fav_nums)
        """
        params = (self["title"], self["url"], self["create_date"], self["fav_nums"])

        return insert_sql, params
写入ES的方法(选用)
实例化ES的model
def save_to_es(self):
        article = ArticleType()
        article.title = self['title']
        article.create_date = self["create_date"]
        article.content = remove_tags(self["content"])  # 删掉html的tag
        article.front_image_url = self["front_image_url"]
        if "front_image_path" in self:
            article.front_image_path = self["front_image_path"]
        article.praise_nums = self["praise_nums"]
        article.fav_nums = self["fav_nums"]
        article.comment_nums = self["comment_nums"]
        article.url = self["url"]
        article.tags = self["tags"]
        article.meta.id = self["url_object_id"]

        article.suggest = gen_suggests(ArticleType._doc_type.index, ((article.title,10),(article.tags, 7)))

        article.save()

        redis_cli.incr("jobbole_count")

        return


def gen_suggests(index, info_tuple):
    #根据字符串生成搜索建议数组
    used_words = set()
    suggests = []
    for text, weight in info_tuple:
        if text:
            #调用es的analyze接口分析字符串
            words = es.indices.analyze(index=index, analyzer="ik_max_word", params={'filter':["lowercase"]}, body=text)
            anylyzed_words = set([r["token"] for r in words["tokens"] if len(r["token"])>1])
            new_words = anylyzed_words - used_words
        else:
            new_words = set()

        if new_words:
            suggests.append({"input":list(new_words), "weight":weight})

    return suggests
如果有对每一个字段都需要处理的方法可以 重写ItemLoader
class ArticleItemLoader(ItemLoader):
    #自定义itemloader
    default_output_processor = TakeFirst()
如果不需要初始方法可以用 output_processor
return_value()
def return_value(value):
    return value
output_processor
front_image_url = scrapy.Field(
        output_processor=MapCompose(return_value)
    )
使用Item
实例化
item_loader = ArticleItemLoader(item=JobBoleArticleItem(), response=response)加载
def parse_detail(self, response):
front_image_url = response.meta.get("front_image_url", "")  # 文章封面图
        item_loader = ArticleItemLoader(item=JobBoleArticleItem(), response=response)
        item_loader.add_css("title", ".entry-header h1::text")
        item_loader.add_value("url", response.url)
        item_loader.add_value("url_object_id", get_md5(response.url))
        item_loader.add_css("create_date", "p.entry-meta-hide-on-mobile::text")
        item_loader.add_value("front_image_url", [front_image_url])
        item_loader.add_css("praise_nums", ".vote-post-up h10::text")
        item_loader.add_css("comment_nums", "a[href='#article-comment'] span::text")
        item_loader.add_css("fav_nums", ".bookmark-btn::text")
        item_loader.add_css("tags", "p.entry-meta-hide-on-mobile a::text")
        item_loader.add_css("content", "div.entry")

        article_item = item_loader.load_item()


        yield article_item
中间件(选用)
- 随机UA
- 随机IP代理
管道
默认的管道
class ArticlespiderPipeline(object):
    def process_item(self, item, spider):
        return item
自定义json文件的导出
class JsonWithEncodingPipeline(object):
    #自定义json文件的导出
    def __init__(self):
        self.file = codecs.open('article.json', 'w', encoding="utf-8")
    def process_item(self, item, spider):
        lines = json.dumps(dict(item), ensure_ascii=False) + "\n"
        self.file.write(lines)
        return item
    def spider_closed(self, spider):
        self.file.close()
采用同步的机制写入mysql
class MysqlPipeline(object):
    #采用同步的机制写入mysql
    def __init__(self):
        self.conn = MySQLdb.connect('192.168.0.106', 'root', 'root', 'article_spider', charset="utf8", use_unicode=True)
        self.cursor = self.conn.cursor()

    def process_item(self, item, spider):
        insert_sql = """
            insert into jobbole_article(title, url, create_date, fav_nums)
            VALUES (%s, %s, %s, %s)
        """
        self.cursor.execute(insert_sql, (item["title"], item["url"], item["create_date"], item["fav_nums"]))
        self.conn.commit()
采用异步的机制写入mysql
class MysqlTwistedPipline(object):
    def __init__(self, dbpool):
        self.dbpool = dbpool

    @classmethod
    def from_settings(cls, settings):
        dbparms = dict(
            host = settings["MYSQL_HOST"],
            db = settings["MYSQL_DBNAME"],
            user = settings["MYSQL_USER"],
            passwd = settings["MYSQL_PASSWORD"],
            charset='utf8',
            cursorclass=MySQLdb.cursors.DictCursor,
            use_unicode=True,
        )
        dbpool = adbapi.ConnectionPool("MySQLdb", **dbparms)

        return cls(dbpool)

    def process_item(self, item, spider):
        #使用twisted将mysql插入变成异步执行
        query = self.dbpool.runInteraction(self.do_insert, item)
        query.addErrback(self.handle_error, item, spider) #处理异常

    def handle_error(self, failure, item, spider):
        #处理异步插入的异常
        print (failure)

    def do_insert(self, cursor, item):
        #执行具体的插入
        #根据不同的item 构建不同的sql语句并插入到mysql中
        insert_sql, params = item.get_insert_sql()
        cursor.execute(insert_sql, params)
调用scrapy提供的json export导出json文件
class JsonExporterPipleline(object):
    #调用scrapy提供的json export导出json文件
    def __init__(self):
        self.file = open('articleexport.json', 'wb')
        self.exporter = JsonItemExporter(self.file, encoding="utf-8", ensure_ascii=False)
        self.exporter.start_exporting()

    def close_spider(self, spider):
        self.exporter.finish_exporting()
        self.file.close()

    def process_item(self, item, spider):
        self.exporter.export_item(item)
        return item
保存图片
class ArticleImagePipeline(ImagesPipeline):
    def item_completed(self, results, item, info):
        if "front_image_url" in item:
            for ok, value in results:
                image_file_path = value["path"]
            item["front_image_path"] = image_file_path

        return item
将数据写入到es中
class ElasticsearchPipeline(object):
    #将数据写入到es中

    def process_item(self, item, spider):
        #将item转换为es的数据
        item.save_to_es()

        return item
settings.py配置
UA?
USER_AGENT = "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36"中间件
settings
DOWNLOADER_MIDDLEWARES = {
   #'douban250.middlewares.RandomProxyMiddleware': 543,
   'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': 2,
}
middleware
# 随机UA
class RandomUserAgentMiddlware(object):
    #随机更换user-agent
    def __init__(self, crawler):
        super(RandomUserAgentMiddlware, self).__init__()
        self.ua = UserAgent()
        self.ua_type = crawler.settings.get("RANDOM_UA_TYPE", "random")

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler)

    def process_request(self, request, spider):
        def get_ua():
            return getattr(self.ua, self.ua_type)

        request.headers.setdefault('User-Agent', get_ua())
遵循robots.txt协议?
ROBOTSTXT_OBEY = False下载延时?
DOWNLOAD_DELAY = 10
RANDOMIZE_DOWNLOAD_DELAY = True
使用cookies?
COOKIES_ENABLED = True
COOKIES_DEBUG = True
下载中间件?
DOWNLOADER_MIDDLEWARES = {
    # 'ArticleSpider.middlewares.JSPageMiddleware': 1,
   # 'ArticleSpider.middlewares.RandomUserAgentMiddlware': 543,
    'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': 2,
}
管道选用?
ITEM_PIPELINES = {
   # 'ArticleSpider.pipelines.JsonExporterPipleline': 2,
   # # 'scrapy.pipelines.images.ImagesPipeline': 1,
   #  'ArticleSpider.pipelines.ArticleImagePipeline': 1,
   #  'ArticleSpider.pipelines.MysqlTwistedPipline': 1,
    'ArticleSpider.pipelines.ElasticsearchPipeline': 1
}
图片字段名?
IMAGES_URLS_FIELD = "front_image_url"项目目录
project_dir = os.path.abspath(os.path.dirname(__file__))图片下载路径
IMAGES_STORE = os.path.join(project_dir, 'images')mysql
MYSQL_HOST = "127.0.0.1"
MYSQL_DBNAME = "article_spider"
MYSQL_USER = "root"
MYSQL_PASSWORD = "root"
时间格式方式
SQL_DATETIME_FORMAT = "%Y-%m-%d %H:%M:%S"
SQL_DATE_FORMAT = "%Y-%m-%d"