数据预览
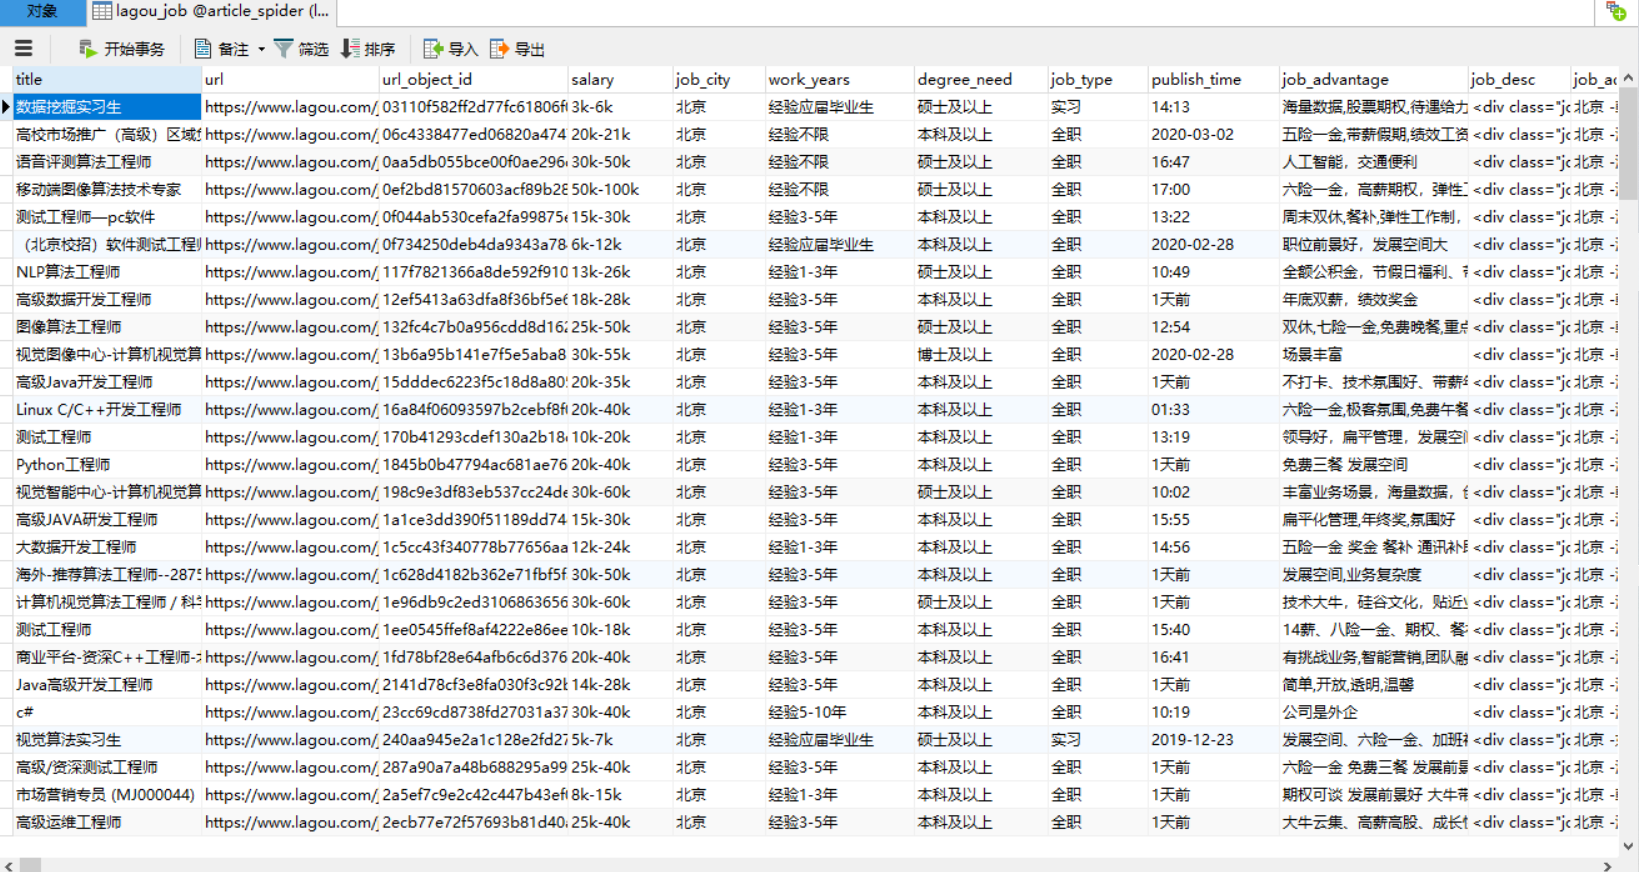
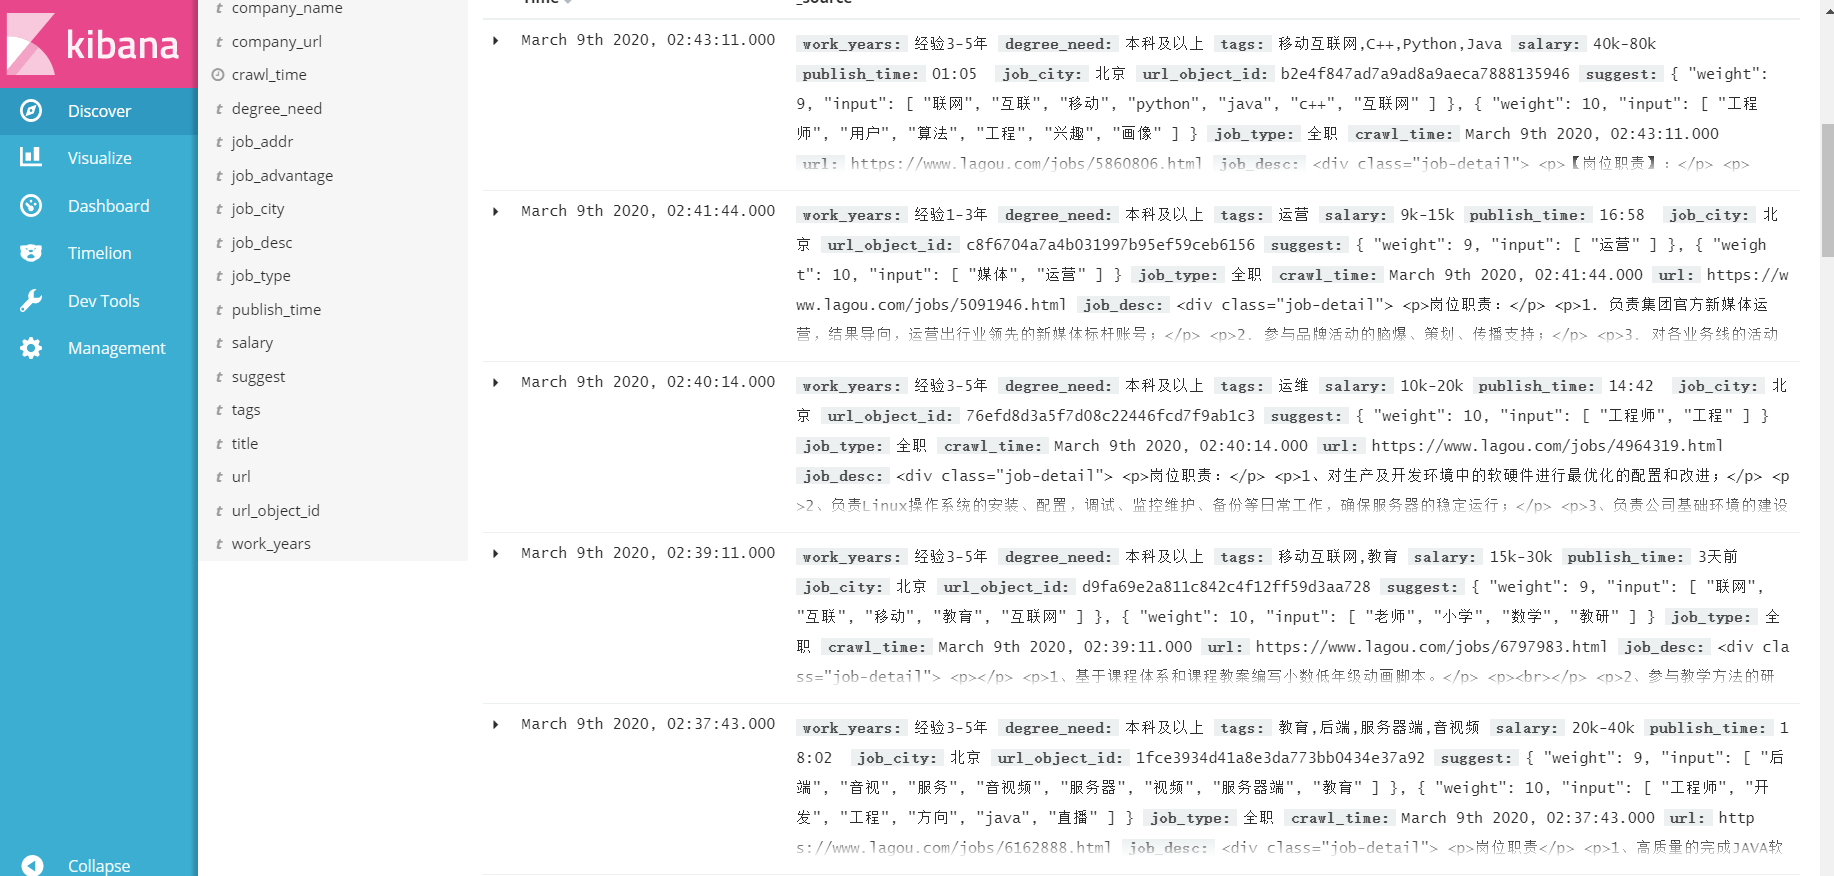
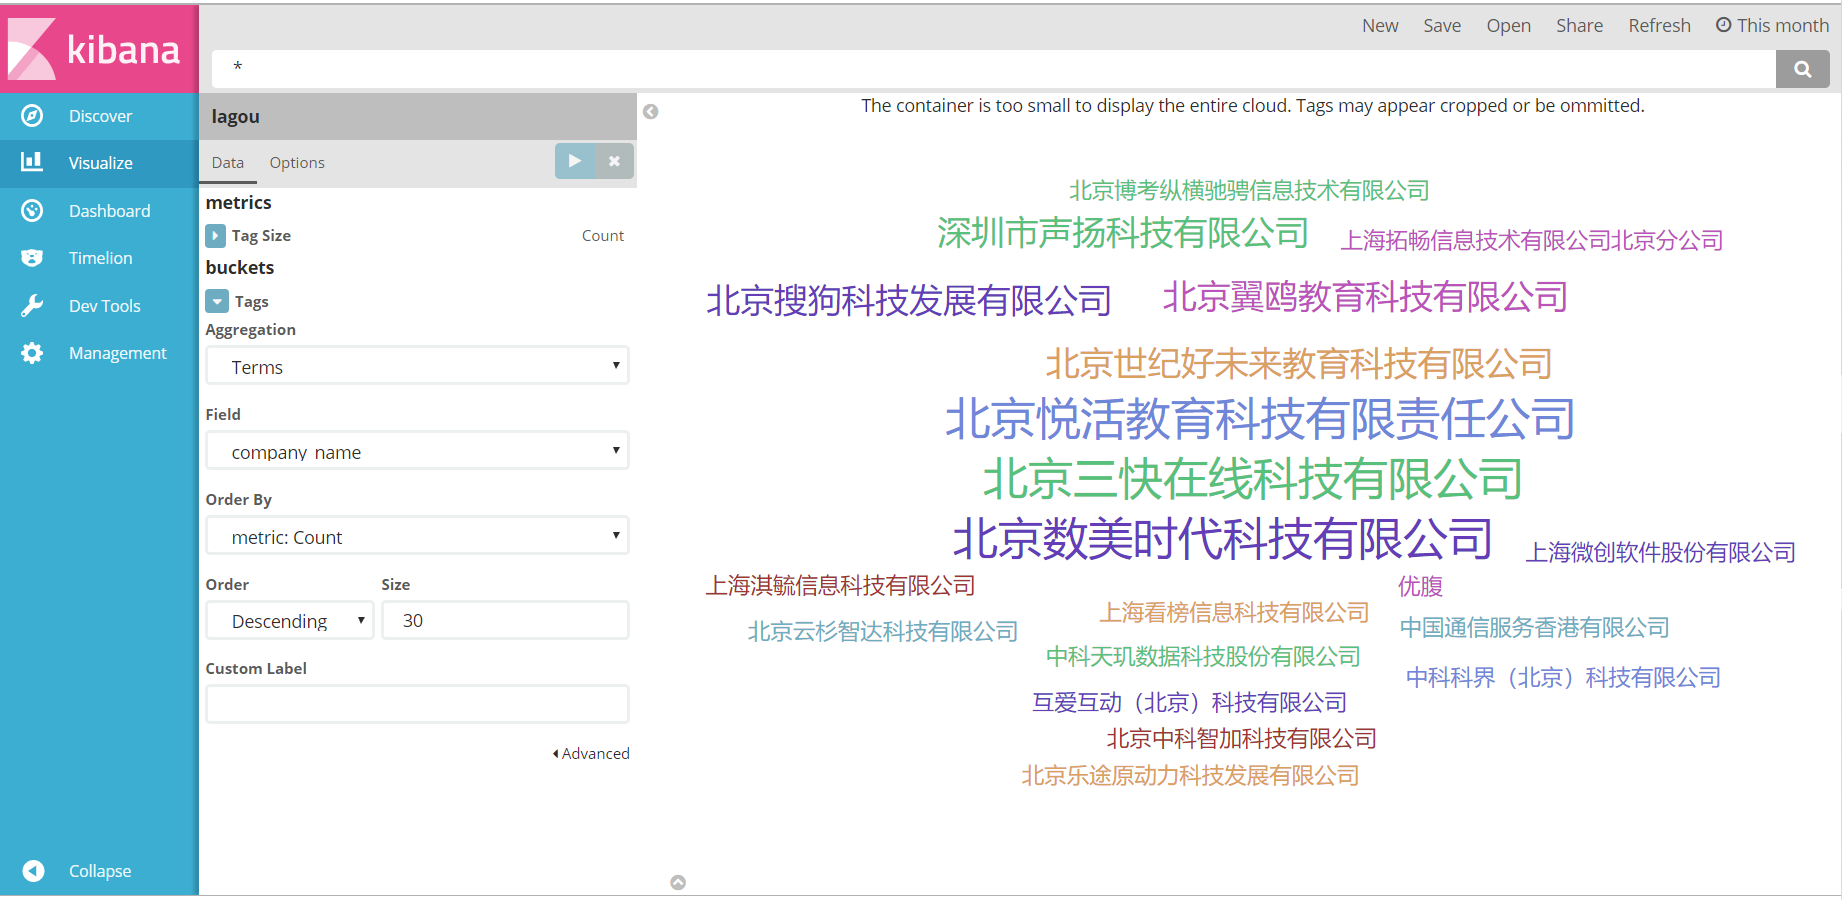
编写lagou.py
文件位于 LagouSpider/spiders/lagou.py
导包
import scrapy
import pickle
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
from ..items import LagouJobItemLoader, LagouJobItem
from LagouSpdier.utils.common import get_md5
from datetime import datetime
from ..settings import BASE_DIR
import os
首先思考我么要爬取哪些位置
可以通过 Rule 来限制我们要爬取的域
class LagouSpider(CrawlSpider):
    name = 'lagou'
    allowed_domains = ['www.lagou.com']
    start_urls = ['https://www.lagou.com/']

    rules = (
        Rule(LinkExtractor(allow='zhaopin/.*'), follow=True),
        Rule(LinkExtractor(allow='zhaopin/jiqishijue/.*'), follow=True),
        Rule(LinkExtractor(allow='zhaopin/shenduxuexi/.*'), follow=True),
        Rule(LinkExtractor(allow='jobs/list_计算机视觉/.*'), follow=True),
        Rule(LinkExtractor(allow='zhaopin/tuxiangchuli/.*'), follow=True),
        Rule(LinkExtractor(allow='zhaopin/Python/.*'), follow=True),
        Rule(LinkExtractor(allow='zhaopin/ziranyuyanchuli/.*'), follow=True),
        Rule(LinkExtractor(allow='zhaopin/tuxiangshibie/.*'), follow=True),
        #Rule(LinkExtractor(allow='gongsi/\d+.html'), follow=True),
        Rule(LinkExtractor(allow=r'jobs/\d+.html'), callback='parse_item', follow=True),
    )
通过chromedriver.exe来获取cookies
爬取拉钩尽量每次带上cookies,于是我们用chromedriver来模拟登陆一次,然后把cookies保存到本地。
def start_requests(self):
        # 去使用selenium模拟登录后拿到cookie交给scrapy的request使用
        # 1、通过selenium模拟登录
        # 从文件中读取cookies
        cookies = []
        if os.path.exists(BASE_DIR + "/cookies/lagou.cookie"):
            cookies = pickle.load(open(BASE_DIR + "/cookies/lagou.cookie", "rb"))

        if not cookies:
            from selenium import webdriver
            browser = webdriver.Chrome(executable_path="C:/chromedriver/80.0.3987.106/chromedriver.exe")
            browser.get("https://passport.lagou.com/login/login.html")
            browser.find_element_by_css_selector(".form_body .input.input_white").send_keys("你的用户名")
            browser.find_element_by_css_selector('.form_body input[type="password"]').send_keys("你的密码")
            browser.find_element_by_css_selector('div[data-view="passwordLogin"] input.btn_lg').click()
            import time
            time.sleep(15)
            cookies = browser.get_cookies()
            # 写入cookie到文件中
            pickle.dump(cookies, open(BASE_DIR + "/cookies/lagou.cookie", "wb"))

        cookie_dict = {}
        for cookie in cookies:
            cookie_dict[cookie["name"]] = cookie["value"]

        for url in self.start_urls:
            yield scrapy.Request(url, dont_filter=True, cookies=cookie_dict)
找到需要爬取的xpath 或者selecter
以下是我需要的内容
def parse_item(self, response):
        if response.status == 302:
            return
        # 解析拉勾网的职位
        item_loader = LagouJobItemLoader(item=LagouJobItem(), response=response)

        item_loader.add_css("title", ".job-name::attr(title)")
        item_loader.add_value("url", response.url)
        item_loader.add_value("url_object_id", get_md5(response.url))
        item_loader.add_css("salary", ".job_request .salary::text")
        item_loader.add_css("job_city", ".job_request > h3 > span:nth-child(2)::text")
        item_loader.add_css("work_years", ".job_request > h3 > span:nth-child(3)::text")
        item_loader.add_css("degree_need", ".job_request > h3 > span:nth-child(4)::text")
        item_loader.add_css("job_type", ".job_request > h3 > span:nth-child(5)::text")

        item_loader.add_css("tags", '.position-label li::text')
        item_loader.add_css("publish_time", ".publish_time::text")
        item_loader.add_css("job_advantage", ".job-advantage p::text")
        item_loader.add_css("job_desc", ".job_bt div")
        item_loader.add_css("job_addr", ".work_addr")
        item_loader.add_css("company_name", "#job_company dt a img::attr(alt)")
        item_loader.add_css("company_url", "#job_company dt a::attr(href)")
        item_loader.add_value("crawl_time", datetime.now())

        job_item = item_loader.load_item()
        return job_item
编写 items.py
导包
import scrapy
from w3lib.html import remove_tags
from scrapy.loader.processors import MapCompose, TakeFirst, Join
from scrapy.loader import ItemLoader
from .settings import SQL_DATETIME_FORMAT,SQL_DATE_FORMAT

from .models.es_types import ArticleType
from elasticsearch_dsl.connections import connections
es = connections.create_connection(ArticleType._doc_type.using)
编写对数据处理的方法
def remove_cn(value):
    #去掉 发布于拉勾网
    return value.replace("发布于拉勾网","")


def handle_jobaddr(value):
    addr_list = value.split("\n")
    addr_list = [item.strip() for item in addr_list if item.strip()!="查看地图"]
    return "".join(addr_list)
自定义itemloader
class LagouJobItemLoader(ItemLoader):
    #自定义itemloader
    default_output_processor = TakeFirst()
编写lagouitem
class LagouJobItem(scrapy.Item):
    #拉勾网职位信息
    title = scrapy.Field()
    url = scrapy.Field()
    url_object_id = scrapy.Field()
    salary = scrapy.Field()
    job_city = scrapy.Field(
        input_processor=MapCompose(remove_splash),
    )
    work_years = scrapy.Field(
        input_processor = MapCompose(remove_splash),
    )
    degree_need = scrapy.Field(
        input_processor = MapCompose(remove_splash),
    )
    job_type = scrapy.Field()
    publish_time = scrapy.Field(
        input_processor=MapCompose(remove_cn),
    )
    job_advantage = scrapy.Field()
    job_desc = scrapy.Field()
    job_addr = scrapy.Field(
        input_processor=MapCompose(remove_tags, handle_jobaddr),
    )
    company_name = scrapy.Field()
    company_url = scrapy.Field()
    # 存在tags为空的情况,需要解决
    tags = scrapy.Field(
        input_processor = Join(",")
    )
    crawl_time = scrapy.Field()

    def get_insert_sql(self):
        insert_sql = """
            insert into lagou_job(title, url, url_object_id, salary, job_city, work_years, degree_need,
            job_type, publish_time, job_advantage, job_desc, job_addr, company_name, company_url,
            tags, crawl_time) VALUES (%s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s)
            ON DUPLICATE KEY UPDATE salary=VALUES(salary), job_desc=VALUES(job_desc)
        """
        params = (
            self.get("title",0), self.get("url",0), self.get("url_object_id",0),
            self.get("salary",0), self.get("job_city",0),
            self.get("work_years",0), self.get("degree_need",0), self.get("job_type",0),
            self.get("publish_time",0), self.get("job_advantage",0), self.get("job_desc",0),
            self.get("job_addr",0), self.get("company_name",0), self.get("company_url",0),
            self.get("tags",0), self["crawl_time"].strftime(SQL_DATETIME_FORMAT),
        )

        return insert_sql, params

    # 用于保存到ElasticSearch  可以不用
    def save_to_es(self):
        article = ArticleType()
        article.title = self.get("title",0)
        article.url =  self.get("url",0)
        article.url_object_id = self.get("url_object_id",0)
        article.salary = self.get("salary",0)
        article.job_city = self.get("job_city",0)
        article.work_years = self.get("work_years",0)
        article.degree_need = self.get("degree_need",0)
        article.job_type = self.get("job_type",0)
        article.publish_time = self.get("publish_time",0)
        article.job_advantage = self.get("job_advantage",0)
        article.job_desc = self.get("job_desc",0)
        article.job_addr = self.get("job_addr",0)
        article.company_name = self.get("company_name",0)
        article.company_url = self.get("company_url",0)
        article.tags =  self.get("tags",0)
        article.crawl_time = self["crawl_time"].strftime(SQL_DATETIME_FORMAT)

        article.suggest = gen_suggests(ArticleType._doc_type.index, ((article.tags, 9), (article.title, 10)))

        article.save()

        #redis_cli.incr("jobbole_count")

        return
ES的方法 (非必须)
def gen_suggests(index, info_tuple):
    # 根据字符串生成搜索建议数组
    used_words = set()
    suggests = []
    for text, weight in info_tuple:
        if text:
            # 调用es的analyze接口分析字符串
            words = es.indices.analyze(index=index, analyzer="ik_max_word", params={'filter': ["lowercase"]}, body=text)
            anylyzed_words = set([r["token"] for r in words["tokens"] if len(r["token"]) > 1])
            new_words = anylyzed_words - used_words
        else:
            new_words = set()

        if new_words:
            suggests.append({"input": list(new_words), "weight": weight})

    return suggests
编写Pipeline.py
导包
import pymysql
from twisted.enterprise import adbapi
mysql管道
class MysqlTwistedPipline(object):
    def __init__(self, dbpool):
        self.dbpool = dbpool

    @classmethod
    def from_settings(cls, settings):
        dbparms = dict(
            host = settings["MYSQL_HOST"],
            db = settings["MYSQL_DBNAME"],
            user = settings["MYSQL_USER"],
            passwd = settings["MYSQL_PASSWORD"],
            charset='utf8',
            cursorclass=pymysql.cursors.DictCursor,
            use_unicode=True,
        )
        dbpool = adbapi.ConnectionPool("pymysql", **dbparms)

        return cls(dbpool)

    def process_item(self, item, spider):
        #使用twisted将mysql插入变成异步执行
        query = self.dbpool.runInteraction(self.do_insert, item)
        query.addErrback(self.handle_error, item, spider) #处理异常

    def handle_error(self, failure, item, spider):
        #处理异步插入的异常
        print (failure)

    def do_insert(self, cursor, item):
        #执行具体的插入
        #根据不同的item 构建不同的sql语句并插入到mysql中
        insert_sql, params = item.get_insert_sql()
        cursor.execute(insert_sql, params)
ES管道(非必须)
class ElasticsearchPipeline(object):
    #将数据写入到es中
    def process_item(self, item, spider):
        #将item转换为es的数据
        item.save_to_es()

        return item
编写中间件 middlwares.py
导包
from scrapy import signals
from fake_useragent import UserAgent
随机UA
class RandomUserAgentMiddlware(object):
    #随机更换user-agent
    def __init__(self, crawler):
        super(RandomUserAgentMiddlware, self).__init__()
        self.ua = UserAgent()
        self.ua_type = crawler.settings.get("RANDOM_UA_TYPE", "random")

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler)

    def process_request(self, request, spider):
        def get_ua():
            return getattr(self.ua, self.ua_type)

        request.headers.setdefault('User-Agent', get_ua())
编写setting.py
# -*- coding: utf-8 -*-


BOT_NAME = 'LagouSpdier'

SPIDER_MODULES = ['LagouSpdier.spiders']
NEWSPIDER_MODULE = 'LagouSpdier.spiders'

ROBOTSTXT_OBEY = False


DOWNLOAD_DELAY = 60
RANDOMIZE_DOWNLOAD_DELAY = True

COOKIES_ENABLED = True

DOWNLOADER_MIDDLEWARES = {
   #'LagouSpdier.middlewares.LagouspdierDownloaderMiddleware': 543,
    'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': 2,
}

ITEM_PIPELINES = {
    'LagouSpdier.pipelines.MysqlTwistedPipline': 2,
    'LagouSpdier.pipelines.ElasticsearchPipeline': 1,
}

import os
import sys
BASE_DIR = os.path.dirname(os.path.abspath(os.path.dirname(__file__)))
sys.path.insert(0,os.path.join(BASE_DIR,'LagouSpider'))

MYSQL_HOST = "127.0.0.1"
MYSQL_DBNAME = "article_spider"
MYSQL_USER = "root"
MYSQL_PASSWORD = "root"

SQL_DATETIME_FORMAT = "%Y-%m-%d %H:%M:%S"
SQL_DATE_FORMAT = "%Y-%m-%d"
编写es_type.py (非必须)
# -*- coding: utf-8 -*-

from datetime import datetime
# elasticsearch_dsl 版本 5.1.0
from elasticsearch_dsl import DocType, Date, Nested, Boolean, \
    analyzer, InnerObjectWrapper, Completion, Keyword, Text, Integer

from elasticsearch_dsl.analysis import CustomAnalyzer as _CustomAnalyzer

from elasticsearch_dsl.connections import connections
connections.create_connection(hosts=["localhost"])


class CustomAnalyzer(_CustomAnalyzer):
    def get_analysis_definition(self):
        return {}


ik_analyzer = CustomAnalyzer("ik_max_word", filter=["lowercase"])


class ArticleType(DocType):
    suggest = Completion(analyzer=ik_analyzer)

    # 拉勾网职位信息
    title = Text(analyzer="ik_max_word")
    url = Keyword()
    url_object_id = Keyword()
    salary = Keyword()
    job_city = Keyword()
    work_years = Keyword()
    degree_need = Keyword()
    job_type = Keyword()
    publish_time = Keyword()
    job_advantage = Text(analyzer="ik_max_word")
    job_desc = Text(analyzer="ik_max_word")
    job_addr = Text(analyzer="ik_max_word")
    company_name = Keyword()
    company_url = Keyword()
    tags = Text(analyzer="ik_max_word")
    crawl_time = Date()

    class Meta:
        index = "lagou"
        doc_type = "jobs"


if __name__ == "__main__":
    ArticleType.init()
运行
先debug main.py
# _*_ coding: utf-8 _*_

from scrapy.cmdline import execute

import sys
import os

print(os.path.dirname(os.path.abspath(__file__)))  # 打印目录
sys.path.append(os.path.dirname(os.path.abspath(__file__)))  # 寻找项目工程目录
execute(["scrapy", "crawl", "lagou"])