最近学习了一套 Agent 评测体系的完整框架,从思维导图整理成这篇笔记。它回答了一个很现实的问题:当 Agent 从 Demo 走向生产,我们拿什么保证它"既聪明又稳定"?
传统测试那一套在这里几乎失效——Agent 不是"输入 A 必然输出 B"的函数,而是一条概率性、多步、依赖上下文的执行轨迹。这篇笔记沿着"为什么要评 → 怎么可观测 → 离线怎么保 → 线上怎么兜"的主线,把这些年做质量保障的经验和这套体系对照着梳理一遍。
一、痛点:为什么 Agent 越迭代越让人心慌
1. 迭代后的效果退化:牵一发而动全身
- 共享上下文:Prompt、工具集、记忆系统全局复用,改一处 Prompt 可能影响所有场景
- 概率性路由:LLM 动态决策,没有硬性接口边界,"这个 case 走哪条路径"不可静态推导
- 回归灾难:优化场景 A,意外破坏场景 B/C——修复 1 个 Bug,引入 2 个新 Bug
这是 Agent 与传统软件最本质的差异:传统服务有清晰的接口契约,Agent 的行为边界是模糊的、涌现的。
2. 监控盲区:指标正常 ≠ 行为正确
- 传统监控失效:RT、成功率只反映"服务存活",不反映"做得对不对"
- 语义层失控:Agent 可以"一本正经地胡说八道",接口全 200
- 隐蔽性风险:基础指标全绿,业务逻辑已经严重偏离
一句话:服务没挂,但 Agent 做错了什么? 这是监控盲区最典型的形态——可用性指标回答不了"质量"问题。
二、体系核心:把"好不好、稳不稳"变成工程问题
整套体系围绕四个目标展开:
| 目标 | 含义 |
|---|---|
| 可观测性奠基 | 全链路 Trace/Log/Metric 采集,让 Agent"黑盒"执行过程透明化 |
| 度量不确定性 | 建立标准化评价体系,把"体验好坏"转化为可量化、可对比的客观指标 |
| 回归拦截风险 | 构建自动化质量门禁,保证版本变更没有导致显著退化 |
| 线上主动防御 | 实时捕获线上异常,从"被动救火"到"主动干预" |
三、全链路可观测:先让黑盒透明
为什么需要全链路观察
典型 Agent 架构的执行是非确定性的行动轨迹——同一个用户问题,模型可能先查文档、再调工具、再总结,也可能直接回答。要评测这种轨迹,首先得把它完整记录下来。
数据采集的挑战
一个 Agent 用到的服务可能非常多,采集本身就有难度:
- Agent 应用框架碎片化且更新快:LangChain、Dify、Spring AI 等
- 推理执行链路复杂、协议多样:RAG、Function Calling、MCP、A2A
- 更多维度的性能指标:TTFT(首 Token 延迟)、TPOT(每 Token 输出时间)、SSE 流式输出、对话轮次
- 新的数据采集目标:Token 消耗、文本、图片、音频、视频
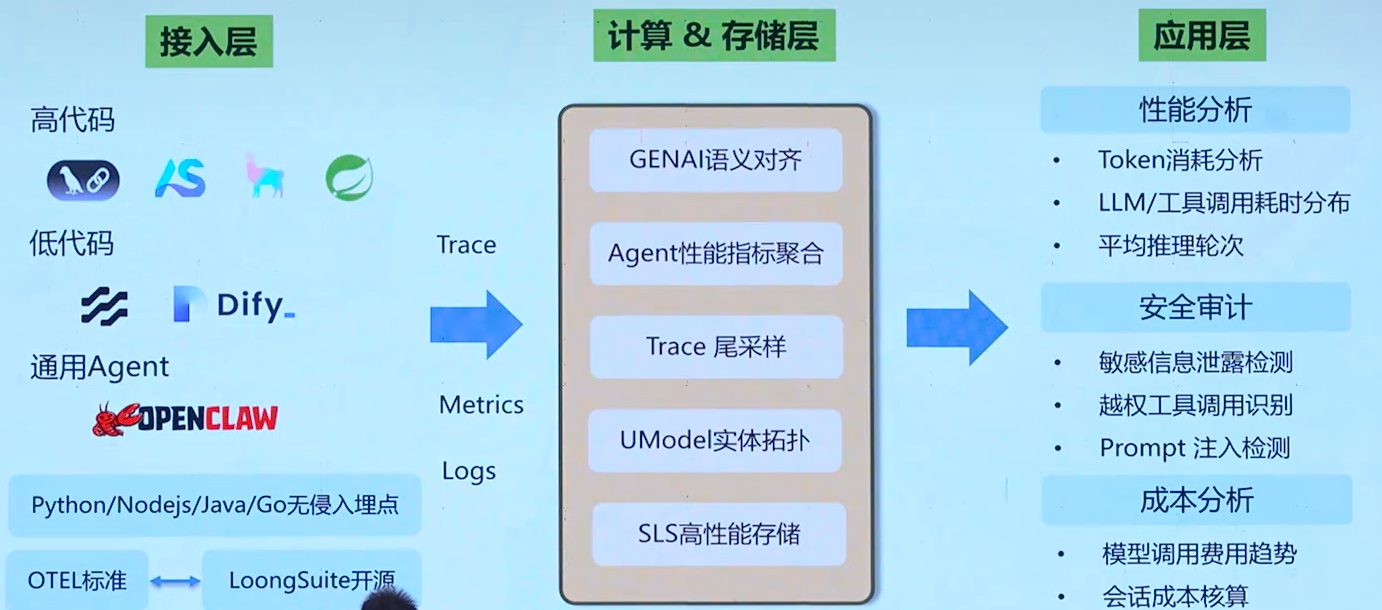
解决方案:无侵入埋点 + 全链路观测
无侵入埋点的分层架构如下:接入层(高代码/低代码/通用 Agent)→ 计算存储层(语义对齐、指标聚合、Trace 采样、实体拓扑)→ 应用层(性能分析/安全审计/成本分析)。
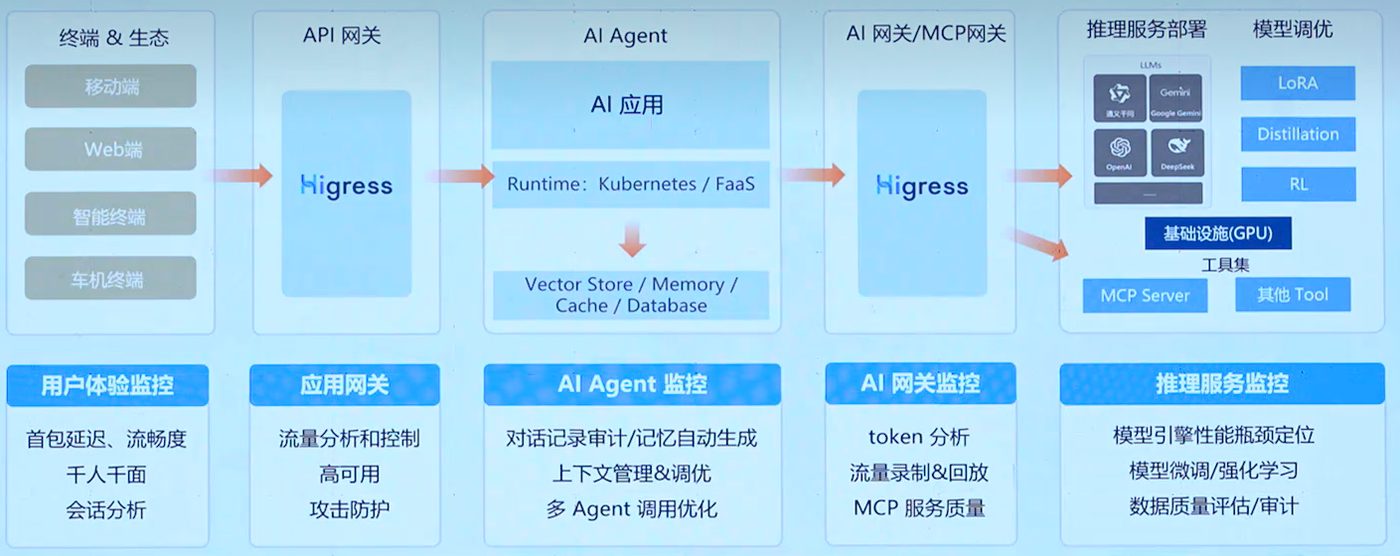
全链路观测能力覆盖从终端到模型推理的每个环节:
落到 Agent 观测视图上,主要看四类数据:
- Token 分析:输入/输出/缓存
- 工具分析:调用量/错误/耗时
- 模型性能分析:TTFT/TPOT/耗时/错误
- 运营分析:用户数/会话数/对话数/会话轮次
四、离线评测:Agent 智力退化的防线
离线评测的核心是把自动化评测嵌入 CI/CD 流水线,用质量门禁拦截回归风险。
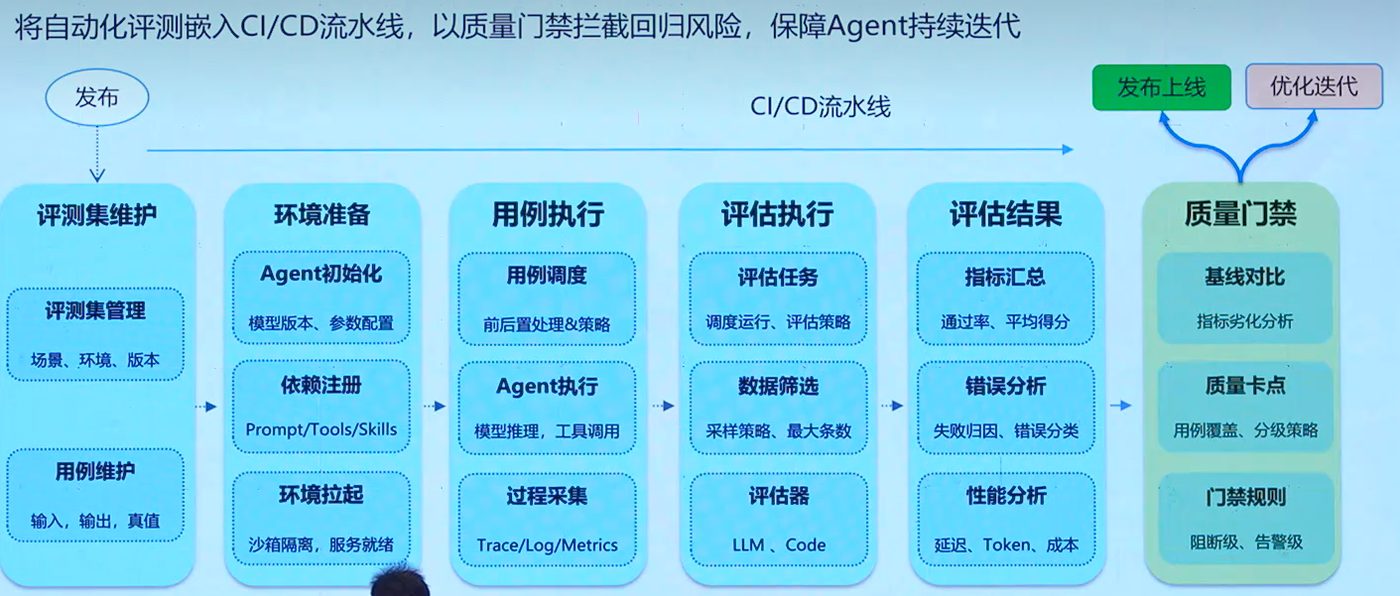
整条流水线是:评测集维护 → 环境准备 → 用例执行 → 评估执行 → 评估结果 → 质量门禁。
评测集怎么维护
一条好的用例包含三部分:
- 任务输入:提问/多轮上下文 + 场景分类标签
- 运行环境配置:状态类型与参数 + Mock 服务
- Ground Truth:期望结果与关键证据 + 必须/禁止调用的工具
评测集的维护形式有两种:类 Excel 工具(低门槛、业务同学可维护)或 Git 仓维护 spec(版本化、可评审)。高质量评测集的三个核心特征:
- 场景覆盖度:对齐线上真实任务分布,核心场景全覆盖
- 环境可复现性:用例绑定环境快照,不依赖实时接口
- 动态更新机制:线上真实 case 脱敏回流,持续补全评测集
仿真环境:保证 Observation/Action 的确定性
评测环境的核心是隔离与可控,用三类手段模拟工具世界:
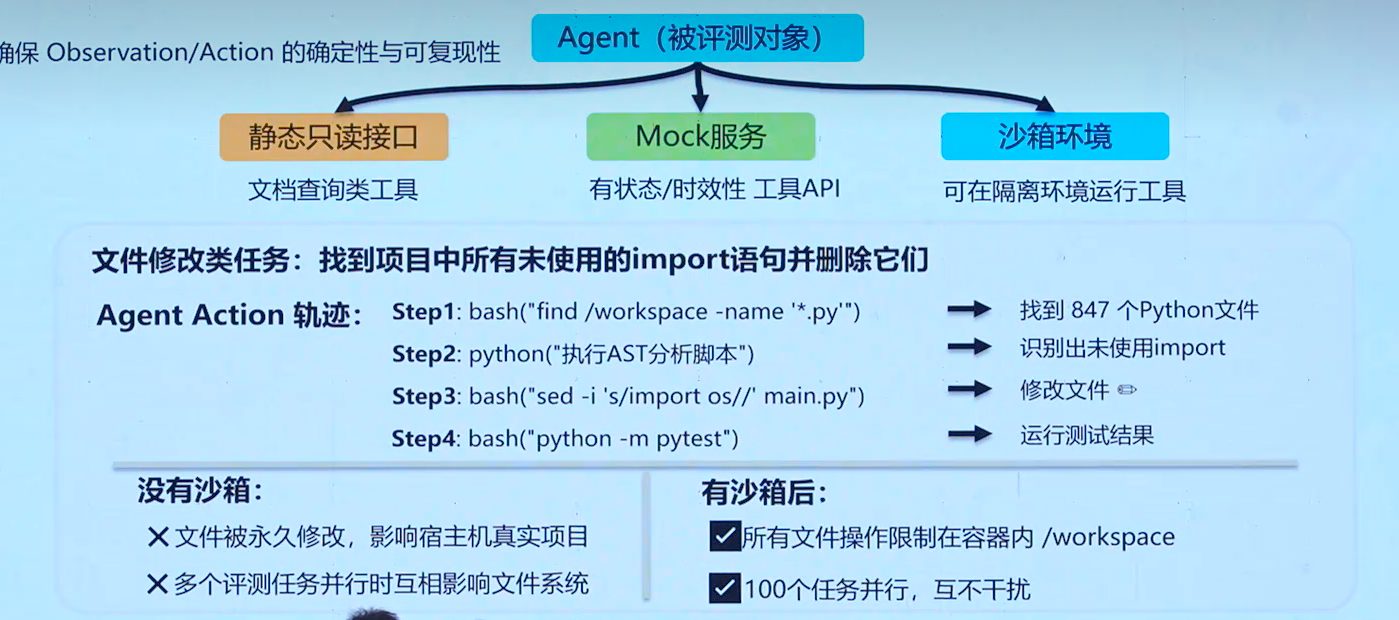
- 静态只读接口:文档查询类工具
- Mock 服务:有状态/时效性的工具 API
- 沙箱环境:可在隔离环境运行的写操作工具
图上那个例子很典型:让 Agent 完成"找到项目里所有未使用的 import 并删除"的写操作任务——没有沙箱时,文件被永久修改、影响宿主机、并行任务互相干扰;有沙箱后,所有文件操作限制在容器内 /workspace,100 个任务并行互不干扰。
评估器类型与质量门禁
评估器分三类:人工评估(最准但最贵)、Code 评估(确定性断言)、LLM/Agent 评估(语义判断,注意校准)。
质量门禁三层:静态扫描 → 自动化评审 → 人工审核。
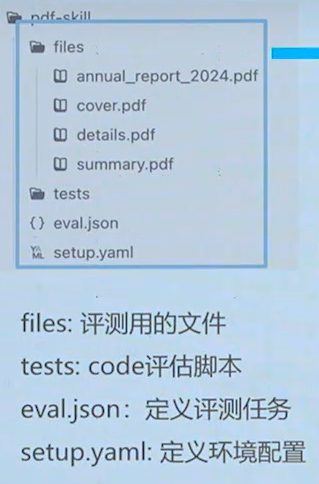
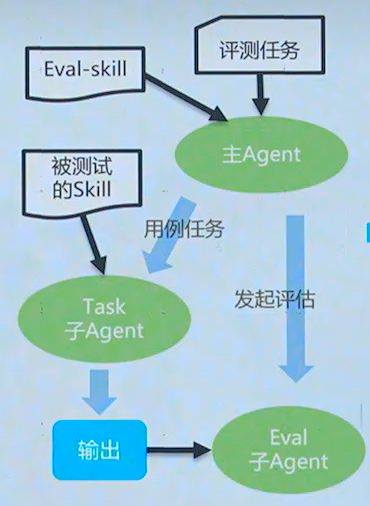
另外,评测能力还可以产品化为Skill 质量仓库,把"用例集准备 → 环境准备(容器 agent 运行环境)→ 评测执行 → 评测结果"做成标准化流程:
五、在线评测:静态评估兜不住的长尾
静态评估的四个局限
- 依赖漂移:第三方 API 升级/限流 → 线上失败
- 长尾输入:任务模糊、多意图 → Agent 运行走偏
- 会话状态累积:Token 超限/记忆冲突 → 能力骤降
- 用例覆盖不足:边界/异常/组合场景 → 盲区频发
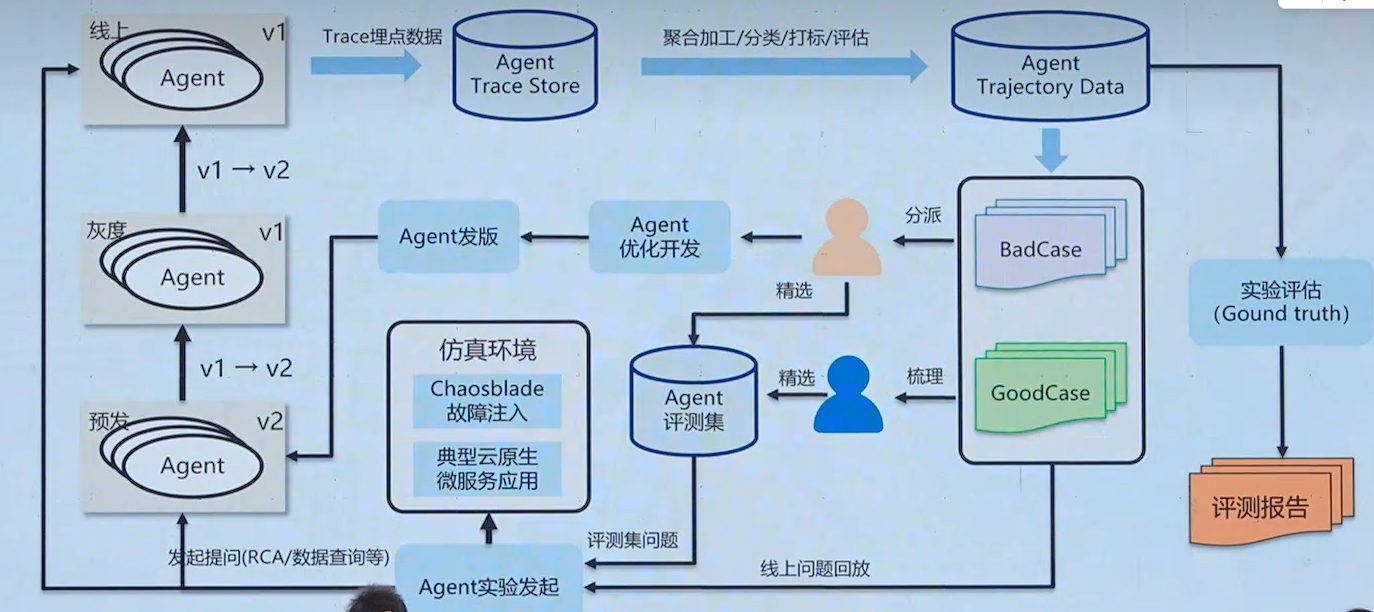
在线加工引擎:把线上 Trace 变成评测数据
核心思路是放大线上真实数据:Agent 应用产生的可观测数据(Trace/Log/Metric)进入高性能加工 Pipeline,经过去噪、场景分类后交给评估器集合,产出加工结果(告警/可视化/分析报告)。
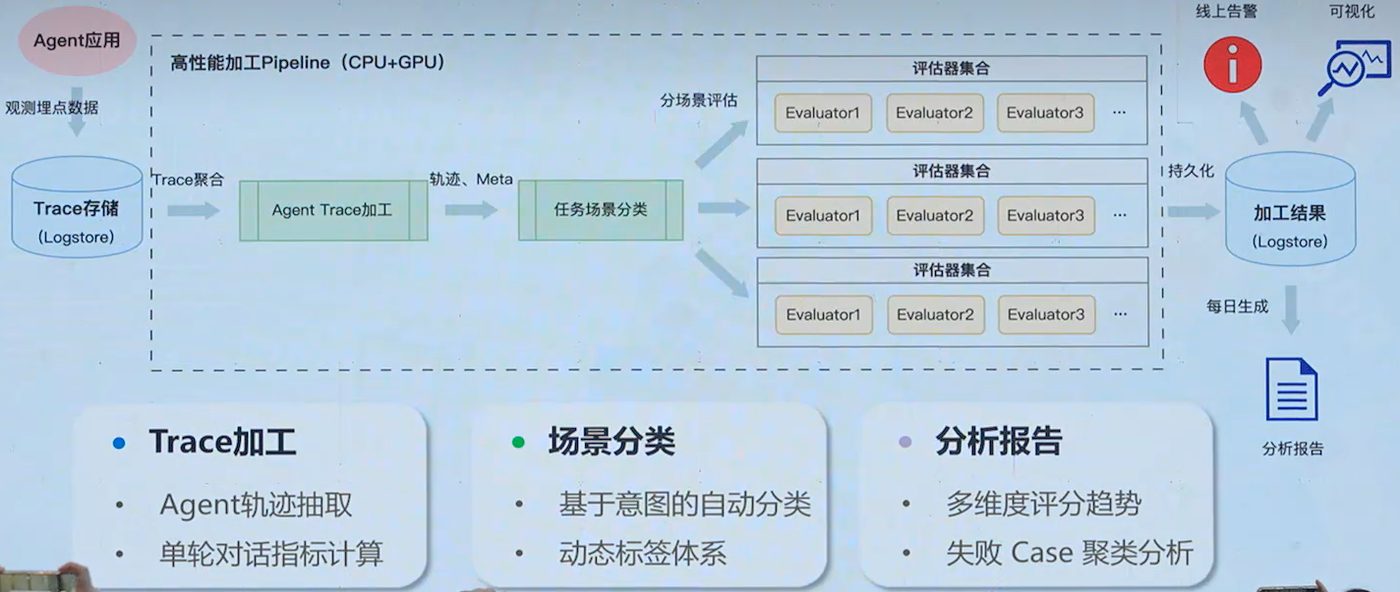
三个关键处理环节:
- Trace 加工:Agent 轨迹抽取、单轮对话指标计算
- 场景分类:基于意图的自动分类、动态标签体系
- 分析报告:多维度评分趋势、失败 Case 聚类分析
数据飞轮与迭代飞轮
在线评测的价值不止于"发现问题",更在于形成正向循环:
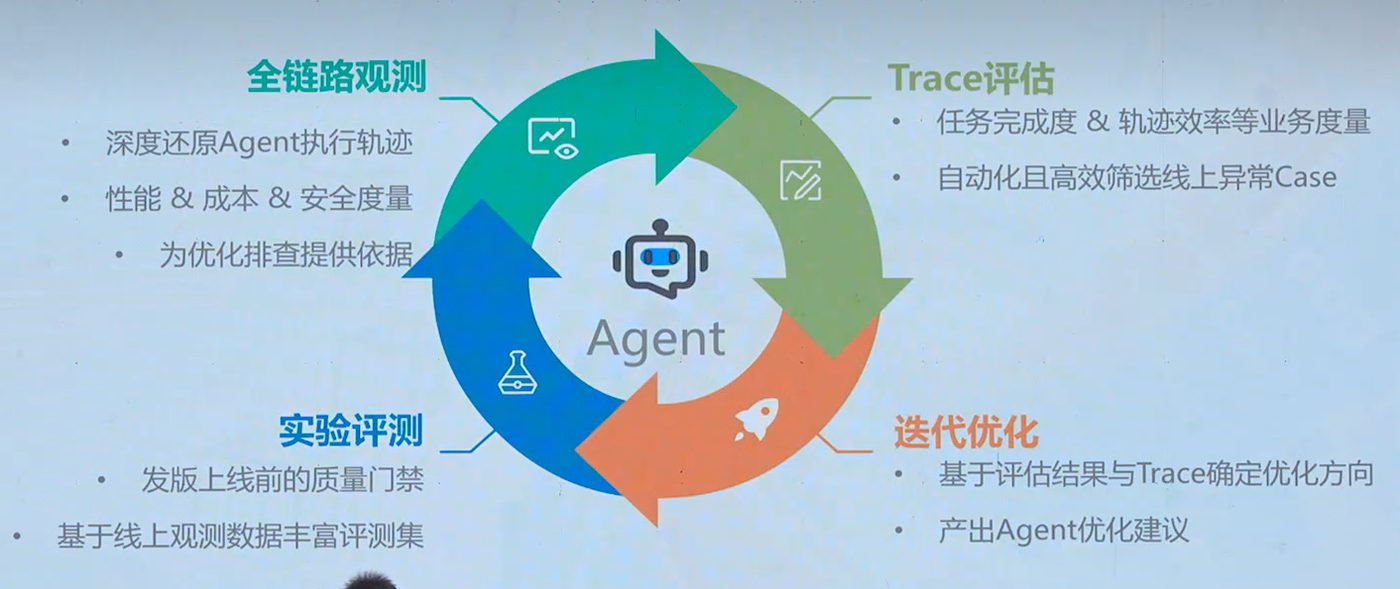
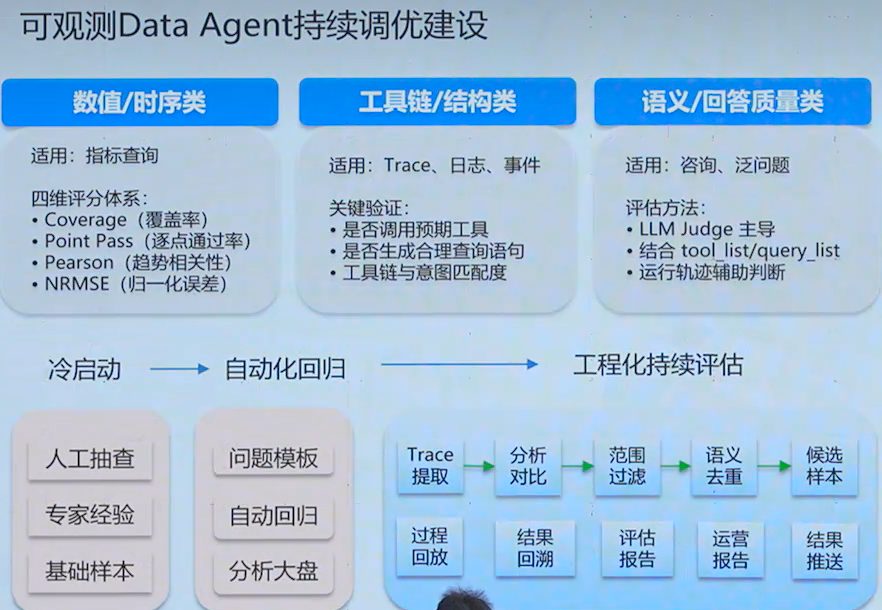
可观测数据还能反哺持续调优:
六、总结:观测 → 评估 → 优化 → 评测 的闭环
- 观测:无侵入埋点 + 后端存算,透视 Agent 执行轨迹
- 评估 & 分析:在线加工引擎 + AI 汇总分析,发现线上问题
- 优化:在线 Trace 抽取经验 + AI 自动调优,驱动 Agent 迭代
- 评测:Dataset + Environment + Evaluator,守住迭代质量
七、我的一点思考
这套体系最有价值的地方,是把"评测"从单点动作变成了体系闭环,其中三点我认为最值得落地时优先投入:
- 评测集是资产,不是脚本:用例 = 输入 + 环境 + Ground Truth,三者缺一不可。没有环境快照的评测集,本质上是"不可复现的基准"。
- 沙箱环境是写操作类 Agent 评测的前提:文件修改、代码执行这类任务,没有沙箱就谈不上并行和可复现。
- 在线评测解决的是"分布漂移",不是"补测试":它的价值在于让线上真实长尾回流成评测数据,而不是把线下用例再跑一遍。
诚如导图里那句总结:基础指标全绿,业务逻辑已严重偏离——这大概是 Agent 质量保障里最贵的一课。可观测解决"看得见",离线评测解决"守得住",在线评测解决"兜得全",三者合起来,才能回答"这个 Agent 到底行不行"。