用 AI 测 AI:如何从 0 设计一个 Agent 智能体评测平台
导读:这篇文章系统讲述如何从零设计一个"用 AI 测 AI"的 Agent 评测平台,覆盖五类用户角色、十大核心模块与"一个 Agent 一个 Project"的架构定位,并给出了从技术选型到 MVP 路径的完整落地参考。最有价值的设计是分层断言体系——L1 请求级(Tool 调用、参数、副作用)、L2 行为级(结构、业务规则)、L3 结果级语义判定,原则是"能不用 LLM 判的就不用 LLM";同时强调 AI Judge 必须配人工校准闭环(与 Golden Set 人工标注的一致率 ≥85% 作为发布门禁)。适合要搭建 Agent 评测/回归体系的测试负责人和资深工程师,也是面试官考察 AI 测试领域认知的好素材。
分类:AI评测 | 标签:Agent、评测平台、LLM、测试
说明:本文基于我们团队自研的 Agent 评测平台的设计与实践整理而成。文中涉及的用例数量、成功率、耗时、成本、Token 等数字均为脱敏示意数据,仅用于说明设计思路,不代表真实业务指标。
一、为什么需要 Agent 评测平台
随着 LLM Agent(智能体)的普及,传统软件测试方法逐渐失效。
传统 Web 系统的执行路径是固定的,可以依靠接口测试、UI 自动化、单元测试等方式验证。而 AI Agent 系统具有以下特点:
- LLM 决策具有概率性
- Prompt 持续变化
- Skill 持续增加
- Planner 持续优化
- Tool Router 持续更新
- 大模型版本频繁切换
这些特点导致一个直接结果:同一个问题,每一次执行路径都可能不同。因此,仅依赖传统自动化测试,无法保证系统质量,需要建立一套新的 Agent Evaluation(智能体评测)体系。
我们的目标是打造一套完整的 Agent 评测平台,帮助企业持续回答这些问题:
- AI 是否真正完成任务?
- Prompt 更新是否导致退化?
- Skill 新增是否影响旧功能?
- Planner 是否规划正确?
- Tool 调用是否正确?
- 多模型切换效果如何?
- 如何快速定位 Agent 失败原因?
产品定位可以概括为一句话:用 AI 测 AI。注意,它不是"自动生成测试用例",而是自动评测整个 Agent 生命周期。
不同角色的关注点各不相同,这决定了平台必须同时服务好五类用户:
| 角色 | 关注点 |
|---|---|
| QA | 回归测试、测试覆盖率、Bug 定位、自动报告 |
| 开发 | Planner 是否正确、Tool 调用日志、参数是否正确、Trace 分析 |
| Prompt 工程师 | Prompt 版本管理、Prompt A/B Test、Prompt Regression |
| 算法工程师 | 模型 Benchmark、Cost、Latency、Accuracy |
| 产品经理 | Task Success Rate、用户完成率、用户失败原因 |
二、平台定位与模块架构
平台的基本定位是:一个 Agent 一个 Project。每个 Agent 拥有独立的测试项目,支持多环境、多模型、多 Prompt 版本、多 Skill 版本的管理与评测。
整体架构如下(图片版,点击可放大):
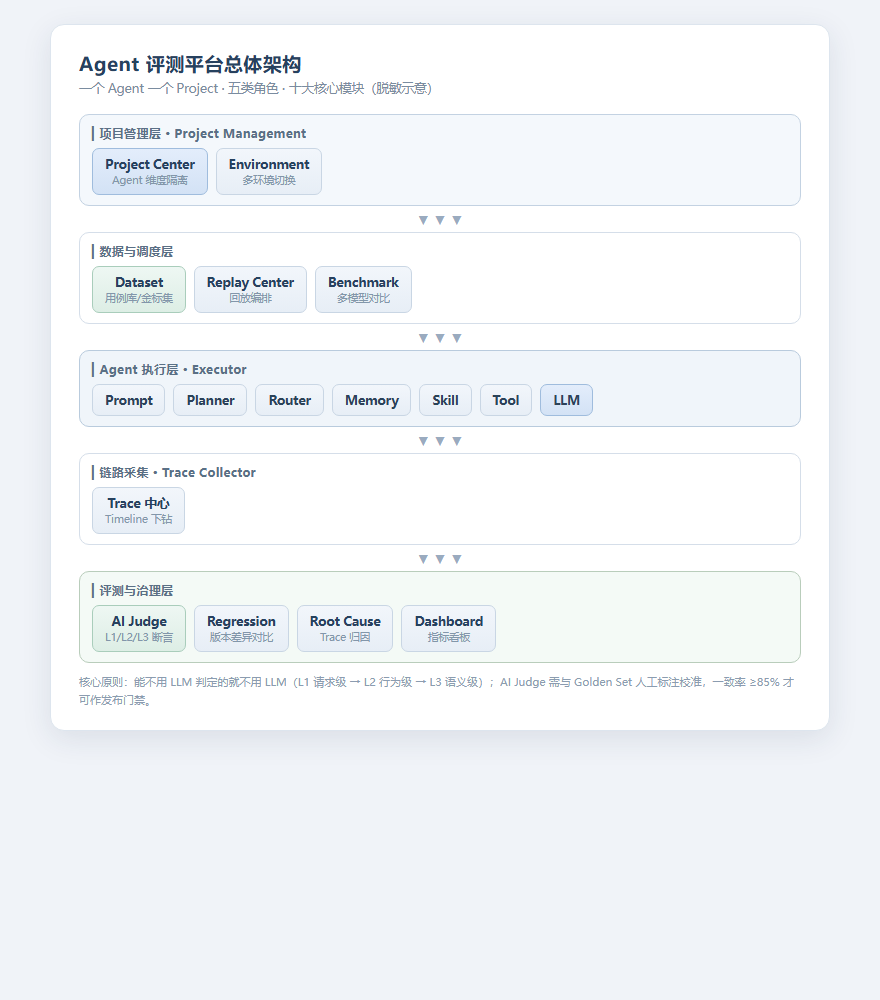
上层是数据与调度(用例库、回放中心、Benchmark),中间是被测 Agent 的执行器(Prompt、Planner、Router、Memory、Skill、Tool、LLM),下层是评测与治理(Trace 采集、AI Judge、回归、根因分析、Dashboard)。
十大核心模块
模块一:项目中心(Project Center) 一个 Agent 一个 Project,例如业务服务 Agent、客服 Agent、销售 Agent、企业知识库 Agent。支持多环境、多模型、多 Prompt 版本、多 Skill 版本。
模块二:用例库(Dataset Center) 整个系统最重要的部分。目标是多来源测试集:线上 Replay、AI 生成、Excel 导入、分类管理。
- 真实用户回放:从线上真实会话取样,自动脱敏后入库。例如「帮我预约明天上午的清洁服务」「取消订单」「我要退款」「开发票」「修改地址」。
- AI 生成:利用 LLM 扩写同一个意图的表达方式。比如一条「我想约清洁服务」,可扩写为「找人上门打扫」「我想约个上门」「明天来收拾一下」等,一条原始意图自动生成 100 个表达,用于覆盖口语化、差异化的说法。
- Excel 导入:支持 Question、Expected Skill、Expected Task、Expected Tool、Expected Result 等列。
- 分类管理:按订单、退款、投诉、优惠券、预约、售后等分类组织。
- 审批入库:AI 生成的用例经人工审批后合并进金标集(Golden Set),确保入库用例质量。
模块三:回放中心(Replay Center)——测试编排与任务调度 选择要测试的版本(例如 Prompt V2),对用例集执行回放(例如 10000 条 Case),自动执行并记录 Task、Planner、Skill、Tool、LLM、Latency、Cost、Success。回放支持同步、异步、定时和 CI/CD 触发。
模块四:Trace 中心 每一次 Agent 执行都会生成一条完整链路:
User → Intent → Planner → Tool → Skill → LLM → Response点击即可查看,支持 Timeline 展示。例如:
Step1  SearchOrder    100ms
  ↓
Step2  CreateOrder    300ms
  ↓
Step3  Coupon         200ms
一眼即可定位问题发生在哪一步。
模块五:AI Judge 这是平台的灵魂,AI 负责做判断。不是字符串匹配,而是语义判断。例如:Case 是「帮我预约明天的清洁服务」,结果 A 回复「已经预约成功。」,结果 B 回复「已经帮您完成预约。」——传统断言会判 Fail,AI 判 Pass。它还能判断 Planner 是否正确、Tool 是否正确、Task 是否完成,输出 PASS / FAIL / WARNING 并说明原因。
模块六:回归中心(Regression Center) 对比不同版本的差异:Prompt V1 vs V2、Skill 变化、模型变化(例如 GPT-5 vs DeepSeek vs Qwen)。输出如 Task Success 从 96% 降到 93%(-3%)时自动高亮告警。
模块七:Benchmark 一个 Case 集,多个 Agent / 模型一起跑,输出成功率、平均响应、Cost、Tool 成功率的排行榜,用于多模型选型。
模块八:Skill 覆盖率 类似代码覆盖率。展示各 Skill 的被测情况:例如某下单 Skill 98%、退款 76%、开票 20%、优惠券 35%(数据已脱敏示意),告诉 QA 哪些 Skill 没人测。
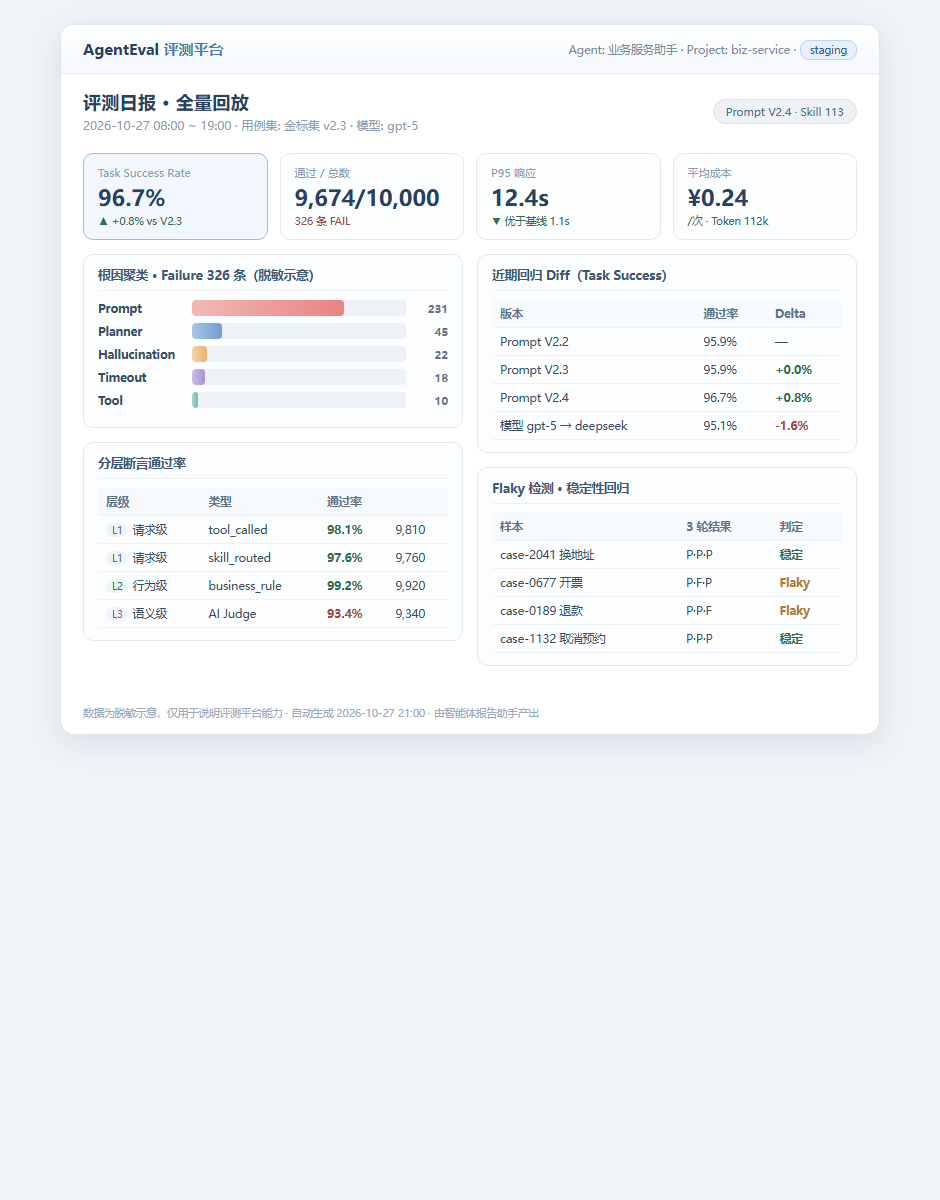
模块九:根因分析(Root Cause AI) 回放 10000 条 Case,失败 326 条(数据已脱敏示意),AI 自动聚类失败原因:Prompt 231、Planner 45、Timeout 18、Hallucination 22、Tool 10(数据已脱敏示意)。点击即可查看具体原因,并自动生成评测日报。
评测日报 Dashboard 示意(同一批数据、脱敏):
模块十:可观测性(Observability) 实时监控 Task Success、Latency、Token、Cost、Planner Error、Tool Error、LLM Error,能力上类似 Grafana。
MVP 落地状态(示意摘要)
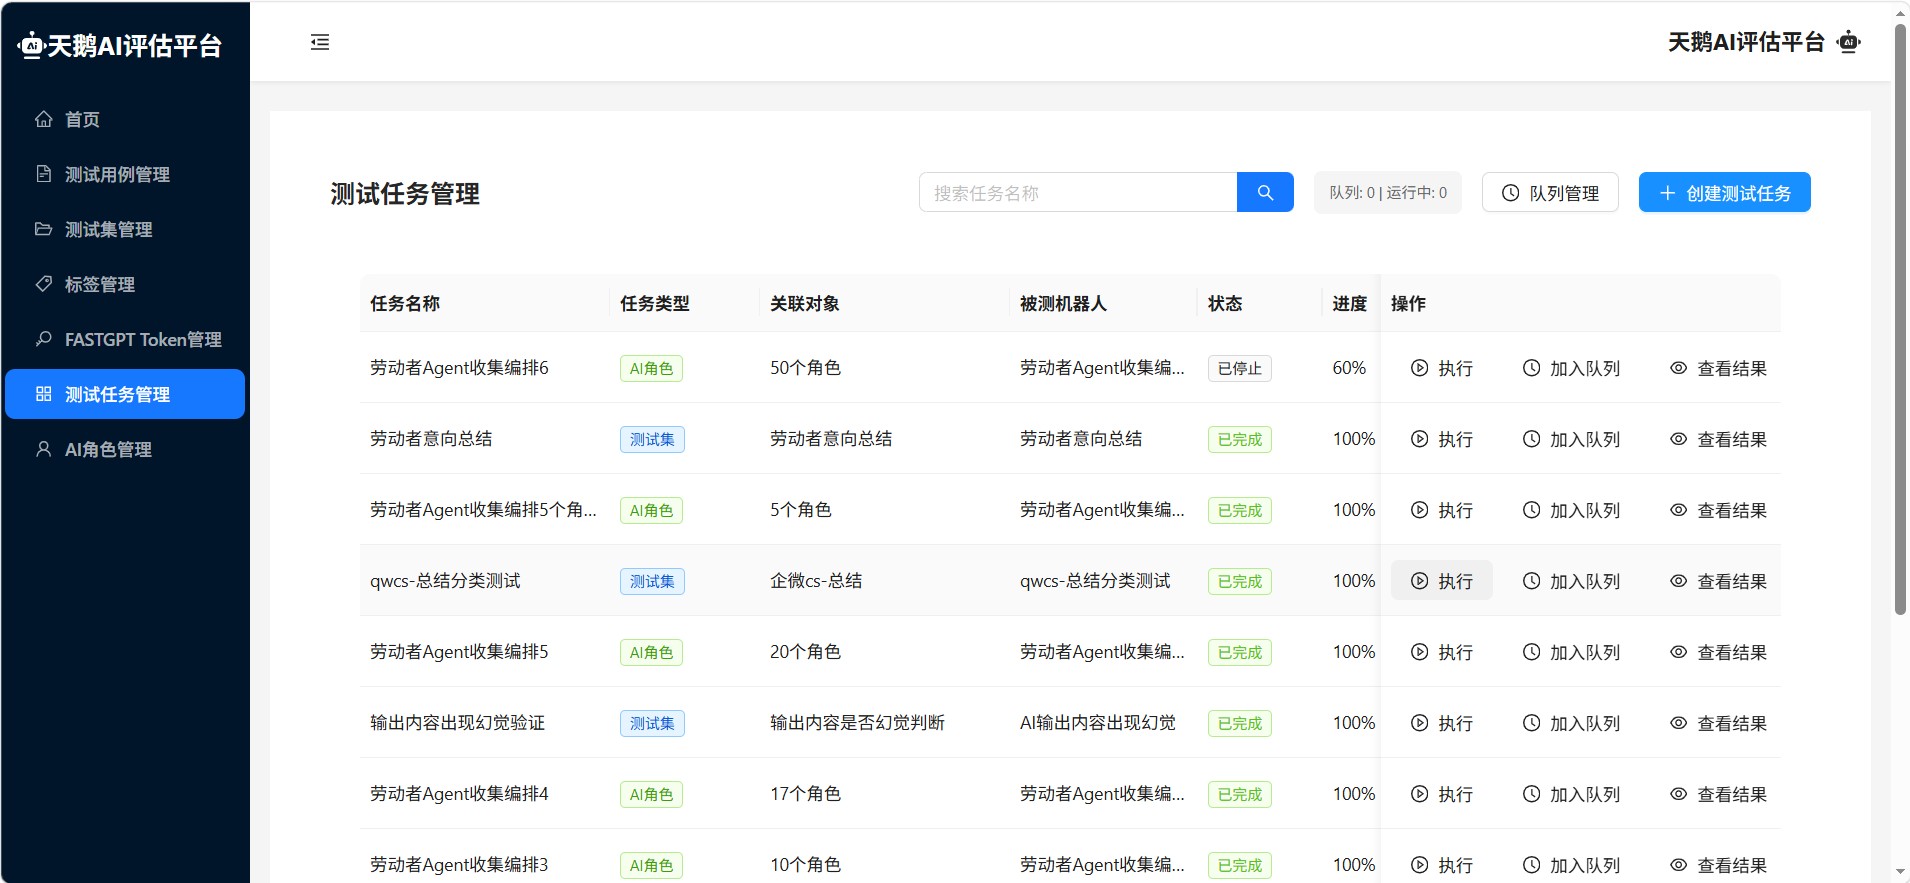
我们第一版 MVP 的落地情况如下(状态为当时节点,供参考):
| 模块 | MVP 状态 | 说明 |
|---|---|---|
| 项目中心 | 部分 | 先用环境变量静态配置 |
| 用例库 | 已落地 | 金标集 + Excel 导入 + CRUD + 审批入库 |
| 回放中心 | 已落地 | CLI + API + 单条重跑 + Test Mission |
| Trace 中心 | 已落地 | Timeline HTML + Dashboard 链接 |
| AI Judge | 已落地 | 以 qwen-max 作为首版 Judge + 人工标注 + 校准工具 |
| 回归中心 | 已落地 | Diff API + Flaky 排除 |
| Dashboard | 已落地 | 多 Tab 可筛选 HTML 报告 |
| 智能测试(V2) | 已交付 | Test Mission V2.1–V2.10 系列能力 |
三、分层断言体系:L1 / L2 / L3
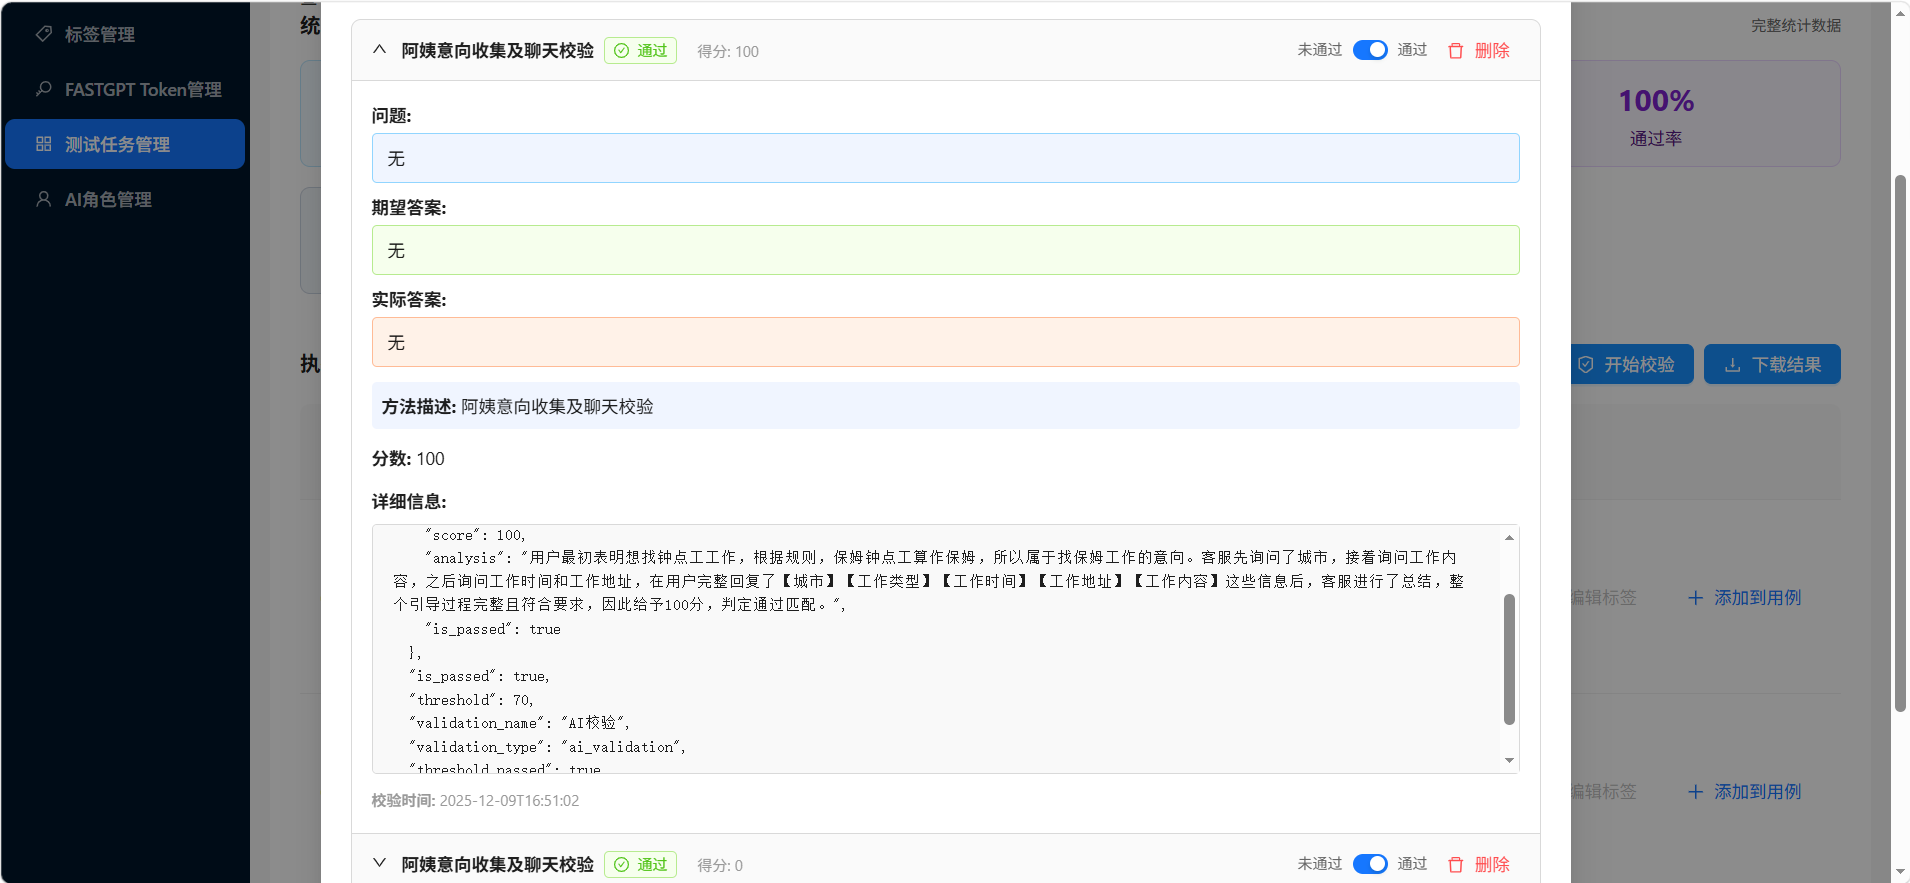
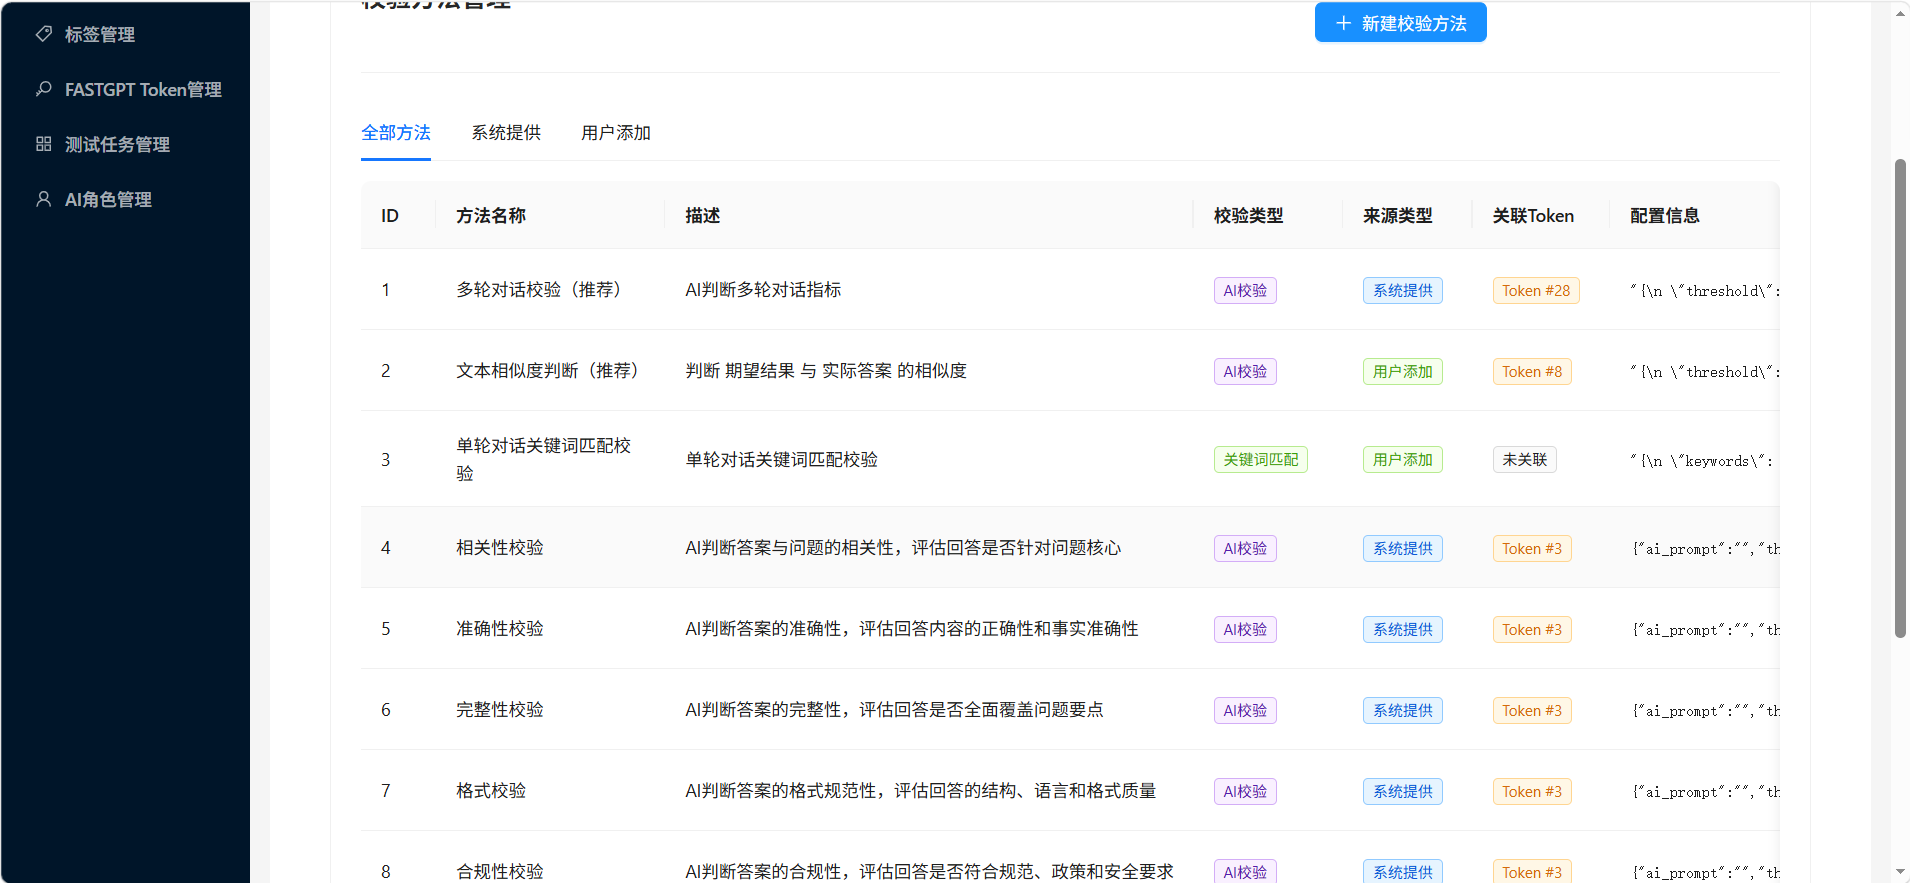
平台最核心的工程设计是分层断言。设计原则是:能不用 LLM 判的,就不用 LLM。断言按可靠性从高到低分为三层,Replay 时逐层执行,任一层 FAIL 则 Case FAIL。
| 层级 | 类型 | 说明 | 示例 |
|---|---|---|---|
| L1(请求级) | tool_called | 是否调用了指定 Tool | 必须调用 create_order |
| L1(请求级) | tool_params | Tool 入参匹配 | service_type == "清洁服务" |
| L1(请求级) | tool_success | Tool 返回成功 | success == true |
| L1(请求级) | skill_routed | 路由到指定 Skill | 必须是 CreateOrder,不能是 QueryOrder |
| L1(请求级) | side_effect | 副作用验证(查库/API) | 订单表新增一条 status=pending |
| L2(行为级) | response_schema | 回复结构校验 | JSON 字段存在且类型正确 |
| L2(行为级) | response_contains | 硬关键词(谨慎使用) | 必须包含订单号格式 ORD\d+ |
| L2(行为级) | business_rule | 业务规则引擎 | 未确认地址前不得调用 create_order |
| L3(结果级) | semantic | AI Judge 语义判定 | 回复表明预约成功且含时间、地址 |
| L3(结果级) | no_hallucination | 反幻觉 | 不得编造不存在的订单号 |
L1 是请求级断言(Tool 是否调用、参数、成功与否、路由、副作用),L2 是行为级断言(回复结构与业务规则),L3 是结果级语义断言(交给 LLM 做语义与反幻觉判定)。绝大多数硬性质量约束应尽量下沉到 L1/L2,只有"语义对不对"这类问题才上 L3。
用例数据模型
单轮 Case 是特例,真实业务场景往往以多轮 + 有状态为主:
case:
  id: "order_booking_001"
  name: "老用户预约-确认默认地址"
  category: "预约"
  type: "multi_turn"              # single_turn | multi_turn | tool_chain
  priority: "P0"                    # P0 | P1 | P2
  tags: ["回归", "下单", "老用户"]

  # 前置上下文(评测平台在 Replay 前注入)
  context:
    user_id: "test_user_001"
    user_profile:
      default_address: "某地址(示例,已脱敏)"
      phone: "138****1234"
    existing_orders: []             # 可选:已有订单列表

  # 对话轮次
  turns:
    - role: user
      content: "帮我约明天上午的清洁服务"
    - role: user
      content: "还是上次那个地址"

  # 断言列表(见分层断言)
  assertions: [...]

  # 元数据
  source: "manual"                  # manual | replay | ai_generated | excel_import
  created_at: "2026-07-01"
  author: "qa_team"
断言配置示例
assertions:
  - level: L1
    type: skill_routed
    expected: "CreateOrder"

  - level: L1
    type: tool_called
    expected: "create_order"

  - level: L1
    type: tool_params
    tool: "create_order"
    params:
      service_type: "清洁服务"
      time_slot: "tomorrow_morning"

  - level: L1
    type: side_effect
    check: "order_created"
    expected:
      status: "pending"
      service_type: "清洁服务"

  - level: L3
    type: semantic
    target: final_response
    criteria: "明确告知用户预约成功,包含服务类型、预约时间和地址"
Excel 导入字段
| 列名 | 必填 | 说明 |
|---|---|---|
| case_id | 否 | 为空则自动生成 |
| name | 是 | 用例名称 |
| category | 是 | 分类(预约/退款/查单…) |
| type | 是 | single_turn / multi_turn |
| priority | 否 | P0/P1/P2,默认 P1 |
| turns | 是 | 多轮用 | 分隔,如 用户句1|用户句2 |
| context_json | 否 | 前置上下文 JSON 字符串 |
| assertions_json | 是 | 断言列表 JSON 字符串 |
| tags | 否 | 逗号分隔 |
两个实战经验(强烈建议先读)
经验一:部分接入方式下 skill_routed 容易误杀,默认只断言 tool_called。 在工具直连(MCP 直连)模式下,运行时往往只能观测到"调用了哪个工具",观测不到"路由到了哪个 Skill"。此时 skill_routed 断言经常拿不到证据,导致本应通过的执行被判 FAIL(误杀)。我们的做法是:默认只为每条 Skill 生成 tool_called 断言(按工具名前缀匹配),skill_routed 仅在 Trace 能提供明确路由证据(如存在技能视图节点)时才启用。
经验二:记忆按 user 持久化会导致二次跑"假 FAIL",需要 fresh_user 隔离。 记忆模块(如 mem0)默认按 user 持久化,而不是按 session。同一个 Case 若用固定测试账号连续跑两次:第一次正常走知识检索并 PASS;第二次命中记忆缓存、不再检索知识库,导致"第二次 FAIL(未再检索)"的假失败。我们的解法:每次 Replay 追加随机 user 后缀(fresh_user 强制冷启动),便于反复调试 L1 断言。如果你刻意要测"二次问同样问题走记忆"的场景,应单独建 Case,并把断言改为记忆命中相关或仅 L2 语义断言,而不是知识检索类断言。
四、AI Judge:LLM 做最终判定,但必须有人工校准闭环
AI Judge 是平台核心,也是最大风险点。必须建立可信度体系,不能"用 AI 评 AI"却没有校准。
分层 Judge 策略
Case 执行完成
    │
    ▼
L1/L2 规则断言(确定性,不依赖 LLM)
    │
    ├─ FAIL → 直接 FAIL,记录 failure_type
    │
    ▼ PASS
L3 语义 Judge(LLM)
    │
    ├─ PASS / FAIL / WARNING
    │
    ▼ WARNING 或低置信度
人工复核队列原则只有一句话:能不用 LLM 判的,就不用 LLM。
Judge Prompt 结构
Judge 输入必须包含:
- 用户完整对话(turns)
- Agent 最终回复
- Trace 摘要(调用了哪些 Skill / Tool)
- 该意图类型的 Rubric(成功标准)
- 具体断言 criteria
Judge 输出 Schema:
{
  "verdict": "PASS",
  "confidence": 0.92,
  "failure_type": null,
  "reason": "回复明确确认预约成功,包含时间、服务类型和地址",
  "dimension_scores": {
    "task_completion": 1.0,
    "accuracy": 1.0,
    "no_hallucination": 1.0,
    "policy_compliance": 1.0
  }
}
人工校准流程(Golden Set 门禁闭环)
| 步骤 | 动作 | 频率 |
|---|---|---|
| 1 | 人工标注 100~200 条 Golden Set(含 PASS/FAIL 及 failure_type) | 初始化 |
| 2 | 对 Golden Set 跑 Judge,计算 Judge 与人工一致率 | 每次 Judge Prompt / 模型变更 |
| 3 | 一致率 < 85% 则阻断发布,优化 Judge Prompt | 门禁 |
| 4 | FAIL/WARNING Case 进入人工复核队列 | 每次 Replay |
| 5 | 人工修正结果回写 golden_labels,持续扩充校准集 | 持续 |
Judge 质量指标(MVP 目标,数据已脱敏示意):
| 指标 | 目标 | 说明 |
|---|---|---|
| Judge Accuracy | ≥ 85% | 与 Golden Set 人工标注一致率 |
| Judge Precision (FAIL) | ≥ 80% | 判 FAIL 中真正 FAIL 的比例 |
| Judge 一致性 | ≥ 90% | 同一 Case 跑 3 次 Judge 结果一致的比例 |
| 人工复核率 | ≤ 20% | WARNING + 低置信度进入复核的比例 |
Flaky Case 处理
Agent 有概率性,同一 Case 可能偶发 FAIL:
- 默认每条 Case 执行 1 次(MVP 阶段省成本)
- 可选「稳定性模式」:执行 3 次,2/3 PASS 则 PASS,否则 FAIL
- 连续 3 个 Replay 版本结果不一致的 Case 标记为 Flaky,单独统计,不纳入回归 Delta
按意图分类的 Rubric:同一条「成功」标准不同
同一 Case 的「成功」因意图不同而不同。Judge 与 Dashboard 均按意图类型分别统计:
| 意图类型 | 典型场景 | 成功标准(必须全部满足) | 主要断言层级 |
|---|---|---|---|
| 问答-服务介绍 | 某服务包含哪些项目 | 信息准确、无幻觉、语气得体 | L3 semantic |
| 问答-价格政策 | 退款规则是什么 | 与后台政策一致,不编造规则 | L1 side_effect + L3 |
| 下单-新用户 | 首次预约 | 收集必要信息 → 用户确认 → 订单创建成功 | L1 全套 |
| 下单-老用户 | 使用默认地址下单 | 正确识别老用户 → 确认或直接下单 → 字段正确 | L1 全套 |
| 查单 | 我的订单到哪了 | 返回真实订单,状态、时间准确 | L1 tool + L3 |
| 取消 | 取消明天订单 | 符合取消规则 → 操作成功或明确告知不可取消原因 | L1 + L2 business_rule |
| 退款 | 申请退款 | 符合退款条件 → 走正确流程 | L1 + L2 business_rule |
| 改约/改地址 | 改到下午 | 修改成功或明确失败原因 | L1 side_effect |
| 优惠券 | 有没有优惠 | 正确查询,不编造优惠码 | L1 tool + L3 |
| 投诉 | 服务人员迟到 | 识别投诉意图 → 走投诉流程,不误下单 | L1 skill_routed + L3 |
失败分类(Failure Taxonomy)
失败 Case 必须归类,供根因分析与 Dashboard 使用:
| 失败类型 | 说明 | 示例 |
|---|---|---|
| skill_routing_error | Skill 路由错误 | 「开发票」路由到「下单」 |
| tool_not_called | 应调未调 Tool | 用户确认后未调用 create_order |
| tool_param_error | Tool 参数错误 | 服务类型传成「维修」 |
| tool_execution_error | Tool 执行失败 | 订单系统超时 |
| business_rule_violation | 违反业务规则 | 未确认地址就下单 |
| hallucination | 幻觉 | 编造不存在的订单号 |
| incomplete_task | 任务未完成 | 只问了地址没完成预约 |
| semantic_fail | 语义不达标 | 回复含糊或信息缺失 |
| timeout | 超时 | Agent 或 Tool 超时 |
| planner_error | 规划错误 | 步骤顺序错误或遗漏 |
指标定义
| 指标 | 计算公式 | 说明 |
|---|---|---|
| Task Success Rate | PASS Case 数 / 总 Case 数 | 主指标,按意图分组展示 |
| Tool Success Rate | Tool 调用成功数 / Tool 调用总数 | 区分 Agent 问题 vs 下游问题 |
| Skill Routing Accuracy | Skill 路由正确数 / 有 Expected Skill 的 Case 数 | 路由层质量 |
| L1 Pass Rate | L1 断言通过数 / L1 断言总数 | 硬指标通过率 |
| Regression Delta | 新版本成功率 - 旧版本成功率 | 负数高亮告警 |
五、测试矩阵:多模型 × 多场景
多模型 Benchmark
一个 Case 集,多个模型一起跑,输出如下对比(数值为脱敏示意):
| 模型 | 成功率 | 平均响应 | Cost | Tool 成功率 |
|---|---|---|---|---|
| GPT-5 | — | — | — | — |
| Claude | — | — | — | — |
| DeepSeek | — | — | — | — |
| Qwen | — | — | — | — |
支持排行榜,用于多模型选型与切换前的风险评估。
意图 × 交互形态 × 用户状态矩阵
测试集按 意图 × 交互形态 × 用户状态 构建矩阵,确保覆盖而非堆量:
| 意图 | 单轮 | 多轮 | 有上下文 | 异常/边界输入 |
|---|---|---|---|---|
| 问答-服务介绍 | ✓ | ✓ | ✓ | ✓ 口语/方言 |
| 问答-价格政策 | ✓ | - | ✓ | ✓ 政策边界 |
| 下单-新用户 | ✓ | ✓ | - | ✓ 信息不全 |
| 下单-老用户 | ✓ | ✓ | ✓ | ✓ 改口/反悔 |
| 查单 | ✓ | ✓ | ✓ | ✓ 无订单 |
| 取消 | ✓ | ✓ | ✓ | ✓ 已服务不可取消 |
| 退款 | ✓ | ✓ | ✓ | ✓ 不符合条件 |
| 改约/改地址 | ✓ | ✓ | ✓ | ✓ |
| 优惠券 | ✓ | ✓ | ✓ | ✓ 无可用券 |
| 投诉 | ✓ | ✓ | - | ✓ 情绪表达 |
| 开发票 | ✓ | ✓ | ✓ | ✓ |
| 意图混淆 | ✓ | ✓ | ✓ | ✓ 「取消」vs「退款」 |
Golden Set 构建策略
| 阶段 | 数量 | 来源 | 用途 |
|---|---|---|---|
| Phase 0 | 30 条 | 从金标用例集中筛选 L1/L2 用例 | 联调,验证端到端 |
| Phase 1 | 50~80 条 | 金标 + QA 补 P0 | MVP 回归基线 |
| Phase 2 | 150~200 条 | 全量金标 + oracle 补全 | Judge 校准扩大 |
| Phase 3 | 500+ 条 | + 线上回放脱敏 | 持续回归 |
Golden Set 的基本要求:
- 每条 Case 有人工标注的 expected_verdict 和 failure_type
- P0 Case 占比 ≥ 40%(核心下单、查单、取消、退款)
- 多轮 Case 占比 ≥ 50%
- 至少 10 条「反幻觉」Case(如查不存在的订单、编造信息)
业务规则硬约束(写入 L2 business_rule,不依赖 Judge)
以下规则建议写成确定性断言,而不是交给 LLM 判断:
- 先确认再下单:地址或时间未明确时,不得调用下单单据创建工具
- 禁止幻觉订单:查单工具无结果时,回复不得包含具体订单号
- 政策一致:取消/退款回复与后台规则一致(可对接规则接口校验)
- 意图隔离:投诉、开发票不得路由到下单流程
- 敏感信息:回复中不得泄露完整手机号、身份证(脱敏格式除外)
六、会话回放与 Agent Time Machine(回溯归因)
会话回放(Replay)是 Agent 评测的底座:选择某个版本 → 对用例集执行 → 记录完整执行过程(Task、Planner、Skill、Tool、LLM、Latency、Cost、Success)→ 与历史基线对比。
在此基础上,最具竞争力的杀手级功能是 Agent Time Machine(智能体时光机):
- 保存每一次 Agent 的完整执行快照:Prompt、模型版本、Planner、Skill、Memory、Tool 输入输出,全部落库。
- 任意选择历史版本重新回放:完整复现当时的执行过程。
- 对比两个版本的执行链路差异:不仅比较最终回复,还比较 Planner 步骤、Skill 路由、Tool 参数、耗时、Token、成本。
- AI 自动标注"第一次发生偏差的节点":帮助开发和测试快速定位回归根因。
对 Agent 产品来说,复现问题往往比发现问题更困难。如果这个功能做好,它会成为开发、测试、算法团队每天都会使用的核心能力,也是区别于传统测试平台的关键竞争力。
七、落地建议:技术选型、数据模型与 MVP 路径
技术选型(我们验证过可行的一套)
- Backend:Python + FastAPI + SQLAlchemy + Celery + Redis + PostgreSQL
- AI:LangGraph 编排;OpenAI / DeepSeek / Claude SDK;LiteLLM 统一模型接入;Embedding + Reranker
- Trace:对齐 OpenTelemetry GenAI 语义规范,参考 Langfuse / OpenInference——不要自己重新设计 Trace 格式
- Frontend:React + TypeScript + Ant Design + ReactFlow(执行链路可视化)+ ECharts + Monaco Editor
- Storage:Case、Replay、Trace、Prompt Version、Dataset、Result、Report
数据模型(核心表)
建议从 Day 1 就按实体建模,而不是想到什么加什么。这样后续扩展 A/B Test、CI/CD、线上回放都不需要推翻数据库。
| 表名 | 作用 |
|---|---|
| projects | 项目 |
| agents | Agent 配置 |
| models | 模型配置 |
| prompts | Prompt 版本 |
| skills | Skill 定义 |
| datasets | 测试集 |
| dataset_cases | 测试用例 |
| replay_tasks | 回放任务 |
| replay_results | 回放结果 |
| traces | Trace 主表 |
| trace_steps | Planner/Tool 调用步骤 |
| evaluations | AI Judge 评测结果 |
| benchmarks | Benchmark 结果 |
| reports | 测试报告 |
| environments | 运行环境(dev/staging) |
| case_assertions | 用例断言(与 case 分离) |
| case_context | 用例前置上下文(用户/订单状态) |
| golden_labels | 人工标注(Judge 校准集) |
| judge_results | Judge 明细(含模型、理由、置信度) |
Agent 接入协议(抽象层)
没有接入协议,Replay / Trace / Judge 均无法落地。建议定义抽象请求/响应 Schema,屏蔽各家 Agent 的差异。
请求(评测平台 → Agent):
{
  "session_id": "sess_abc123",
  "user_id": "test_user_001",
  "message": "帮我约明天上午的清洁服务",
  "context": {
    "channel": "eval",
    "env": "staging"
  },
  "metadata": {
    "case_id": "order_booking_001",
    "replay_id": "replay_xyz"
  }
}
响应(Agent → 评测平台):
{
  "session_id": "sess_abc123",
  "response": "好的,请问还是上次那个地址吗?",
  "trace_id": "trace_789",
  "finished": false,
  "tools_called": [
    {
      "name": "tool_order_query",
      "input": {},
      "output": {},
      "latency_ms": 85,
      "success": true
    }
  ],
  "usage": {
    "prompt_tokens": 1200,
    "completion_tokens": 80,
    "total_tokens": 1280
  }
}
关键约定:
- 多轮 Case:每轮 POST 一次,保持相同的 session_id
- finished:由评测平台根据 Case 类型判定,或结合 oracle 语义断言
- Trace:优先从会话消息接口拉取 progress_steps / tool_results
- 环境管理:内部测试环境(默认回归环境)、网关 API 直连(内部测试环境)、生产环境(只读抽样,禁止写操作类 Case)、本地(开发联调);生产环境只允许只读类 Tool(查单、知识检索),下单/退款类 Case 禁止执行
MVP 边界与迭代节奏
MVP 核心约束(建议照抄):
- 只接入一个业务 Agent 的一个测试环境
- Golden Set 80 条,含多轮与 L1/L2/L3 分层断言
- Judge 与人工一致率 ≥ 85% 方可作为回归门禁
- 暂不做 Benchmark、根因聚类、Time Machine 完整版
建议的 4 周迭代拆分:
| Sprint | 目标 | 验收标准 |
|---|---|---|
| Sprint 1 | 实机 Replay + Trace 拉通 | 测试环境单次 Replay 可完成,Trace 可解析 |
| Sprint 2 | L1/L2 断言 + 失败定位 | FAIL Case 可下钻 Trace / failure_type |
| Sprint 3 | Judge + Dashboard + 回归 | 金标集全量可跑、一致率达标、支持版本对比 |
非功能要求(MVP 目标,数据已脱敏示意):
| 类别 | 要求 | MVP 目标 |
|---|---|---|
| 规模 | 单次 Replay 支持 Case 数 | ≥ 200 条/批 |
| 并发 | 并行执行 Case 数 | ≥ 5 并发(可配置) |
| 耗时 | 200 条 P0 Case 全量 Replay | ≤ 30 分钟 |
| 成本 | 单次全量回归 Token 费用 | 可配置上限 + 超预算告警 |
| 可用性 | 平台服务可用性 | ≥ 99%(工作时间) |
| 安全 | 真实用户 Replay 脱敏 | 手机号、地址、姓名、订单号必须脱敏 |
| 权限 | 角色隔离 | QA:读写 Case、触发 Replay;开发:只读 Trace;PM:只读 Dashboard |
| 数据保留 | Trace / Replay 结果 | 至少 90 天 |
| 重试 | Agent/Tool 超时 | 最多重试 2 次,间隔 5s,仍失败记 timeout |
风险与应对
| 风险 | 影响 | 应对 |
|---|---|---|
| Agent 未提供 Trace | 无法定位 Skill/Tool 问题 | MVP 降级:HTTP 响应内嵌 tools_called |
| Judge 一致率低 | 评测结果不可信 | Golden Set 门禁;提高 L1/L2 占比 |
| Agent 不稳定(Flaky) | 回归 Delta 失真 | Flaky 标记;稳定性模式(3 次取 2) |
| Replay 成本过高 | 无法频繁回归 | 并发限制、P0 子集日常跑、全量每周跑 |
| 写操作污染数据 | 测试环境数据混乱 | 专用测试账号 + Mock / 自动清理 |
后续演进路线
- V2 智能测试(已交付摘要):V2.1–V2.2 测试编排与 LLM 生成用例、FAIL 扩 Case;V2.3–V2.4 用例审批入库、Skill 覆盖矩阵、场景矩阵、金标合并策略;V2.5–V2.6 自动化闭环、缺口补测、Webhook 通知;V2.7–V2.10 消息卡片、订阅、日报、定时、多平台通知、静默时段。
- V2 待补:用例库完整版(版本、分类 UI、线上回放)、多环境管理 UI、链路可视化、L1 side_effect 完整实现。
- V3 研发协同:Git 集成、PR 自动评测、CI 集成(每次提交自动触发 Replay)。
- V4 AgentOps:线上真实流量回放、Agent 健康度评分、Planner/Prompt 优化建议、成本优化分析、多 Agent 对比分析。
最容易踩的两个坑(再强调一次)
- skill_routed 在直连模式下易误杀:拿不到路由证据就默认只断言 tool_called,避免假 FAIL。
- 记忆按 user 持久化导致二次跑假 FAIL:用 fresh_user(每次随机 user 后缀)隔离记忆,测记忆场景时单独建 Case。
结语
Agent 评测不是把测试用例喂给 LLM,而是围绕语义正确性 + 行为确定性重建一整套评测体系:用分层断言守住确定性底线,用 AI Judge 承接语义判断,用人工校准闭环保证"AI 测 AI"的结果可信,用回放与 Time Machine 让每一个失败都可复现、可归因。
从我们团队的实际落地来看,这套体系的核心价值在于:它让 Prompt 更新、Skill 新增、模型切换这些高频变化,第一次有了可量化、可回归、可追溯的质量保障。 希望这篇文章能为正在设计 Agent 评测平台的团队提供一条可参照的路径。