Agent 测试分层方案:从 L0 平台自检到 L4 稳定性回归
导读:这篇文章提出了一套 Agent 测试的 L0–L4 分层方案——从 L0 平台自检(先证明测量工具可信)、L1 单 Skill 冒烟、L2 单 Skill 批量放行门禁(L1 通过率 ≥80% 才允许用例入库)、L3 跨 Skill 全量回归对比 baseline,到 L4 稳定性回归筛掉 Flaky,核心理念是把"平台问题"和"Agent 质量问题"分开记账,让每次 FAIL 都能下钻到具体环节。文中还给了两个反复踩出来的实战经验:记忆按用户持久化(如 mem0)会导致二次跑"假 FAIL",需用新会话/fresh_user 隔离;断言强度必须与证据可得性匹配,拿不到路由证据就别开 skill_routed。适合正在给 Agent 建测试体系的测试团队,以及想了解 Agent 质量保障思路的面试官。
分类:AI评测 | 标签:Agent、测试分层、自动化测试
说明:文中涉及的通过率、用例数、耗时等数值均为示意(数据已脱敏),仅保留量级与典型值;涉及内部代号、域名、人员的内容一律做了通用化处理。
为什么 Agent 测试要分层
传统接口测试的套路在 Agent 面前基本失效。Agent 的本质是「LLM + Skill 编排 + Tool 调用」的组合:输出不确定、链路是黑盒、行为会随 Prompt 改版、记忆残留和身份上下文漂移。直接给一个整体通过率,你既无法判断是 Agent 变差了,还是评测工具自己出了问题。
我们踩过最典型的一类坑:平台部署失败、回放断连、断言误杀,全都表现为「用例 FAIL」。如果不分层,这些噪音会全部记到 Agent 头上,定位成本极高。
所以核心思路只有一句话:先把"测量工具"和"被测对象"分开验。评测平台先自检自己(L0),再逐层收敛被测范围——单 Skill 冒烟(L1)、单 Skill 批量(L2)、跨 Skill 全量回归(L3)、稳定性回归(L4),让每一次 FAIL 都能下钻到具体环节。
在测范围与不测范围,一开始就要划清楚:
- Skill 路由:测用户问法是否进入预期流程、是否调用预期 Tool;不测生产环境写操作副作用。
- Tool 调用:测知识库、订单、工商信息等业务 Tool 是否被触发;不测下游接口的业务正确性(只测「是否调用」)。
- 回复质量:用 L2 硬规则 + L3 语义 Judge;不做全量人工逐条评审。
- 多轮/记忆:单轮为主,记忆场景单独建 Case;不测长对话压力与并发用户。
- 身份:覆盖三类受众(下单方 / 业务终端用户 / 匿名);不测前端 UI 交互与渲染。
MVP 阶段明确不做:生产环境写操作回归(改约、下单、支付等)、Root Cause 自动聚类、多模型 Benchmark 榜。
L0–L4:每层测什么、跑什么、门禁是什么
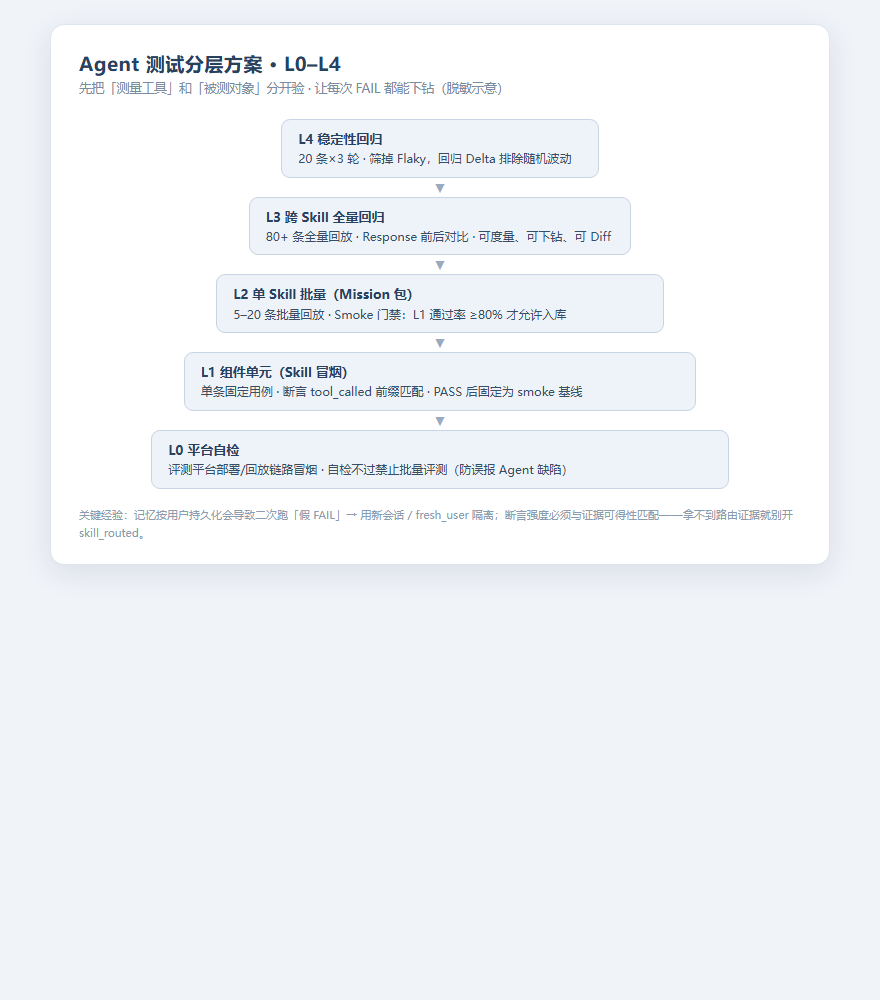
测试分层全景(自底向上收敛,越往下覆盖越广):
L0 平台自检——测评测平台,不是 Agent
- 测什么:评测平台自身部署与回放链路是否正常。
- 跑什么:部署冒烟脚本 / 平台自检(
post_deploy_smoke、verify_platform一类);每次评测平台发版后执行「安全拉取代码 → 重新构建 → 冒烟」。 - 门禁是什么:平台自检不过,禁止任何批量评测,避免把平台故障误报成 Agent 缺陷。
L1 组件单元(Skill 冒烟)——单条用例快速验证
- 测什么:单条固定用例下,Skill 是否被路由到预期 Tool。
- 跑什么:运行时 Skill 列表里「跑这条」,每 Skill 固定 1~2 条 smoke;默认断言
tool_called(Trace 中是否出现预期 Tool,前缀匹配)。 - 门禁是什么:PASS 后固定为该 Skill 的 smoke 基线;Skill 上新或改能力描述文档时,用它做 10~30 分钟(示意)的日常快检。
- 失败处理:「采纳 Trace 工具为 L1」——以 Trace 事实为准对齐期望值,区分「没调 Tool」与「Tool 名不匹配(别名/前缀问题)」。
L2 单 Skill 批量(Mission 包)——放行门禁
- 测什么:单个 Skill 5~20 条用例的批量回放。
- 跑什么:按 Skill 建测试任务,选深度(冒烟/标准/深入)与生成模式后批量回放。
- 门禁是什么:Smoke 门禁——L1 通过率 ≥ 80% 才
smoke_gate_passed=true,用例通过审批(PASS + L1)后才允许合并进平台用例库。 - 用例来源:能力文档示例问法(日常首选)、金标样例克隆、LLM 变体扩覆盖、人工编辑、Trace 采纳。
L3 跨 Skill 全量回归——基线对比
- 测什么:平台用例库 80+ 条(示意)跨 Skill 全量回放。
- 跑什么:全量回放脚本 + 回归对比脚本;Agent 改版(尤其 Prompt / 路由大改)后,用同一条基线做前后 Diff。
- 门禁是什么:产出 baseline,改版前后 Regression Delta 可接受、无新增 P0 级 FAIL。平台验收不要求「业务通过率达标」,只要求可度量、可下钻 Trace、可回归 Diff。
L4 稳定性回归——筛掉 Flaky
- 测什么:20 条(示意)代表性 Case × 3 轮。
- 跑什么:稳定性样本脚本,自动标记 Flaky Case。
- 门禁是什么:Flaky Case 从回归 Delta 中排除,避免把随机波动当成行为回归。
日常 vs 发版的动作节奏(示意)
| 时机 | 推荐动作 | 耗时 |
|---|---|---|
| Skill 上新 / 改能力文档 | 同步 → 进用例库 → 跑这条 → PASS 固定 smoke | 10~30 分钟/Skill |
| Prompt / 路由大改 | Mission smoke → 全量回放 → 回归 Diff | 1~2 小时 |
| 评测平台发版 | 安全拉取 → 重建 → 平台自检 | ~30 分钟 |
| 每周 | 全量或 P0 子集回放 + 报告归档 | 视用例数 |
门禁的落地靠什么断言:L1/L2/L3 与「采纳 Trace」
断言分三层,强度逐级上升:
| 层级 | 类型 | 测什么 | 平台侧含义 |
|---|---|---|---|
| L1 | tool_called |
Trace 中是否出现预期 Tool(前缀匹配) | 是否调了知识库 / 订单等接口 |
| L1 | skill_routed |
是否路由到预期流程 | Skill 选择是否正确 |
| L1 | side_effect |
订单状态变化等副作用 | 当前未实现(需业务侧接口) |
| L2 | business_rule |
硬规则,如「不输出完整手机号」 | 回复合规 |
| L3 | Judge | 语义是否达到金标要求 | 软质量 |
这里有一个我们反复踩出来的关键经验——断言强度必须与证据可得性匹配:
- 运行时 Skill 冒烟默认只开
tool_called。因为通过 MCP 直连时,Trace 里常常观测不到skill_view这类完整路由证据,强行断言skill_routed会大面积误杀(假 FAIL)。 - Test Mission / 金标场景才要求
tool_called + skill_routed,因为它需要完整的路由证据链。 - 拿不到证据的断言,宁可不开,也不要让评测结论被工具能力拖累。
另一个实用动作是「采纳 Trace 工具为 L1」:失败后先看 Trace,把真实的 Tool 调用采纳为期望值再复测。它让 L1 的 expected 与真实行为逐步对齐,而不是靠人肉维护一堆会过期的期望。
记忆与身份隔离实战
mem0 记忆污染导致的「假 FAIL」
mem0 是按用户持久化的开源记忆库(不是按会话)。同一条 Case 用固定账号连跑两次时,会出现非常迷惑的现象:
| 次序 | 常见 Trace | L1 断言(知识库 Tool) |
|---|---|---|
| 第一次 | 技能加载 + 知识库检索 | PASS |
| 第二次 | 技能加载 + 命中记忆 profile | FAIL(未再检索知识库) |
第二次 FAIL 是假 FAIL:不是行为回归,而是 Agent 走了记忆、复用了上次答案。对策分两种情况:
- 默认(调试/冒烟):每次回放自动使用新会话(fresh_user,随机用户后缀),强制冷启动,反复调试 L1 不受记忆干扰。
- 刻意测记忆:单独建 Case,断言改为「命中记忆 profile」或只做 L2 语义判断,绝不再用知识库 Tool 做 L1 断言。
受众与统一身份体系
被测平台的业务终端用户大体分三类,评测身份要跟着受众走(原方案基于各自的统一身份体系,这里做通用化描述):
| 受众 | 典型场景示例 | 回放身份 |
|---|---|---|
| 下单方 | 下单、改约、选人、订单查询 | 下单方专属评测账号 |
| 业务终端用户 | 接单、结算、入行咨询 | 业务终端用户专属评测账号 |
| 匿名 | 工商信息、知识库、合规查询 | 匿名 + 新会话(隔离记忆) |
身份解析优先级按条 Case 独立计算:Case 显式指定账号 → 按受众映射默认评测账号 → 批次级兜底 → 匿名 + 新会话隔离记忆。只要在后台把两类默认账号配好,Mission 与「跑这条」就不需要为每类 Skill 手动切换身份。进阶做法是「智能选号」:按 Skill 的受众画像自动推荐测试账号,复盘时「采纳为默认账号」一键沉淀纠偏,让选号逻辑越用越准。
角色与写操作隔离
- 涉及写操作的 Skill 一律用专用测试账号,不污染共享数据;生产环境只读抽样,禁止写操作 Case。
- 登录凭证仅存放在本地数据目录,严禁提交版本库。
baseline 与回归 Diff:把「行为漂移」变成可量化指标
分层跑通之后,最重要的一件事是建立 baseline。首次全量回放会产出一份基线快照(示意:80 条用例规模),之后所有 Agent 改版都跟它比。
用一个真实踩坑(示意数据)说明为什么基线有用:我们第一版全量基线整体 PASS 率只有个位数。因为分层,我们当时能立刻排除「平台坏了」——L0 自检通过、单条 Trace 可正常下钻;再下钻发现,原因是约六成 Case 的 Agent 根本没调用 Tool 就直答了。问题被精确锁定到路由层,而不是在平台与业务之间的模糊地带里猜。
回归 Diff 的具体做法:Agent 改版(尤其 Prompt / 路由层调整)前后各跑一次全量回放,对比两份结果并排除 Flaky 后输出 Delta;报告页有专门的回归对比入口,以 baseline 为参照。
核心指标建议长期盯这几个:
- Task Success Rate:主 KPI,全量 / Mission 摘要口径。
- L1 Pass Rate:硬指标,Smoke 门禁用。
- Skill Routing Accuracy:路由诊断(金标 Case)。
- Regression Delta:Prompt 改版前后差异。
- Flaky Rate:稳定性筛噪。
- Judge agreement_rate:L3 可信度(目标 ≥85%,示意)。
风险与应对提前写清楚,避免踩坑时临场发挥:
| 风险 | 影响 | 应对 |
|---|---|---|
| Agent 未调 Tool 直答 | L1 大面积 FAIL | 以 Trace 推动路由策略;smoke 用「采纳 Trace」对齐期望 |
| 记忆污染二次跑 | 假 FAIL | 新会话隔离;记忆场景单独建 Case |
| 回放流断连 | ERROR | 客户端断点续传 + 重试 |
| Skill 名 / Tool 别名不一致 | 假 FAIL | 别名表 + 前缀匹配 |
| 写操作污染测试环境 | 数据脏 | 专用测试账号;不写生产 |
落地清单:从零搭起这套分层
如果你也想给自己的 Agent 建测试体系,可以按这个顺序推进:
- L0 先行:把「平台自检」做成发版必跑的部署冒烟,先证明测量工具可信。
- 每个 Skill 固定 1~2 条 smoke(L1):用「跑这条」+ Trace 对齐期望;断言强度匹配证据可得性,没有路由证据就别开
skill_routed。 - 建 Mission 门禁(L2):L1 ≥ 80% 才允许用例入库;临时用例与已入库用例分开,统计只认已入库的,避免列表口径混乱。
- 记忆隔离默认开启:调试走新会话;「测记忆」单独建 Case 换断言。
- 身份体系一次到位:三类受众 + 默认账号 + 匿名隔离;写操作专用账号、凭据不入库。
- 跑一次全量 baseline(L3):存档快照,之后每次 Prompt / 路由改动都做 Diff。
- 上稳定性样本(L4):代表性 Case × 3 轮筛 Flaky,回归告警只盯真实 Delta。
- 明确协作分工:Agent 侧负责 Skill / Tool 命名规范与知识库强制调用策略;评测侧负责运行时 Skill 同步、断言对齐、baseline 与回归 Diff。
最后说回开头那句话:分层不是把测试变复杂,而是把「平台问题」和「Agent 质量问题」分开记账。每一层都有自己的门禁与退出标准,FAIL 永远可以继续下钻到 Trace。当「评测工具自身可信」和「Agent 行为可回归」这两件事都成立时,Agent 的质量数字才有意义——否则你测出来的,不过是一堆无法归因的波动。