分类目录归档:数据分析

中国姓氏排行研究

1、数据清洗、整合

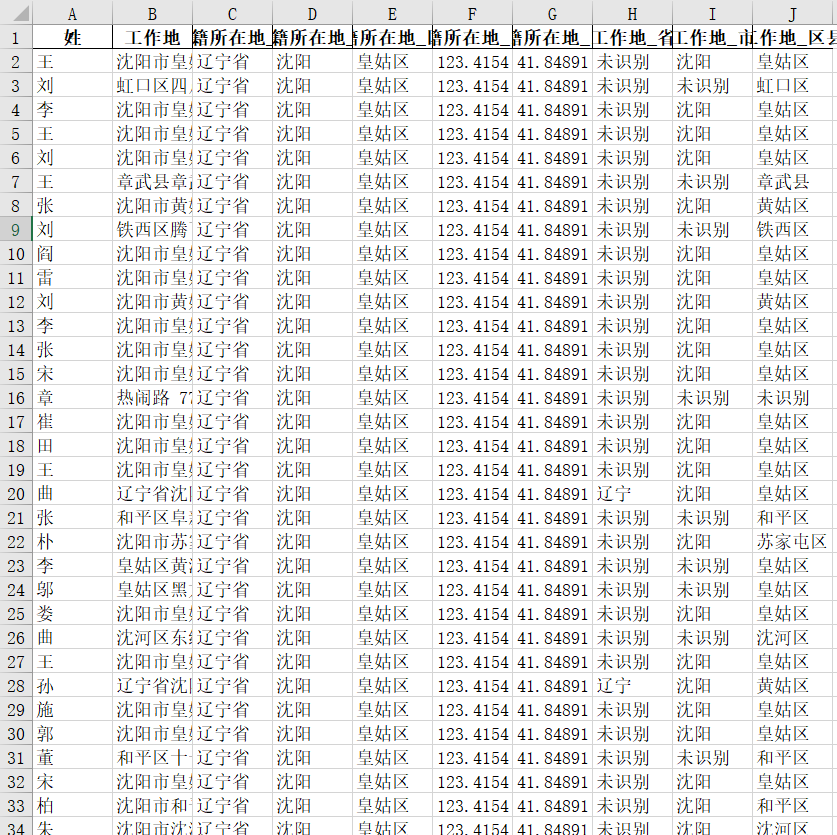
源数据

image

查看数据,数据清洗

# 查看数据,数据清洗

import os
os.chdir('C:/Users/Hjx/Desktop/项目09中国姓氏排行研究/')
# 创建工作路径

df01 = pd.read_csv('data01.csv',encoding = 'utf-8')
df02 = pd.read_csv('data02.csv',encoding = 'utf-8')
df_city = pd.read_excel('中国行政代码对照表.xlsx')
# 读取数据

df = pd.concat([df01,df02])
df = pd.merge
阅读全文 →

社会财富分配问题模拟

1、财富分配模型

构建思路

初始:    产生100个数据,每个数据的值是100
person_n = [x for x in range(1,101)]
fortune = pd.DataFrame([100 for i in range(100)], index = person_n)
fortune.index.name = 'id'
# 设定初始参数:游戏玩家100人,起始资金100元
loss:    每次每行数据损失1
round_r1 = pd.DataFrame({'pre_round':fortune[0],'lost':1})
# 设定第一轮分配财富之前的情况
gain: 

阅读全文 →

电商打折套路分析

已知数据

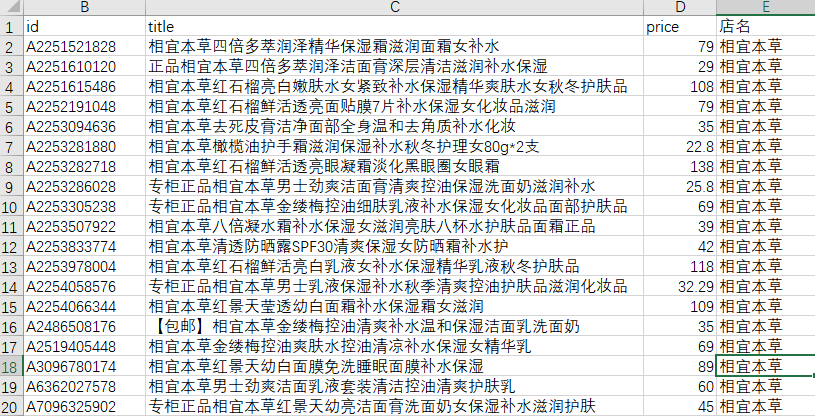
image id(唯一) tittle price 根据时间和价格的差异可以分析出打折情况 品牌名 日期(10天内的数据) 通过日的维度来分析数据 同一件商品 可能很多天都在销售 同一个商品 根据销售时间维度 可以划分出他的销售节奏
1.每个品牌有多少商品参与了双十一?

商品总数、品牌总数,双十一当天参与活动的商品总数?

双十一当天在售的商品占比情况
            按照商品销售节奏分类,我们可以将商品分为7类

阅读全文 →

分析房价影响因素挖掘

1、数据清洗、整合

数据准备

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


import warnings
warnings.filterwarnings('ignore') 
# 不发出警告

from bokeh.io import output_file


from bokeh.plotting import figure,show
from bokeh.models import ColumnDataSource
# 导入图表绘制、图标展示模块
# 导入ColumnDataSourc

阅读全文 →

城市餐饮店铺选址分析

步骤

准备

打开spyder
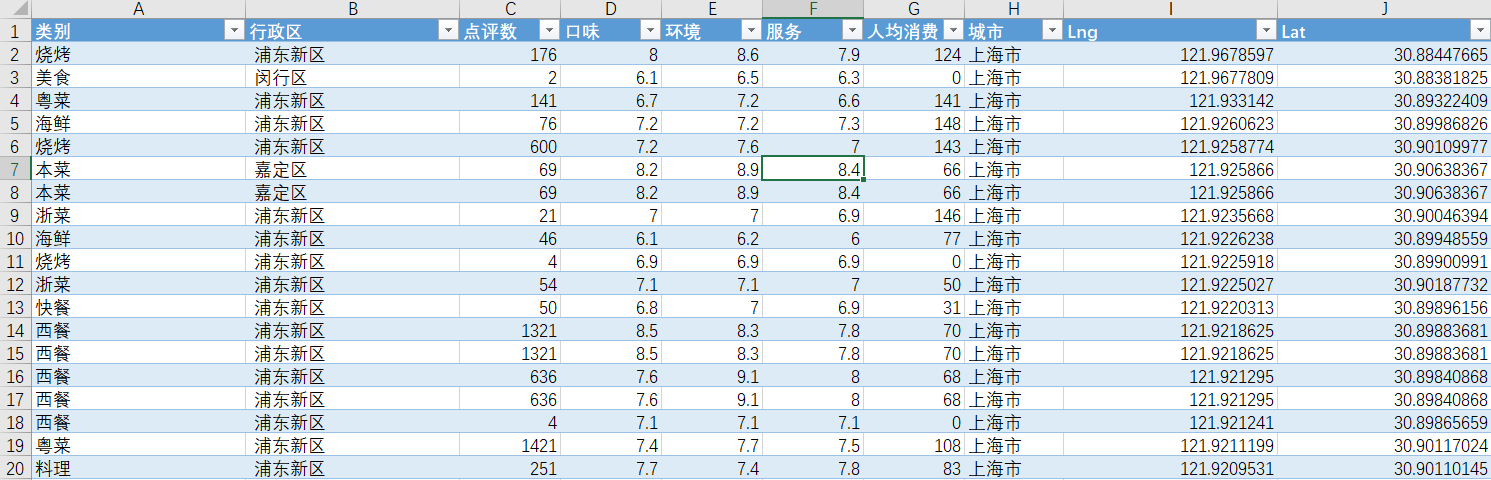
        准备数据

image

查看数据
        分析需求

分析程序

导入模块

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import warnings
warnings.filterwarnings('ignore') 

from bokeh.plotting import figure,show,output_file
from bokeh.models import ColumnDataSource

加载数据

# 加载数据


import os
os

阅读全文 →

数学建模

监督学习

分类

KNN最邻近分类

最邻近分类的python实现方法

在距离空间里,如果一个样本的最接近的k个邻居里,绝大多数属于某个类别,则该样本也属于这个类别
        案例一:电影数据分类
#  案例一:电影数据分类

from sklearn import neighbors  # 导入KNN分类模块
import warnings
warnings.filterwarnings('ignore') 
# 不发出警告

data = pd.DataFrame({'name':['北京遇上西雅图','喜欢你','疯狂动物城','战狼2','力王','敢死队'],
          

阅读全文 →

数据处理

缺失值处理

概念

数据缺失主要包括记录缺失和字段信息缺失等情况,其对数据分析会有较大影响,导致结果不确定性更加显著

判断是否有缺失值数据

isnull:缺失值为True,非缺失值为False
        notnull:缺失值为False,非缺失值为True

删除缺失值 - dropna

填充/替换缺失数据

fillna
        replace
        缺失值插补方法
            (1)均值/中位数/众数插补
            (2)临近值插补
            (3)插值法 —— 拉格朗日插值法
                拉格朗日插值法


阅读全文 →

数据分析方法

分布分析

概念

分析数据的分布情况
      能够快速发现数据分布规律
      研究数据的分布特征和分布类型,分定量数据、定性数据区分基本统计量

步骤

导包
#导包
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
%matplotlib inline

1.读取数据

#数据读取
data=pd.read_csv('E:/Data_analysis/data/深圳罗湖二手房信息.csv',
                 encoding='gbk',engine='python')

2.坐标数

阅读全文 →

Matplotlib基础

Matplotlib简介及图表窗口

简介

Matplotlib → 一个python版的matlab绘图接口,以2D为主,支持python、numpy、pandas基本数据结构,运营高效且有较丰富的图表库

导包

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

图表窗口1 → plt.show()

# 图表窗口1 → plt.show()

plt.plot(np.random.rand(10))
plt.show()
# 直接生成图表

图表窗口2 → 魔法函数,嵌入图表

% matplotlib in

阅读全文 →

pandas基础

介绍

基于Numpy构建,为数据分析而存在
    一位数组series+二维数组dataframe
    可直接读取数据并做处理
    兼容各种数据库
    支持各种分析算法

series

数据结构

Series 是带有标签的一维数组,可以保存任何数据类型(整数,字符串,浮点数,Python对象等),轴标签统称为索引
        s = pd.Series(np.random.rand(5))
            s.index
            s.values
        核心:series相比于ndarray,是一个自带索引index的数组 → 一维数组 + 

阅读全文 →