1、数据清洗、整合
数据准备
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


import warnings
warnings.filterwarnings('ignore')
# 不发出警告

from bokeh.io import output_file


from bokeh.plotting import figure,show
from bokeh.models import ColumnDataSource
# 导入图表绘制、图标展示模块
# 导入ColumnDataSource模块


'''
加载数据
'''

import os
os.chdir('E:\\Data_analysis\\Project\\04\\')
# 创建工作路径

df01 = pd.read_csv('house_rent.csv',encoding = 'gbk')
df02 = pd.read_csv('house_sell2.csv',encoding = 'UTF-8')
# 读取数据
df01.dropna(inplace = True)
df02.dropna(inplace = True)
# 删除缺失值
计算指标
# 计算指标并按照租金、售价汇总
# ① 每平方米建筑面积的月租金
# ② 每平方米建筑面积的房价
# ③ 按照小区做均值分析

df01['rent_area'] = df01['price']/df01['area']
data_rent = df01[['community','rent_area','lng','lat']].groupby(by = 'community').mean()
data_sell = df02[['property_name','average_price','lng','lat']].groupby(by = 'property_name').mean()
data_rent.reset_index(inplace = True)
data_sell.reset_index(inplace = True)
print('租房数据量为%i条' % len(data_rent))
# 查看汇总后的租金
print('售房数据量为%i条' % len(data_sell))
# 查看汇总后的售价
数据整合
# 数据合并

data = pd.merge(data_rent,data_sell,left_on ='community',right_on='property_name')
data = data[['community','rent_area','average_price','lng_x','lat_x']]
data.rename(columns={'average_price':'sell_area', 'lng_x':'lng', 'lat_x':'lat'}, inplace = True)  # 调整列名
print('合并后数据量为%i条' % len(data))
2、计算“房屋售租比”,并做初步判断
'''
2、计算“房屋售租比”,并做初步判断

'''
# 计算“房屋售租比”,并做初步判断
# “房屋售租比”=“每平方米建筑面积的房价”/“每平方米建筑面积的月租金”
# 含义可以简单理解为:“在保持当前的房价和租金条件不变的情况下,完全收回投资需要多少个月?”
#  **一般而言,按照国际经验,在一个房产运行情况良好的区域,应该可以在200-300个月内完全回收投资。
#  **如果少于200个月(17年)就能收回投资,说明这个地区有较高的投资价值;
#  **如果一个地区需要高于300个月(25年),比如1200个月(100年)才能回收投资,则说明该地区有潜在的房产泡沫风险。

data['sell_rent'] = data['sell_area']/data['rent_area']
print('上海房屋租售比中位数为%i个月' % data['sell_rent'].median())
# 计算售租比,及中位数
# 绘制直方图
data['sell_rent'].plot.hist(stacked=True,bins=100,color = 'green',alpha=0.5,grid=True,figsize = (10,4))
plt.title('房屋售租比-直方图')
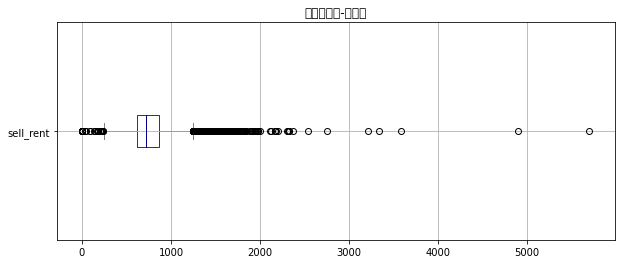
# 绘制箱型图
color = dict(boxes='DarkGreen', whiskers='DarkOrange', medians='DarkBlue', caps='Gray')
data['sell_rent'].plot.box(vert=False, grid = True,color = color,figsize = (10,4))
plt.title('房屋售租比-箱型图')
# 一个尴尬的结论
# 如果按照中位数725个月来看,假设从25岁研究生一毕业,就立刻全款买了一套房,然后放出去收租
# 那么约85岁时,这60年来陆陆续续所收的租金总数就可以达到了25岁时买房所付的钱啦
# **这里还没考虑净现值折算问题
# ① 如果仅靠租金收入的话,上海全市平均回收投资需要725个月。而这种格局的维持,必须有赖于购房者对上海的房价上升的持续预期。
#    也就是说,在上海,投资房产绝不是利率收益,而是预期收益(其实城市越小租金回报反而越高)
# ② 上海不是这么看住房投资的(绝大多数房子房租收入跑不赢商贷利率,否则按照这个思路看那肯定是买一个亏一个)


# 导出数据 去qgis分析
data.to_csv('pro10data.csv',encoding = 'utf_8_sig')
print('finished!')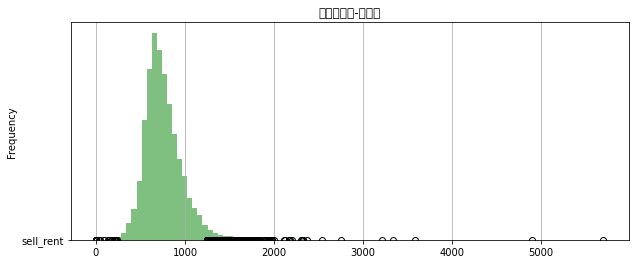
3、上海市人口密度、路网密度、餐饮价格和“房屋每平米均价”是否有关系呢?
qgis分析
打开qgis
导入 人口,道路,餐饮的shp数据
                设置人口 为投影坐标系
                设置背景
                    项目->项目属性->背景颜色
导入csv数据
添加文本数据图层->选择文件,设置经纬度,点确定,过滤添加选取消
            右键另存为->格式选shapefile, 选择好保存路径,坐标系选投影坐标系
统计路网面积
矢量->分析工具->计算线条总长度->选择输出路径 (net01),点击确定
                计算成功后可以打开属性表查看长度
计算餐饮价格
矢量->分析工具->计算多边形内点的数目->net01 和餐饮设施的人均消费,统计 均值 ,输出名为cy_count, 输出文件为net02统计每个单元格内 租金的均值和房价的均值
矢量->分析工具->计算多边形内点的数目->net01 和 net02的rent_area sell_area sell_rent,统计 均值 ,输出名为data_count, 输出文件为net03做数据可视
把上海市shp加载进项目
                更改样式
                    填充选黑色,边界选白色
            net03按照不同的指标做可视化
                sell_area
                    双击打开net03,样式
                        选择渐进
                        列 选择 sell_area
                        颜色渐变选择 OrRd
                        模式选择分位数 类别 9
                        透明度 15%
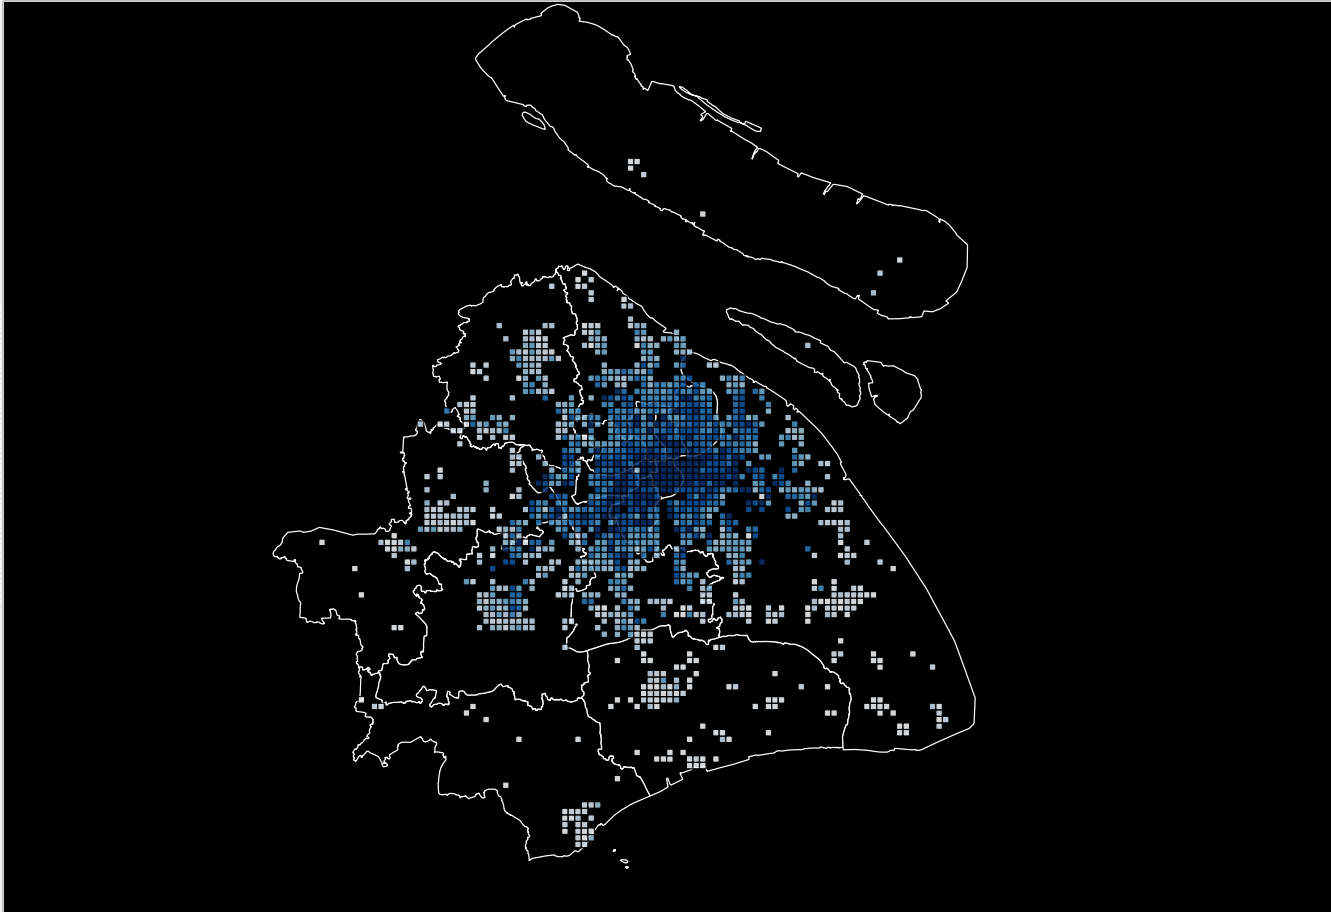
                修改字段查看 其余rent_area sell_area sell_rent的情况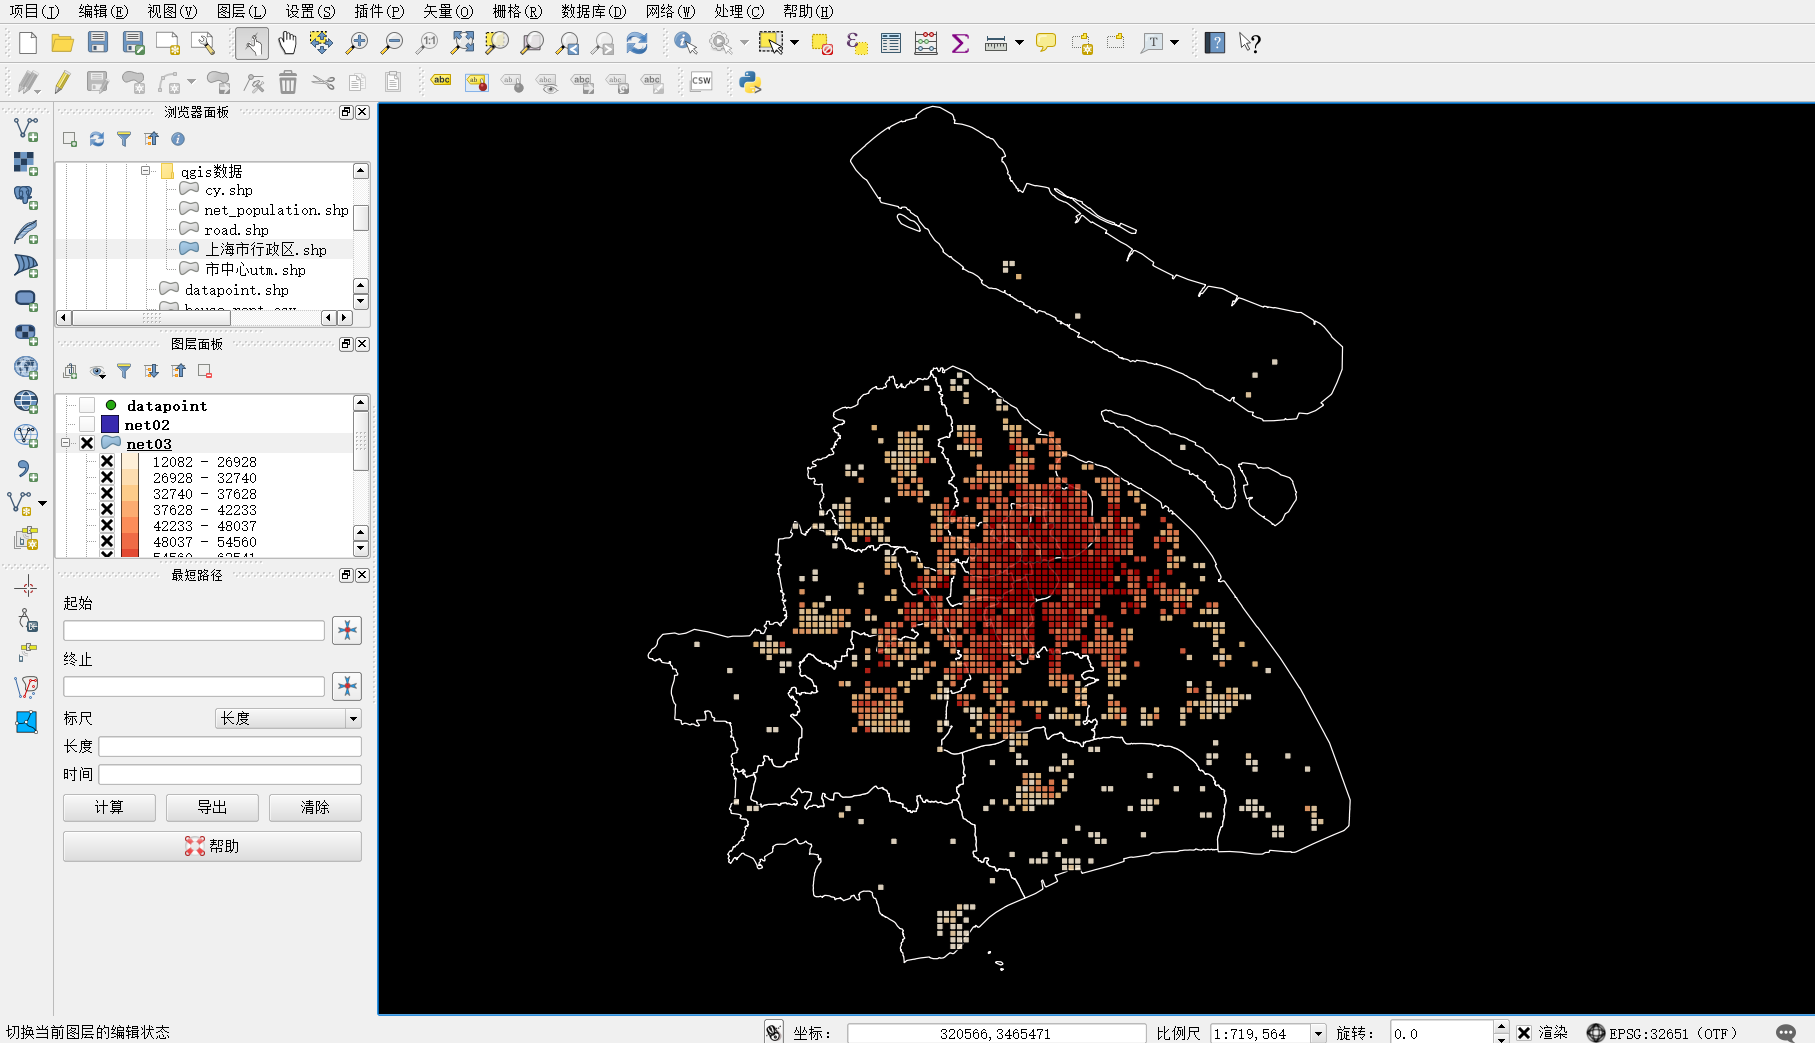
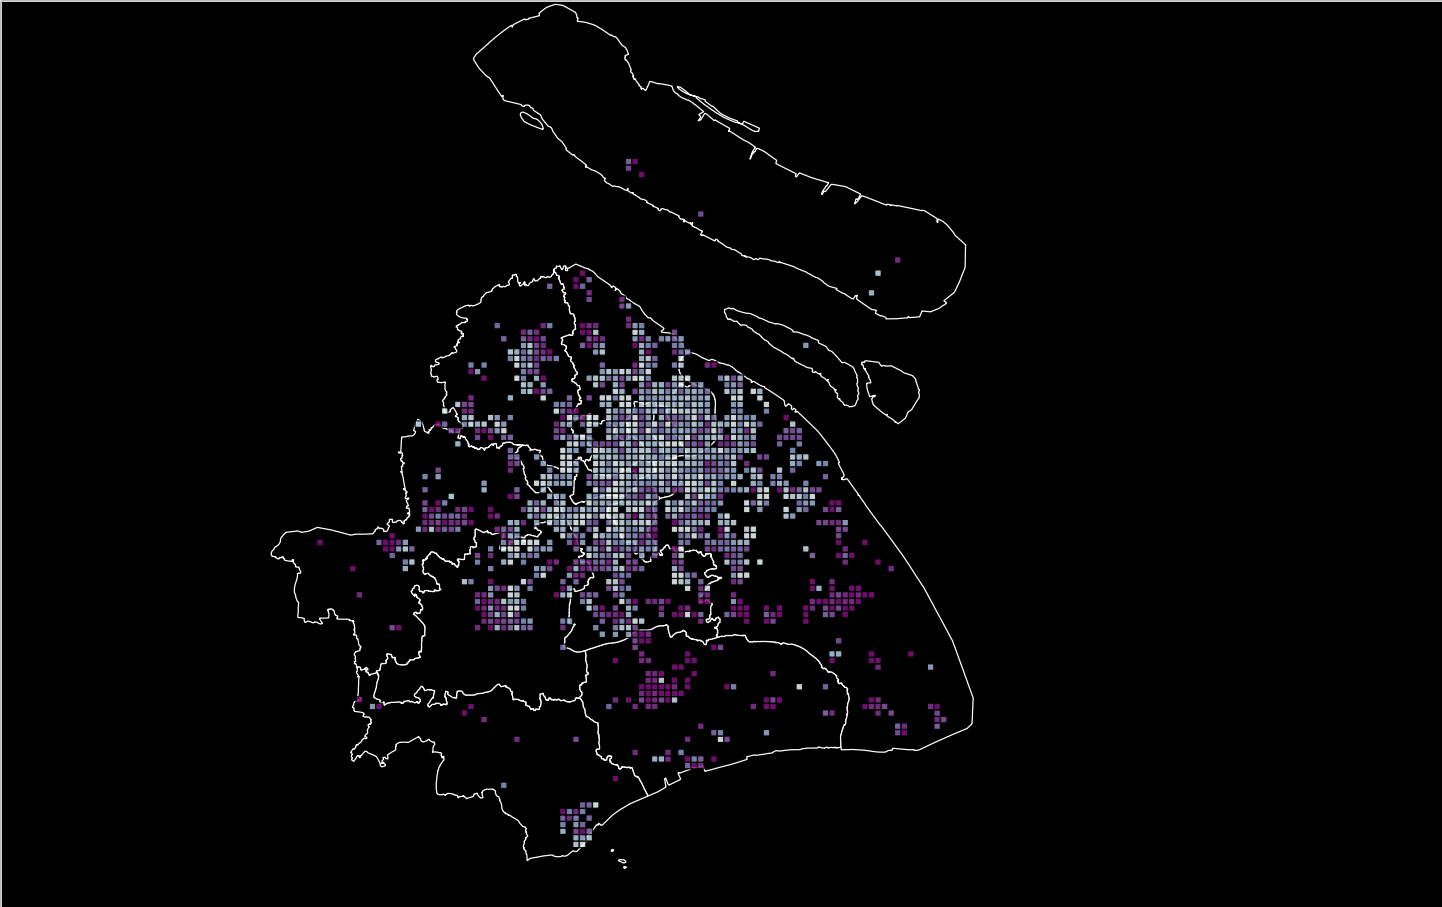
距离市中心的距离
                矢量->分析工具->几何工具->多边形质心
                    选择net03
                    保存为netpoint
                右键 netpoint选择属性表
                    点击“字段计算器”
                        输出字段名称 设为 “Lng"
                        输出字段类型 设为 “小数(实数)”
                        双击 几何图形->$x
                    以同样方式导出 lat 维度 几何图形->$y
                全选属性表
                    新建csv文件
                    把属性表数据复制进csv中
spyder分析
加载数据
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


import warnings
warnings.filterwarnings('ignore')
# 不发出警告

from bokeh.io import output_file

# 导入notebook绘图模块

from bokeh.plotting import figure,show
from bokeh.models import ColumnDataSource
# 导入图表绘制、图标展示模块
# 导入ColumnDataSource模块


'''
加载数据
'''

import os
os.chdir('E:\\Data_analysis\\Project\\04\\')
# 创建工作路径


data_q3 = pd.read_csv('qgisresult.csv',encoding = 'UTF-8')
data_q3.fillna(0,inplace = True)
标准化
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


import warnings
warnings.filterwarnings('ignore')
# 不发出警告

from bokeh.io import output_file

# 导入notebook绘图模块

from bokeh.plotting import figure,show
from bokeh.models import ColumnDataSource
# 导入图表绘制、图标展示模块
# 导入ColumnDataSource模块


'''
加载数据
'''

import os
os.chdir('E:\\Data_analysis\\Project\\04\\')
# 创建工作路径


data_q3 = pd.read_csv('qgisresult.csv',encoding = 'UTF-8')
data_q3.fillna(0,inplace = True)
整理数据
data_q3['离市中心距离'] = ((data_q3['lng'] - 353508.848122)**2 + (data_q3['lat']-3456140.926976)**2)**0.5
# 计算市中心距离

data_q3_test = data_q3[['人口密度指标','路网密度指标','餐饮价格指标','sell_area_','离市中心距离']]
data_q3_test = data_q3_test[data_q3_test['sell_area_']>0].reset_index()
del data_q3_test['index']

# 清洗数据,去除“房屋每平米均价”为0的数据
绘制散点图
fig = plt.figure(figsize = (10,9))
plt.subplots_adjust(hspace=0.4)
# 设置绘图空间

ax1 = fig.add_subplot(3,1,1)
ax1.scatter(data_q3_test['人口密度指标'], data_q3_test['sell_area_'],s = 2,alpha = 0.2)
plt.xlabel('人口密度指标')
plt.ylabel('房屋每平米均价')
plt.grid()
# 散点图1 → 人口密度指标 - 房屋每平米均价

ax2 = fig.add_subplot(3,1,2)
ax2.scatter(data_q3_test['路网密度指标'], data_q3_test['sell_area_'],s = 2,alpha = 0.2)
plt.xlabel('路网密度指标')
plt.ylabel('房屋每平米均价')
plt.grid()
# 散点图2 → 路网密度指标 - 房屋每平米均价

ax3 = fig.add_subplot(3,1,3)
ax3.scatter(data_q3_test['餐饮价格指标'], data_q3_test['sell_area_'],s = 2,alpha = 0.2)
plt.xlabel('餐饮价格指标')
plt.ylabel('房屋每平米均价')
plt.grid()
# 散点图3 → 餐饮价格指标 - 房屋每平米均价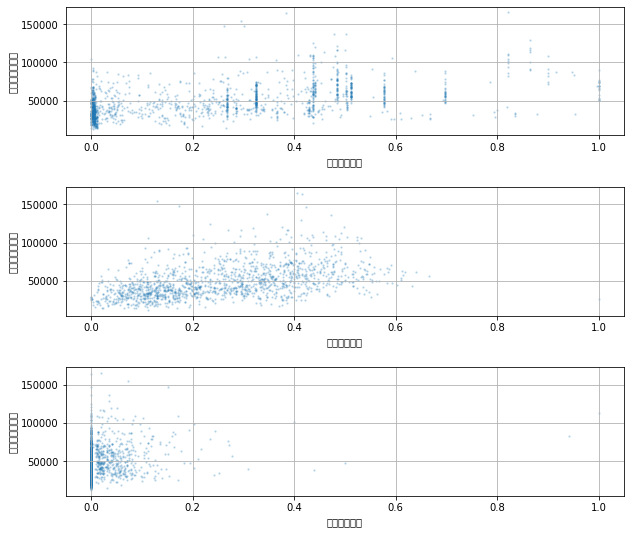
查看“房屋每平米均价”与离市中心距离的关系
# 查看“房屋每平米均价”与离市中心距离的关系

fig = plt.figure(figsize = (10,3))

data_q3_test2 = data_q3_test.sort_values('离市中心距离')
plt.scatter(data_q3_test2['离市中心距离'], data_q3_test2['sell_area_'],color = 'red',s = 3,alpha = 0.5)
plt.xlabel('离市中心距离')
plt.ylabel('房屋每平米均价')
plt.grid()
# 散点图4 → 离市中心距离 - 房屋每平米均价

data_q3_test.corr().loc['sell_area_']
# 查看指标之间相关系数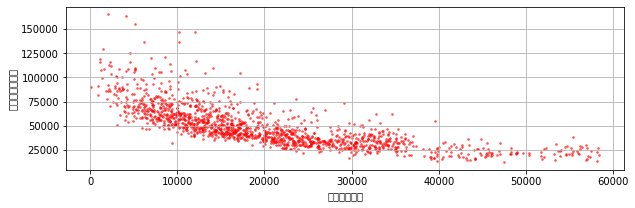
结论
# 结论
# ① 在上海全市层面,“离市中心距离”与“房屋每平米均价”相关性最强
# ② “人口密度”及“路网密度”和“房屋每平米均价”为中等相关
# ③ “餐饮价格”与“房屋每平米均价”为弱相关
# ④ “房屋每平米均价”数据的离散程度却和空间距离有关 → “房屋每平米均价”越靠近市中心越离散,越远离市中心则越收敛
4、按照离市中心距离每10km,分别再次判断人口密度、路网密度、餐饮价格和“房屋每平米均价”的相关程度
按照空间距离分别迭代计算三指标和“房屋每平米均价”的关系
# 按照空间距离分别迭代计算三指标和“房屋每平米均价”的关系

dis = []                # 距离空列表
rkmd_pearson = []       # 人口密度相关性系数空列表
lwmd_pearson = []       # 路网密度相关性系数空列表
cyjg_pearson = []       # 餐饮价格相关性系数空列表
zxjl_pearson = []       # 中心距离相关性系数空列表

for distance in range(10000,70000,10000):
    datai = data_q3_test[data_q3_test['离市中心距离'] <= distance]
    r_value = datai.corr().loc['sell_area_']
    # 筛选数据并计算相关系数
    dis.append(distance)
    rkmd_pearson.append(r_value.loc['人口密度指标'])
    lwmd_pearson.append(r_value.loc['路网密度指标'])
    cyjg_pearson.append(r_value.loc['餐饮价格指标'])
    zxjl_pearson.append(r_value.loc['离市中心距离'])
    # 添加列表值
    print('离市中心距离小于等于%i米:' % distance)
    print('数据量为%i条' % len(datai))
    print('人口密度与房屋每平米均价的相关系数为:%.3f' % r_value.loc['人口密度指标'])
    print('路网密度与房屋每平米均价的相关系数为:%.3f' % r_value.loc['路网密度指标'])
    print('餐饮价格与房屋每平米均价的相关系数为:%.3f' % r_value.loc['餐饮价格指标'])
    print('离市中心距离与房屋每平米均价的相关系数为:%.3f' % r_value.loc['离市中心距离'])
    print('-------\n')
绘制折线图
# 绘制折线图查看:随着市中心距离增加,不同指标相关性系数变化情况

from bokeh.models import HoverTool
output_file('fangjiayinsu.html')
df_r = pd.DataFrame({'rkmd_pearson':rkmd_pearson,
                    'lwmd_pearson':lwmd_pearson,
                    'cyjg_pearson':cyjg_pearson,
                    'zxjl_pearson':zxjl_pearson},
                   index = dis)
source = ColumnDataSource(data=df_r)
# 创建数据

hover = HoverTool(tooltips=[("离市中心距离", "@index"),
                           ("人口密度相关系数", "@rkmd_pearson"),
                           ("道路密度相关系数", "@lwmd_pearson"),
                           ("餐饮价格相关系数", "@cyjg_pearson"),
                           ("中心距离相关系数", "@zxjl_pearson"),])
# 设置标签显示内容
p = figure(plot_width=900, plot_height=350, title="随着市中心距离增加,不同指标相关性系数变化情况",
          tools=[hover,'box_select,reset,xwheel_zoom,pan,crosshair'])
# 构建绘图空间
p.line(x='index',y='rkmd_pearson',source = source,line_alpha = 0.8, line_color = 'green',line_dash = [15,4],legend="人口密度相关系数")
p.circle(x='index',y='rkmd_pearson',source = source, size = 8,color = 'green',alpha = 0.8,legend="人口密度相关系数")
# 绘制折线图1
p.line(x='index',y='lwmd_pearson',source = source,line_alpha = 0.8, line_color = 'blue',line_dash = [15,4],legend="道路密度相关系数")
p.circle(x='index',y='lwmd_pearson',source = source, size = 8,color = 'blue',alpha = 0.8,legend="道路密度相关系数")
# 绘制折线图2
p.line(x='index',y='cyjg_pearson',source = source,line_alpha = 0.8, line_color = 'black',line_dash = [15,4],legend="餐饮价格相关系数")
p.circle(x='index',y='cyjg_pearson',source = source, size = 8,color = 'black',alpha = 0.8,legend="餐饮价格相关系数")
# 绘制折线图3
p.line(x='index',y='zxjl_pearson',source = source,line_alpha = 0.8, line_color = 'red',line_dash = [15,4],legend="中心距离相关系数")
p.circle(x='index',y='zxjl_pearson',source = source, size = 8,color = 'red',alpha = 0.8,legend="中心距离相关系数")
# 绘制折线图4
p.legend.location = "center_right"
show(p)
# 绘制折线图

df_r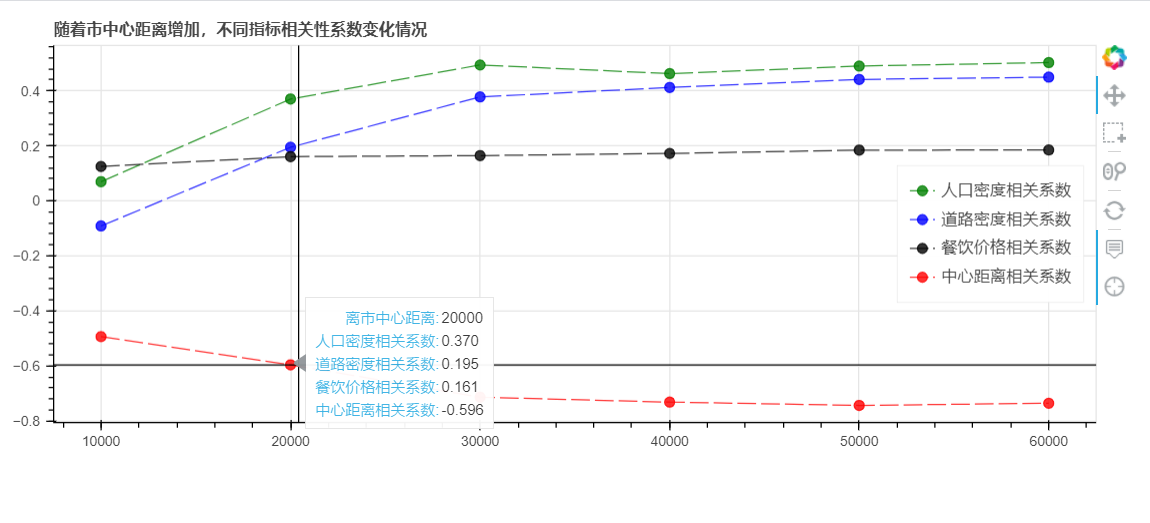
结论
# 结论
# ① “人口密度”、“道路密度”、“离市中心距离”和“房屋均价”有着明显的相关性,而“餐饮价格”和“房屋均价”相关性较弱
# ② 随着离市中心的距离越远,指标的相关性在数据上体现更明显,而这个分界线大概在20-30km处,这正是上海中心城区和郊区的分界
#    → 上海房价市场的“中心城区-郊区”分化特征
# ③ 中心城区的房产市场对指标因素的影响更加敏锐,而郊区则更迟钝 → 越靠近市中心,影响因素越复杂