已知数据
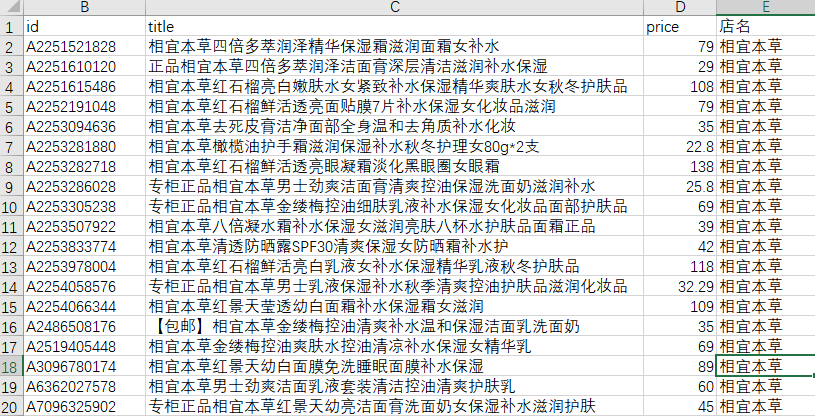 id(唯一)
tittle
price
根据时间和价格的差异可以分析出打折情况
品牌名
日期(10天内的数据)
通过日的维度来分析数据
同一件商品 可能很多天都在销售
同一个商品 根据销售时间维度 可以划分出他的销售节奏
1.每个品牌有多少商品参与了双十一?
商品总数、品牌总数,双十一当天参与活动的商品总数?
双十一当天在售的商品占比情况
            按照商品销售节奏分类,我们可以将商品分为7类
            商品销售节奏分类
id_date['type'] = '待分类'
id_date['type'][(id_date['min'] <11)&(id_date['max']>11)] = 'A' # A类:11.11前后及当天都在售 → 一直在售
id_date['type'][(id_date['min'] <11)&(id_date['max']==11)] = 'B' # B类:11.11之后停止销售 → 双十一后停止销售
id_date['type'][(id_date['min'] ==11)&(id_date['max']>11)] = 'C' # C类:11.11开始销售并当天不停止 → 双十一当天上架并持续在售
id_date['type'][(id_date['min'] ==11)&(id_date['max']==11)] = 'D' # D类:11.11开始销售且当天停止 → 仅双十一当天有售
id_date['type'][id_date['双十一当天是否售卖']== False] = 'F' # F类:仅11.11当天停止销售 → 仅双十一当天停止销售
id_date['type'][id_date['max']<11] = 'E' # E类:11.5 - 11.10 → 双十一前停止销售
id_date['type'][id_date['min'] >11] = 'G' # G类:11.11之后开始销售 → 双十一后上架
# 商品销售节奏分类计算不同类别的商品数量并绘制饼图result1 = id_date['type'].value_counts()
result1 = result1.loc[['A','C','B','D','E','F','G']] # 调整顺序
# 计算不同类别的商品数量
from bokeh.palettes import brewer
colori = brewer['YlGn'][7]
# 设置调色盘
plt.axis('equal') # 保证长宽相等
plt.pie(result1,labels = result1.index, autopct='%.2f%%',pctdistance=0.8,labeldistance =1.1,
startangle=90, radius=1.5,counterclock=False, colors = colori)
# 绘制饼图
result1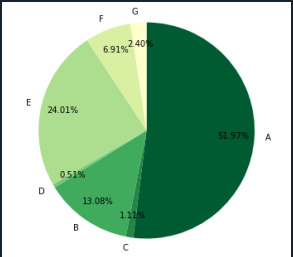
统计不同商品的销售开始日期、截止日期d1 = data1[['id','date']].groupby(by = 'id').agg(['min','max'])['date'] #agg多函数计算筛选双十一当天售卖的商品id 给他新加一个字段id_11 = data1[data1['date']==11]['id'].unique()
d2 = pd.DataFrame({'id':id_11,'双十一当天是否售卖':True})
# 筛选双十一当天售卖的商品id双十一当天参与活动的商品总数,占比m = len(data1['id'].unique())
m_11 = len(id_11)
m_11_pre = m_11/m总数:用id去重,然后算length
占比:双十一当天在售商品/总商品数未参与双十一当天活动的商品,在双十一之后的去向如何?
先设好分类# con1 → 暂时下架(F)
# con2 → 重新上架(E中部分数据,数据中同一个id可能有不同title,“换个马甲重新上架”)
# con3 → 预售(E中部分数据,预售商品的title中包含“预售”二字),字符串查找特定字符 dataframe.str.contains('预售')
# con4 → 彻底下架(E中部分数据),可忽略找到未参与双十一当天活动的商品idid_not11 = id_date[id_date['双十一当天是否售卖']==False] # 筛选出双十一当天没参加活动的产品id
print('双十一当天没参加活动的商品总数为%i个,占比为%.2f%%\n-------' % (len(id_not11),len(id_not11)/m*100))
print('双十一当天没参加活动的商品销售节奏类别为:\n',id_not11['type'].value_counts().index.tolist())
print('------')
# 找到未参与双十一当天活动的商品id筛选出未参与双十一当天活动商品id对应的原始数据df_not11 = id_not11[['id','type']]
data_not11 = pd.merge(df_not11,df,on = 'id', how = 'left')
# 筛选出未参与双十一当天活动商品id对应的原始数据计算出每一种分类的数据id_con1 = id_date['id'][id_date['type'] == 'F'].values
# 筛选出con1的商品id
# con1 → 暂时下架(F)
data_con2 = data_not11[['id','title','date']].groupby(by = ['id','title']).count() # 按照id和title分组(找到id和title一对多的情况)
title_count = data_con2.reset_index()['id'].value_counts() # 计算id出现的次数,如果出现次数大于1,则说明该商品是更改了title的
id_con2 = title_count[title_count>1].index
# 筛选出con2的商品id
# con2 → 重新上架(E中部分数据,数据中同一个id可能有不同title,“换个马甲重新上架”)
data_con3 = data_not11[data_not11['title'].str.contains('预售')] # 筛选出title中含有“预售”二字的数据
id_con3 = data_con3['id'].value_counts().index
# 筛选出con3的商品id
# con3 → 预售(E中部分数据,预售商品的title中包含“预售”二字)
print("未参与双十一当天活动的商品中:\n暂时下架商品的数量为%i个,重新上架商品的数据量为%i个,预售商品的数据量为%i个"
% (len(id_con1), len(id_con2), len(id_con3)))真正参与双十一活动的品牌有哪些?
得到真正参与双十一活动的商品id
            预售+双十一当天售卖的商品
data_11sale = id_11
#print('双十一当天在售的商品的数量为%i个\n' % len(data_11sale),data_11sale)
#print('--------')
# 得到“双十一当天在售的商品”id及数量
id_11sale_final = np.hstack((data_11sale,id_con3)) #竖向堆叠
result2_id = pd.DataFrame({'id':id_11sale_final})
print('商品总数为%i个' % m)
print('真正参加活动的商品商品总数为%i个,占比为%.2f%%\n-------' % (len(result2_id),len(result2_id)/m*100))
#result2['id'].duplicated()
# 得到真正参与双十一活动的商品id得到不同品牌的当天参与活动商品的数量x1 = pd.DataFrame({'id':id_11})
x1_df = pd.merge(x1,df,on = 'id', how = 'left') # 筛选出真正参与活动中 当天在售的商品id对应源数据
brand_11sale = x1_df.groupby('店名')['id'].count()
# 得到不同品牌的当天参与活动商品的数量得到不同品牌的预售商品的数量x2 = pd.DataFrame({'id':id_con3})
x2_df = pd.merge(x2,df,on = 'id', how = 'left') # 筛选出真正参与活动中 当天在售的商品id对应源数据
brand_ys = x2_df.groupby('店名')['id'].count()
# 得到不同品牌的预售商品的数量真正参与双十一的品牌result2_data = pd.DataFrame({'当天参与活动商品数量':brand_11sale,
'预售商品数量':brand_ys})
result2_data['参与双十一活动商品总数'] = result2_data['当天参与活动商品数量'] + result2_data['预售商品数量']
result2_data.sort_values(by = '参与双十一活动商品总数',inplace = True,ascending = False)
result2_data制作堆叠图查看各个品牌参与双十一活动的商品数量分布from bokeh.models import HoverTool
from bokeh.core.properties import value
# 导入相关模块
output_file("dazhetaolu.html")
lst_brand = result2_data.index.tolist()
lst_type = result2_data.columns.tolist()[:2]
colors = ["red" ,"green"]
# 设置好参数
result2_data.index.name = 'brand'
result2_data.columns = ['sale_on_11','presell','sum']
# 修改数据index和columns名字为英文
source = ColumnDataSource(data=result2_data)
# 创建数据
hover = HoverTool(tooltips=[("品牌", "@brand"),
("双十一当天参与活动的商品数量", "@sale_on_11"),
("预售商品数量", "@presell"),
("参与双十一活动商品总数", "@sum")
]) # 设置标签显示内容
p = figure(x_range=lst_brand, plot_width=900, plot_height=350, title="各个品牌参与双十一活动的商品数量分布",
tools=[hover,'reset,xwheel_zoom,pan,crosshair'])
# 构建绘图空间
p.vbar_stack(lst_type, # 设置堆叠值,这里source中包含了不同年份的值,years变量用于识别不同堆叠层
x='brand', # 设置x坐标
source=source,
width=0.9, color=colors, alpha = 0.8,
legend=[value(x) for x in lst_type],
muted_color='black', muted_alpha=0.2
)
# 绘制堆叠图 在spyder中无法正常显示boken图,在jupyternotebook里运行2次才行,报legend弃用
p.xgrid.grid_line_color = None
p.axis.minor_tick_line_color = None
p.outline_line_color = None
p.legend.location = "top_right"
p.legend.orientation = "horizontal"
p.legend.click_policy="mute"
# 设置其他参数
show(p)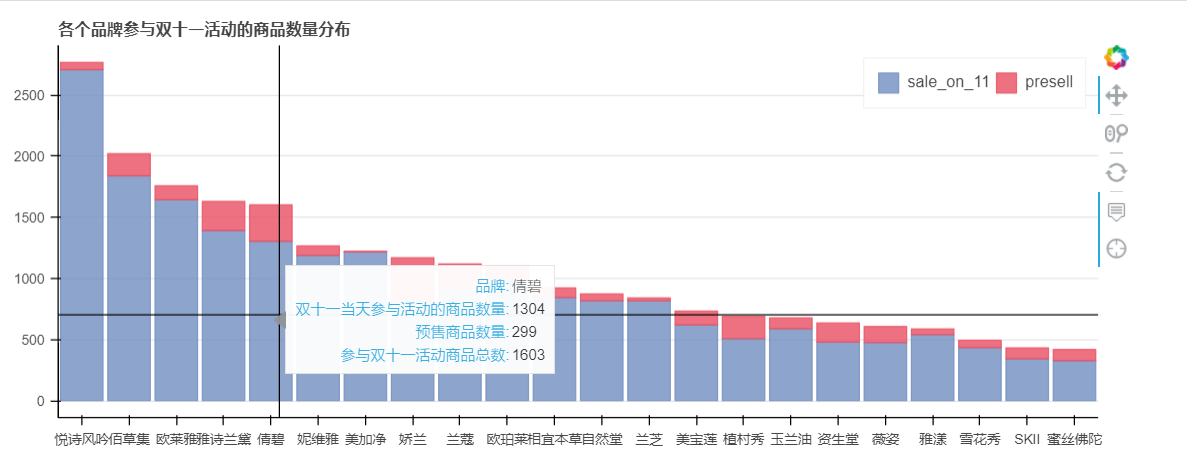
2、哪些商品真的在打折呢?
针对每个商品,评估其打折的情况,
针对在打折的商品,其折扣率是多少
筛选出“不打折”和“真打折”的商品idprice = data2[['id','price','period']].groupby(['id','price']).min()
price.reset_index(inplace = True)
# 针对每个商品做price字段的value值统计,查看价格是否有波动
id_count = price['id'].value_counts()
id_type1 = id_count[id_count == 1].index
id_type2 = id_count[id_count != 1].index
# 筛选出“不打折”和“真打折”的商品id针对在打折的商品,其折扣率是多少n1 = len(id_type1)
n2 = len(id_type2)
print('真打折的商品数量约占比%.2f%%,不打折的商品数量约占比%.2f%%' % (n2/len(id_count)*100, n1/len(id_count)*100))
# 针对在打折的商品,其折扣率是多少计算折扣率result3_data1 = data2[['id','price','period','店名']].groupby(['id','period']).min()
result3_data1.reset_index(inplace = True)
# 筛选数据
result3_before11 = result3_data1[result3_data1['period'] == '双十一前']
result3_at11 = result3_data1[result3_data1['period'] == '双十一当天']
result3_data2 = pd.merge(result3_at11,result3_before11,on = 'id')
# 筛选出商品双十一当天及双十一之前的价格
result3_data2['zkl'] = result3_data2['price_x'] / result3_data2['price_y']
# 计算折扣率用bokeh绘制折线图:x轴为折扣率,y轴为商品数量占比bokeh_data = result3_data2[['id','zkl']].dropna()
bokeh_data['zkl_range'] = pd.cut(bokeh_data['zkl'],bins = np.linspace(0,1,21))
bokeh_data2 = bokeh_data.groupby('zkl_range').count().iloc[:-1]
del bokeh_data2['id']
bokeh_data2.columns=['zk_count']
bokeh_data2['zkl_pre'] = bokeh_data2['zk_count']/bokeh_data2['zk_count'].sum()
bokeh_data2['range']=bokeh_data2.index
bokeh_data3=bokeh_data2.reset_index(drop=True)
bokeh_data3.index.name = 'index'
del bokeh_data3['range'] # bokeh无法很好识别带有 开闭区间的数据,需要删掉
source1 = ColumnDataSource(data=bokeh_data3)
lst_brand = bokeh_data3.index.tolist()
hover = HoverTool(tooltips=[("折扣数", "@zk_count")]) # 设置标签显示内容
p = figure( plot_width=900, plot_height=350, title="商品折扣率统计",
tools=[hover,'reset,xwheel_zoom,pan,crosshair'])
# 构建绘图空间
p.line(x='index',y='zkl_pre',source = source1, # 设置x,y值, source → 数据源
line_width=2, line_alpha = 0.8, line_color = 'black') # 线型基本设置
# 绘制折线图
p.circle(x='index',y='zkl_pre',source = source1, size = 8,color = 'red',alpha = 0.8)
p.xgrid.grid_line_color = None
p.axis.minor_tick_line_color = None
p.outline_line_color = None
# 设置其他参数
show(p)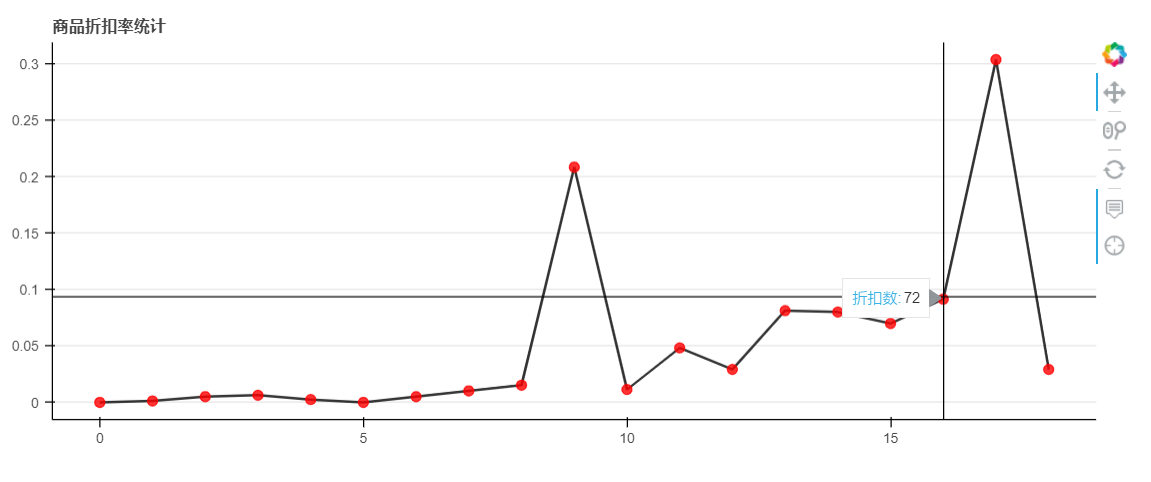
按照品牌分析,不同品牌的打折力度
筛选数据 绘图# 按照品牌分析,不同品牌的打折力度
# 用bokeh绘制浮动散点图,y坐标为品牌类型,x坐标为折扣力度
from bokeh.transform import jitter #有浮动的散点图
brands = result3_data2['店名_y'].dropna().unique().tolist()
# 得到y坐标
bokeh_data4 = result3_data2[['id','zkl','店名_y']].dropna()
bokeh_data4 = bokeh_data4[bokeh_data['zkl'] < 0.95]
source2 = ColumnDataSource(data = bokeh_data4)
# 创建数据
hover = HoverTool(tooltips=[("折扣率", "@zkl")]) # 设置标签显示内容
p2 = figure(plot_width=800, plot_height=600,y_range=brands,title="不同品牌折扣率情况",
tools=[hover,'reset,ywheel_zoom,pan,crosshair'])
p2.circle(x='zkl',
y=jitter('店名_y', width=0.6, range=p.y_range),
source=source2, alpha=0.3)
# jitter参数 → 'day':第一参数,这里指y的值,width:间隔宽度比例,range:分类范围对象,这里和y轴的分类一致
p2.ygrid.grid_line_color = None
# 设置其他参数
show(p2)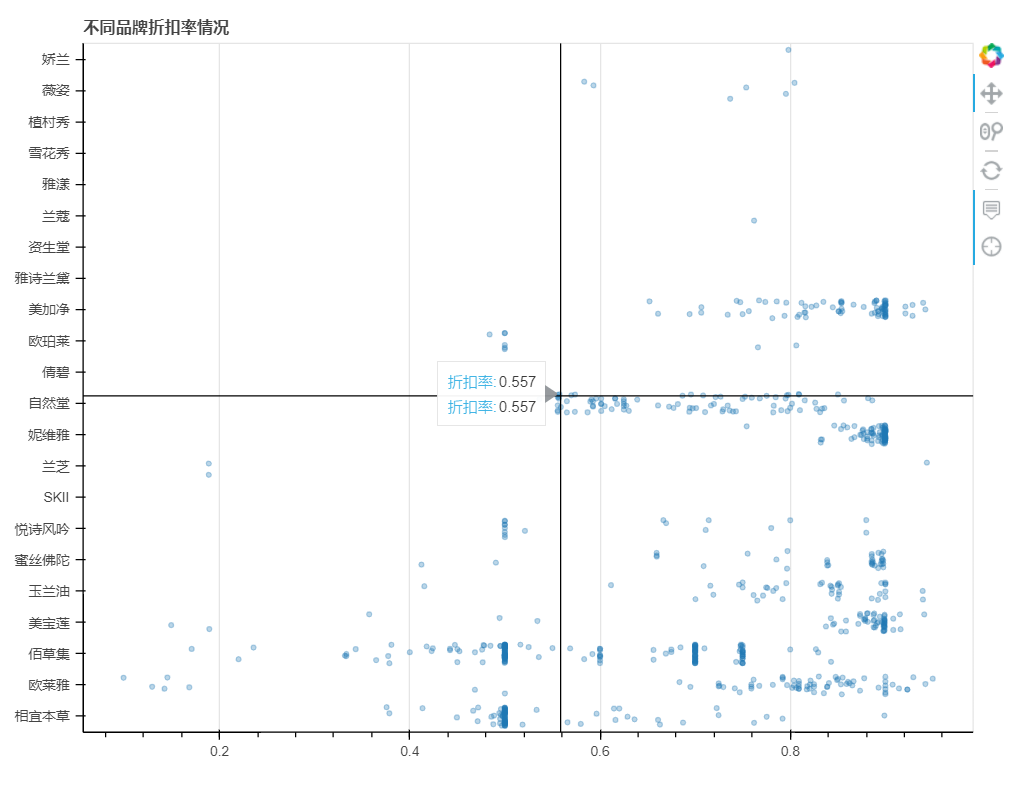
3、商家营销套路挖掘?
解析出不同品牌的参与打折商品比例及折扣力度,并做散点图,总结打折套路# 解析出不同品牌的参与打折商品比例及折扣力度,并做散点图,总结打折套路
data_zk = result3_data2[result3_data2['zkl']<0.95] # 删除未打折数据
result4_zkld = data_zk.groupby('店名_y')['zkl'].mean()
# 筛选出不同品牌的折扣率
n_dz = data_zk['店名_y'].value_counts()
n_zs = result3_data2['店名_y'].value_counts()
result4_dzspbl = pd.DataFrame({'打折商品数':n_dz,'商品总数':n_zs})
result4_dzspbl['参与打折商品比例'] = result4_dzspbl['打折商品数'] / result4_dzspbl['商品总数']
result4_dzspbl.dropna(inplace = True)
#print(result4_dzspbl.head())
# 计算出不同品牌参与打折商品比例
result4_sum = result2_data.copy()
# 筛选出品牌参加双11活动的商品总数
result4_data = pd.merge(pd.DataFrame(result4_zkld),result4_dzspbl,left_index = True, right_index = True, how = 'inner')
result4_data = pd.merge(result4_data,result4_sum,left_index = True, right_index = True, how = 'inner')
# 合并数据
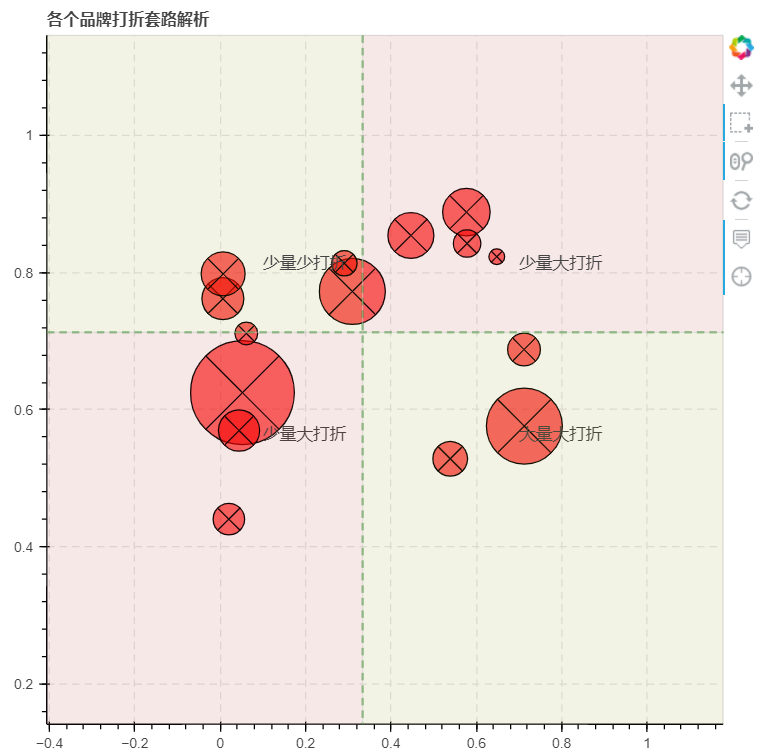
result3_data2绘制散点图# 用bokeh绘制散点图,x轴为参与打折商品比例,y轴为折扣力度,点的大小代表该品牌参加双11活动的商品总数
from bokeh.models.annotations import Span # 导入Span模块
from bokeh.models.annotations import Label # 导入Label模块
from bokeh.models.annotations import BoxAnnotation # 导入BoxAnnotation模块
bokeh_data = result4_data[['zkl','sum','参与打折商品比例']]
bokeh_data.columns = ['zkl','amount','pre']
bokeh_data['size'] = bokeh_data['amount'] * 0.03
source = ColumnDataSource(bokeh_data)
# 创建ColumnDataSource数据
x_mean = bokeh_data['pre'].mean()
y_mean = bokeh_data['zkl'].mean()
hover = HoverTool(tooltips=[("品牌", "@index"),
("折扣率", "@zkl"),
("商品总数", "@amount"),
("参与打折商品比例", "@pre"),
]) # 设置标签显示内容
p = figure(plot_width=600, plot_height=600,
title="各个品牌打折套路解析" ,
tools=[hover,'box_select,reset,wheel_zoom,pan,crosshair'])
# 构建绘图空间
p.circle_x(x = 'pre',y = 'zkl',source = source,size = 'size',
fill_color = 'red',line_color = 'black',fill_alpha = 0.6,line_dash = [8,3])
p.ygrid.grid_line_dash = [6, 4]
p.xgrid.grid_line_dash = [6, 4]
# 散点图
x = Span(location=x_mean, dimension='height', line_color='green',line_alpha = 0.7, line_width=1.5, line_dash = [6,4])
y = Span(location=y_mean, dimension='width', line_color='green',line_alpha = 0.7, line_width=1.5, line_dash = [6,4])
p.add_layout(x)
p.add_layout(y)
# 绘制辅助线
bg1 = BoxAnnotation(bottom=y_mean, right=x_mean,fill_alpha=0.1, fill_color='olive')
label1 = Label(x=0.1, y=0.55,text="少量大打折",text_font_size="10pt" )
p.add_layout(bg1)
p.add_layout(label1)
# 绘制第一象限
bg2 = BoxAnnotation(bottom=y_mean, left=x_mean,fill_alpha=0.1, fill_color='firebrick')
label2 = Label(x=0.7, y=0.55,text="大量大打折",text_font_size="10pt" )
p.add_layout(bg2)
p.add_layout(label2)
# 绘制第二象限
bg3 = BoxAnnotation(top=y_mean, right=x_mean,fill_alpha=0.1, fill_color='firebrick')
label3 = Label(x=0.1, y=0.80,text="少量少打折",text_font_size="10pt" )
p.add_layout(bg3)
p.add_layout(label3)
# 绘制第三象限
bg4 = BoxAnnotation(top=y_mean, left=x_mean,fill_alpha=0.1, fill_color='olive')
label4 = Label(x=0.7, y=0.80,text="少量大打折",text_font_size="10pt" )
p.add_layout(bg4)
p.add_layout(label4)
# 绘制第四象限
show(p)
'''
结论:
少量少打折:包括雅诗兰黛、娇兰、兰蔻、薇姿、玉兰油等共5个品牌。
少量大打折:包括悦诗风吟、兰芝、欧珀莱等3个品牌。该类品牌的打折商品较少,但折扣力度较大。
大量小打折:包括妮维雅、美宝莲、蜜丝佛陀等3个品牌。该类型有半数以上的商品都参与了打折活动,但折扣力度并不大。
大量大打折:包括相宜本草、佰草集、自然堂等三大国产品牌。这些品牌不仅有90%以上的商品参与了折扣活动,而且折扣力度很大。
'''