导包
#conding=utf-8
import pandas as pd
import numpy as np
import matplotlib as mpl
import matplotlib.pyplot as plt

from scipy.optimize import minimize
from sklearn.preprocessing import PolynomialFeatures

# pandas 基础设置
pd.set_option('display.notebook_repr_html',False)
pd.set_option('display.max_columns',None)
pd.set_option('display.max_rows',150)
pd.set_option('display.max.seq_items',None)

%matplotlib inline

import seaborn as sns  # 格式化工具
sns.set_context('notebook')
sns.set_style('white')
加载数据
# 加载文本文件 转化成numpy数据格式
def loaddata(file,delimeter):
    data = np.loadtxt(file, delimiter=delimeter)
    print('Dimensions: ',data.shape)  # 打印维度
    print(data[1:6,:])
    return(data)
data = loaddata('data1.txt', ',')结果:
Dimensions:  (100, 3)
[[30.28671077 43.89499752  0.        ]
 [35.84740877 72.90219803  0.        ]
 [60.18259939 86.3085521   1.        ]
 [79.03273605 75.34437644  1.        ]
 [45.08327748 56.31637178  0.        ]]
准备可视化
# 为了做可视化
def plotData(data, label_x, label_y, label_pos, label_neg, axes=None):
    # 获得正负样本的下标(即哪些是正样本,哪些是负样本)
    neg = data[:,2] == 0
    pos = data[:,2] == 1

    if axes == None:
        axes = plt.gca()
    axes.scatter(data[pos][:,0], data[pos][:,1], marker='+', c='k', s=60, linewidth=2, label=label_pos)
    axes.scatter(data[neg][:,0], data[neg][:,1], c='y', s=60, label=label_neg)
    axes.set_xlabel(label_x)
    axes.set_ylabel(label_y)
    axes.legend(frameon= True, fancybox = True)
X = np.c_[np.ones((data.shape[0],1)), data[:,0:2]]  # 第一二列为数据样本
y = np.c_[data[:,2]]  # 第三列为结果
# 第一课 第二课 考试 通过 不通过
plotData(data, 'Exam 1 score', 'Exam 2 score', 'Pass', 'Fail') # 可视化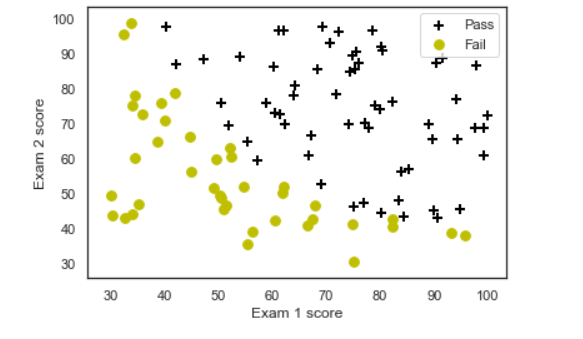
定义方法
#定义sigmoid函数  scipy包中也有sigmoid函数
def sigmoid(z):
    return(1 / (1 + np.exp(-z)))
#定义损失函数
def costFunction(theta, X, y):
    m = y.size
    h = sigmoid(X.dot(theta))

    # 二元交叉熵形式
    J = -1.0*(1.0/m)*(np.log(h).T.dot(y)+np.log(1-h).T.dot(1-y))  # 向量化的损失函数(矩阵形式)

    if np.isnan(J[0]):  # 判断空值的方法 只有数组数值运算时可使用
        return(np.inf)  # inf 表示一个无限大的正数
    return J[0]
#求解梯度
def gradient(theta, X, y):
    m = y.size
    h = sigmoid(X.dot(theta.reshape(-1,1)))
    grad =(1.0/m)*X.T.dot(h-y)
    return(grad.flatten())
计算
initial_theta = np.zeros(X.shape[1])
print(initial_theta)
cost = costFunction(initial_theta, X, y)
grad = gradient(initial_theta, X, y)
print('Cost: \n', cost)  # 初始损失函数
print('Grad: \n', grad)  # 初始梯度
结果:
[0. 0. 0.]
Cost:
 0.6931471805599453
Grad:
 [ -0.1        -12.00921659 -11.26284221]
res = minimize(costFunction, initial_theta, args=(X,y), jac=gradient, options={'maxiter':400}) # scipy中的最小化方法 拿到最优theta
# 如果报错 问题的原因是,数字太大了,溢出,计算过程出现inf,inf再做其它运算,大部分还是inf
res结果:
fun: 0.2034977015895099
 hess_inv: array([[ 2.85339493e+03, -2.32908823e+01, -2.27416470e+01],
       [-2.32908823e+01,  2.04489131e-01,  1.72969525e-01],
       [-2.27416470e+01,  1.72969525e-01,  1.96170322e-01]])
      jac: array([-2.68557620e-09,  4.36433485e-07, -1.39671757e-06])
  message: 'Optimization terminated successfully.'
     nfev: 34
      nit: 25
     njev: 30
   status: 0
  success: True
        x: array([-25.16131634,   0.2062316 ,   0.20147143])
预测
# 预测
def predict(theta, X, threshold=0.5):  # 和0.5比较 判断是否通过考试
    p = sigmoid(X.dot(theta.T)) >= threshold
    return(p.astype('int'))
预测看看考试1得分45 考试2得分85的同学通过概率有多高
sigmoid(np.array([1,45,85])).dot(res.x.T)绘图
plt.scatter(45, 85, s=60, c='r', marker='v', label='(45, 85)')
plotData(data, 'Exam 1 score', 'Exam 2 score', 'Admitted', 'Not admitted')
x1_min, x1_max = X[:,1].min(), X[:,1].max(),
x2_min, x2_max = X[:,2].min(), X[:,2].max(),
xx1, xx2 = np.meshgrid(np.linspace(x1_min, x1_max), np.linspace(x2_min, x2_max))
h = sigmoid(np.c_[np.ones((xx1.ravel().shape[0],1)), xx1.ravel(), xx2.ravel()].dot(res.x))
h = h.reshape(xx1.shape)
plt.contour(xx1, xx2, h, [0.5], linewidths=1, colors='b');
红点 45 85 分成绩 说明通过考试
正则化对数据集的影响
加载第二份数据集
data2 = loaddata('data2.txt', ',')结果:
Dimensions:  (118, 3)
[[-0.092742  0.68494   1.      ]
 [-0.21371   0.69225   1.      ]
 [-0.375     0.50219   1.      ]
 [-0.51325   0.46564   1.      ]
 [-0.52477   0.2098    1.      ]]
# 拿到X和y
y = np.c_[data2[:,2]]
X = data2[:,0:2]
# 画个图
plotData(data2, 'Microchip Test 1', 'Microchip Test 2', 'y = 1', 'y = 0')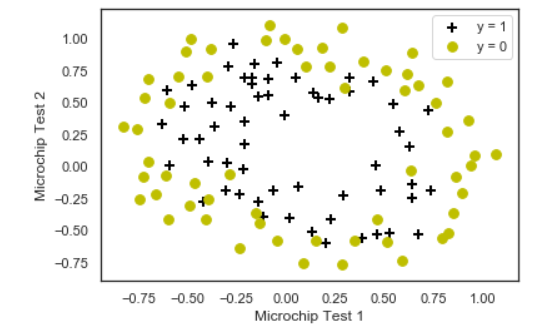
整一点多项式特征出来(最高6阶)
poly = PolynomialFeatures(6)  # 多项式特征
XX = poly.fit_transform(data2[:,0:2])
# 看看形状(特征映射后x有多少维)
XX.shape
(118, 28)118个点 28维
定义方法
# 定义损失函数
def costFunctionReg(theta, reg, *args):
    m = y.size
    h = sigmoid(XX.dot(theta))

    J = -1.0*(1.0/m)*(np.log(h).T.dot(y)+np.log(1-h).T.dot(1-y)) + (reg/(2.0*m))*np.sum(np.square(theta[1:]))  # 正则化

    if np.isnan(J[0]):
        return(np.inf)
    return(J[0])
def gradientReg(theta, reg, *args):
m = y.size
h = sigmoid(XX.dot(theta.reshape(-1,1)))
grad = (1.0/m)*XX.T.dot(h-y) + (reg/m)*np.r_[[[0]],theta[1:].reshape(-1,1)]
return(grad.flatten())initial_theta = np.zeros(XX.shape[1])
costFunctionReg(initial_theta, 1, XX, y)0.6931471805599454
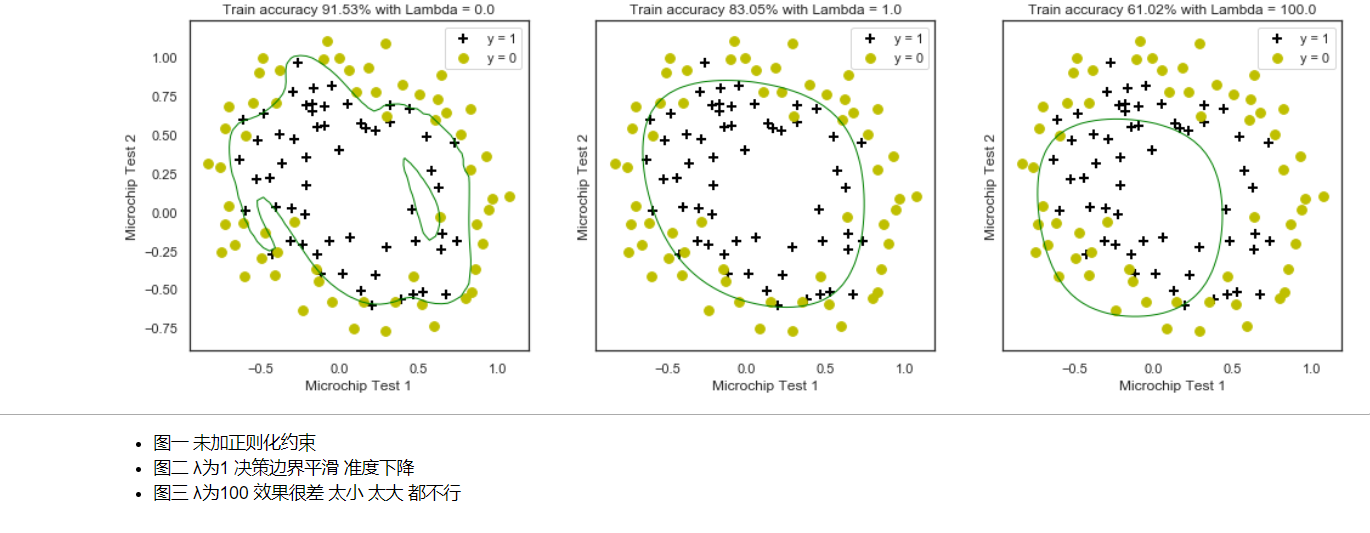
fig, axes = plt.subplots(1,3, sharey = True, figsize=(17,5))

# 决策边界,咱们分别来看看正则化系数lambda太大太小分别会出现什么情况
# Lambda = 0 : 就是没有正则化,这样的话,就过拟合咯
# Lambda = 1 : 这才是正确的打开方式
# Lambda = 100 : 卧槽,正则化项太激进,导致基本就没拟合出决策边界

for i, C in enumerate([0.0, 1.0, 100.0]):
    # 最优化 costFunctionReg
    res2 = minimize(costFunctionReg, initial_theta, args=(C, XX, y), jac=gradientReg, options={'maxiter':3000})

    # 准确率
    accuracy = 100.0*sum(predict(res2.x, XX) == y.ravel())/y.size

    # 对X,y的散列绘图
    plotData(data2, 'Microchip Test 1', 'Microchip Test 2', 'y = 1', 'y = 0', axes.flatten()[i])

    # 画出决策边界
    x1_min, x1_max = X[:,0].min(), X[:,0].max(),
    x2_min, x2_max = X[:,1].min(), X[:,1].max(),
    xx1, xx2 = np.meshgrid(np.linspace(x1_min, x1_max), np.linspace(x2_min, x2_max))
    h = sigmoid(poly.fit_transform(np.c_[xx1.ravel(), xx2.ravel()]).dot(res2.x))
    h = h.reshape(xx1.shape)
    axes.flatten()[i].contour(xx1, xx2, h, [0.5], linewidths=1, colors='g');
    axes.flatten()[i].set_title('Train accuracy {}% with Lambda = {}'.format(np.round(accuracy, decimals=2), C))