高敏感技能掩码:如何在 Agent 开放平台上保护隐私能力
导读:这篇讲 Agent 开放平台上高敏感技能的对话隐私掩码设计:论证了为什么不能只按技能标记判断(五类泄露场景会漏掉四类,名单内用户、记忆回显等都挡不住),并给出三份名单叠加(技能/知识库/用户)、逐轮判定、命中轮整轮占位符 + 后续轮「小纸条」值级打码 + 敏感词句级打码的三层机制。关键取舍是 fail-closed(宁可多掩不漏掩)、打码不可逆且无人可豁免、主管确认才生效,并演进到「命中轮永锁 + 延续 2 轮窗口」的按轮判定。适合做 Agent 平台安全、隐私保护或对话记录审计的工程师读。
分类:AI安全 | 标签:AI安全、高敏感、掩码、隐私保护
问题背景:为什么不能只按技能标记判断
Agent 开放平台允许第三方上架技能,其中一部分技能会处理高敏感数据——客户对话、工资明细、身份信息、收货地址等等。这些对话一旦在运营后台被随意查看,本身就是隐私泄露。
于是我们给敏感技能打上「高敏感」标记:被标记的技能,它产生的对话记录(用户问了什么、模型答了什么、调用了什么工具)在运营后台会整体变成占位符 [HIGH_SENSITIVE_REDACTED]——你能看到「这里有一段被保护的对话」,看不到内容。
但一个问题很快浮现:能不能只按技能标记判断? 也就是「每一轮去读记录,这一轮用的是被标记为高敏感的技能就掩码,没标记就不掩码」。
结论是:不够。一句话:技能标记只是多把锁中的一把,钥匙并不只挂在技能上——只按它判断,下面五类泄露会漏掉四类。
| 泄露的情形 | 这一轮的技能有标记吗 | 只按技能标记 | 现在的做法 |
|---|---|---|---|
| ① 用的就是被标记的技能 | 有 | 能挡住 | 整轮掩码 |
| ② 技能没标记,但引用了敏感资料 | 没有 | 会漏 | 整轮掩码 |
| ③ 技能没标记,但对话的人是名单内用户(如高管账号) | 没有 | 会漏 | 整轮掩码 |
| ④ 技能没标记,但后续轮又复现了前面出现过的具体数字/号码 | 没有 | 会漏 | 只打码那个值 |
| ⑤ 技能没标记,但后续轮被记忆把敏感事实带出来 | 没有 | 会漏 | 只打码那一句 |
三个例子说明为什么会漏:
- 例子一(名单内用户):一位名单内的高管用「订单查询」这个普通技能查自己的订单、收货地址、联系电话。技能从上线起就没被标过——按「没标记就不掩码」,整段对话就是明文。但对话主体是高管的个人信息,必须保护。这只能靠用户名单拦住,和技能标记无关。
- 例子二(复现旧敏感值):用户先在「工资查询」(已标记)里问出实发金额,接着换一个没被标记的技能说「帮我算一下昨天那笔实发到账的钱」。按「没标记就不掩码」,金额又漏一次。需要把前面那轮出现过的具体金额记下来,后续再出现就只打码这个数字。
- 例子三(记忆带出事实):模型把「工资条里部门字段异常」这类事实写进记忆,之后在「1+1 等于几」这种完全无关的问题里顺口带出来。这一轮技能没标记、也没逐字复现具体金额,常规规则管不着——里面可能一个号码都没有,只有「工资」这样的词。只能靠敏感词发现后打码那一句。
为什么这几种必须管?一句话:前面保护了、后面放掉,等于没保护。 例子二、三正是「第一轮涉密、后面几轮不涉密」的场景——后面几轮本来就不是高敏感技能,按「没标记就不掩码」,前面刚被保护过的金额、薪酬事实在紧接着的几轮里又完整露出去。
另外澄清一个容易误会的事实:高敏感标记本身不在观测平台(记录平台)里。 写记录的程序往观测平台写的是这一轮的身份信息——用了哪个技能、哪种子技能、谁发起的、引用了哪些资料;而「高敏感」标识存在平台自己的数据库里(技能表的一个字段,由主管确认后写入)。所以「去观测平台查有没有高敏感标记」落到实处是:「取出身份 → 到名单里比对」。「每轮判断」这个思路本身是对的,但判断的依据不能只有技能标记这一条。
掩码机制:四步生效流程
一个安全机制如果说不清「谁贴标签、标签存哪、怎么传到查询侧、运营实际看到什么、边界在哪」,就没法让别人信任它。我们的掩码机制分四步生效。
第一步:人工确认,模型只提建议
后台有两个动作,故意分开:
- 生成建议:让模型做一次预筛,给出「这个技能是否高敏感」的判断和理由。只写进建议字段,不生效。
- 确认或修改:由主管拍板,写进去才是生效值,同时记录标记原因。
为什么不让模型直接决定?标错一个正常技能,它所有对话都会变成占位符,直接影响运营排障;标漏一个敏感技能则是数据风险。让模型只提议、人来拍板,是这两种代价之间的折中。所以贴上标签不会立刻生效,必须由主管人工确认才算数;建议本身不生效。
第二步:名单下发与缓存(最多 60 秒延迟)
查询侧不直接读数据库,而是从平台的内部接口一次性取回三份名单,并缓存 60 秒。所以标记变更到实际生效,最长有 60 秒延迟——不是故障,验收时刚标完没生效,先等一分钟再判断。
「高敏感」不只针对技能,而是三份名单各自维护,命中任何一份就算高敏感:
| 名单 | 管什么 | 什么时候命中 |
|---|---|---|
| 高敏感技能 | 某个技能本身涉及敏感业务 | 这一轮用的技能在名单里 |
| 高敏感知识库 | 某份资料属于敏感资料 | 这一轮引用了名单里的资料 |
| 高敏感用户 | 某类人的对话需要保护 | 这一轮是名单里的人发起的 |
这点很重要:一个完全正常的技能,只要对话的人是名单里的用户、或者引用了名单里的知识库,同样会被掩码。
另外配一份兜底名单(通过配置注入):内部接口取不到时就用它,查询本身不会因此失败。两份名单是叠加关系——兜底名单还能临时补上接口里暂时没有的内容(比如紧急加一条保护)。
性能上不用担心两点:名单不是每轮去请求一次,而是每 60 秒批量拉一次缓存在内存里,逐轮判断只是内存里的比对;「读取记录」本身也不是额外开销——要显示内容就必须读记录,判断是顺手做的。
第三步:逐轮判定
判断的单位是一轮问答,不是整个会话。每一轮都会独立检查:用的技能在不在名单里、引用的资料在不在名单里、发起人在不在名单里——任意一个命中就算。
有一个容易踩的细节:当一条标记没写清到「子技能」这一层时,系统按技能本身精确匹配,而不是放宽到「整个应用」——否则同一应用下的其它正常技能会被连坐掩码。这个粒度问题在实现中修正过。另外,当某一轮的资料信息没取到、导致「是否命中高敏感资料」判断不出来时,系统保守地按高敏感处理——本来也没有内容可展示,代价只是这一轮标记显示为高敏感。
第四步:占位符替换,外壳保留
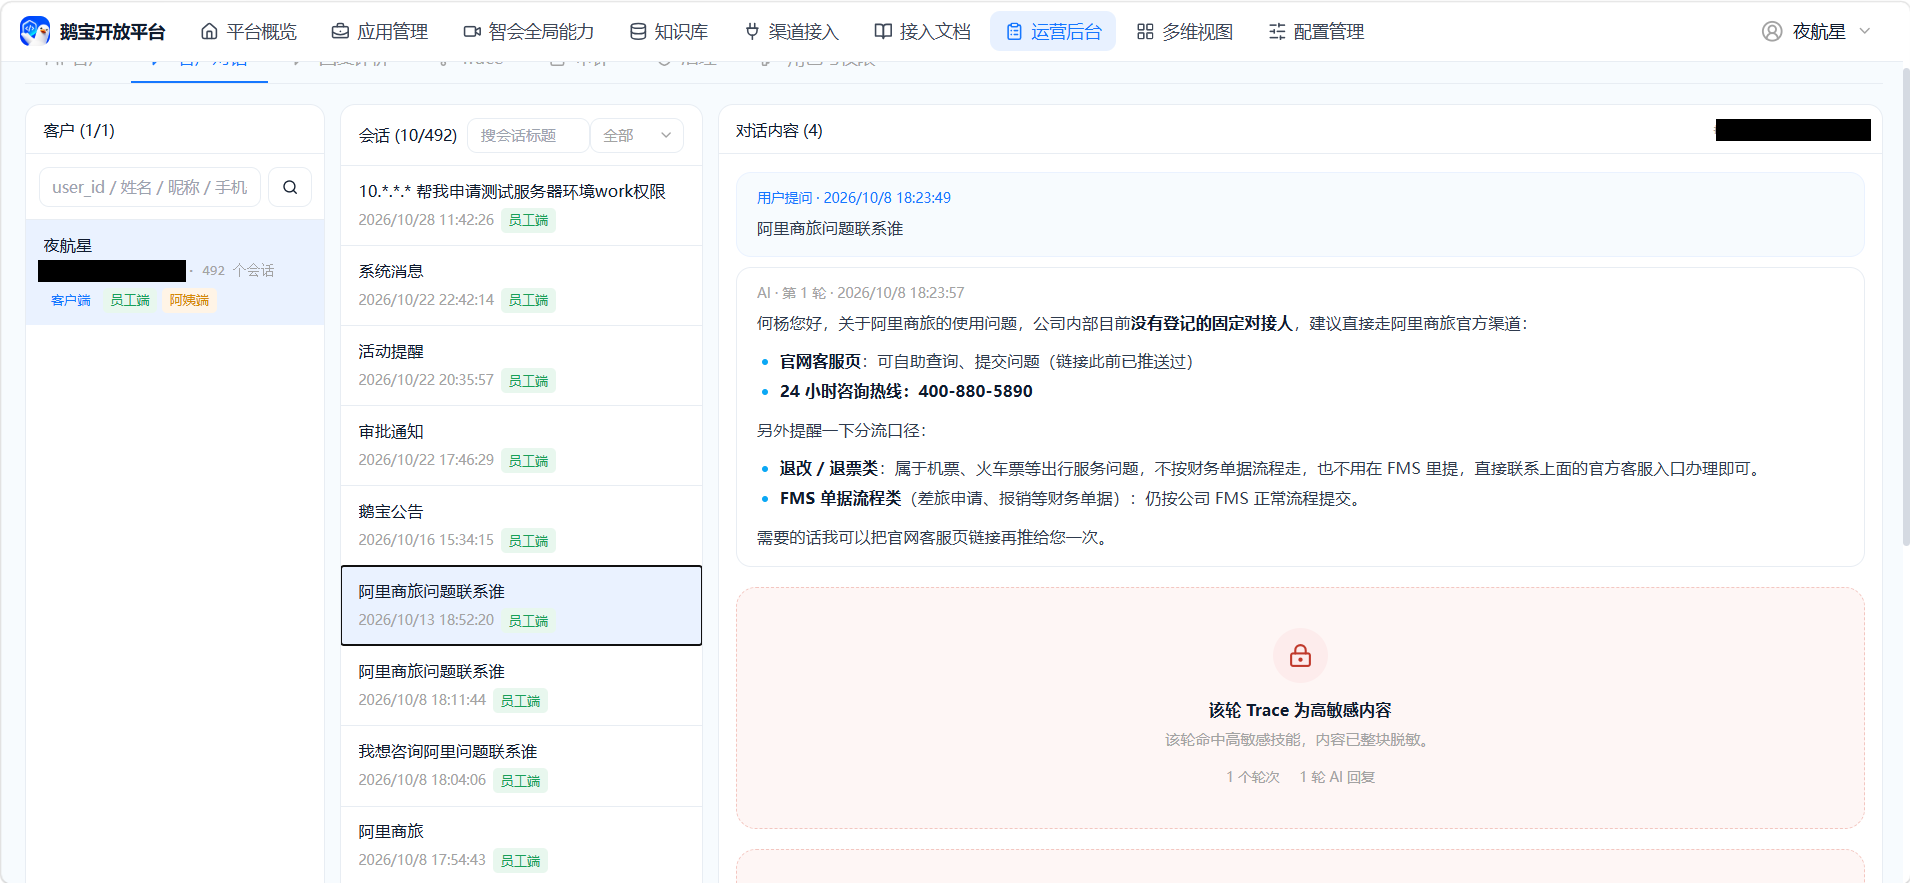
判定为高敏感后,同一结果在三个地方同步生效:列表页、详情页、会话视图。
生效方式:内容整体替换成占位符,而「外壳信息」按白名单保留——技能标识、子技能、技能版本、来源、发布者、环境、应用 ID。
所以运营看到的是:哪一次对话、哪个技能、哪个版本、什么环境、被保护了;看不到:用户问了什么、模型答了什么、工具的参数和返回。打码不可逆,后台没有任何入口能还原原文——设计上刻意不给任何人豁免,超管在页面上看到的同样是占位符。
打个比方:对话记录像监控录像。给某些录像贴上「涉密」标签后,画面整体打码;但「外壳信息」——哪个技能、什么版本、哪个环境、什么时候——仍然保留,因为排障要用。
三层精细处理:命中轮整轮掩码、小纸条值级打码、敏感词句级打码
如果「沾到一次敏感就把整段对话全部打码」,运营会失去大量正常上下文——用户查完工资接着问天气,天气那轮也跟着废掉。所以我们做三层处理,按每一轮的实际情况分别对待:
| 这一轮的情况 | 怎么判断 | 打码到什么程度 |
|---|---|---|
| ① 命中名单(技能 / 资料 / 用户) | 名单匹配 | 整轮变成占位符 |
| ② 不命中,但出现前面涉密轮里出现过的具体值 | 和小纸条比对 | 只打码那个值,其余正常看 |
| ③ 不命中,但话里带了敏感领域词 | 词表匹配 | 只打码那一句 |
第①层:涉密轮整轮打码,同时记一张「小纸条」
涉密轮做两件事:整轮内容变成占位符;同时从这一轮的原文里抽出出现过的敏感值,记成一张「小纸条」——比如手机号、身份证、银行卡、邮箱、工号,以及工资条上的金额数字。
小纸条有两个特点:只记值、不记原文;且只存在于这一次请求的内存里,不写数据库、不写日志、不进缓存。它的唯一用途是给后面几轮做比对。
第②层:后续轮正常展示,只对纸条上的值动手
后续轮次照常展示,但每一段文字都会拿小纸条比对一遍:出现了纸条上的值,就只把那个值打码,别的文字不动。所以「查完工资问天气」这轮不会被连累。
两个刻意的细节:
- 纸条只对「涉密轮之后」的轮次生效。因为敏感信息是那轮之后才进入上下文的;否则更早的普通轮里一个巧合的数字(比如订单号)会被误打码。
- 用户自己的提问也要过一遍纸条比对,但下面第③层的词表不适用于用户提问——口径是「提问可见,便于主管判断用户到底想干什么」。
第③层:敏感词(记忆回显)句级打码
先说实话:系统无法判断「模型是不是用了记忆」。记忆在模型那一侧,查询侧只看得到这一轮的输入和输出文字。所以这里的做法是事后从文字里找线索——文本里出现敏感领域词:工资、薪资、薪酬、实发、应发、五险一金、公积金、个税、工号、员工号、身份证、银行卡、护照号、驾照等等。
为什么要加这一层?它堵的是前两层都盖不住的泄露:模型把「工资条里部门字段异常」这类事实写进记忆,之后在完全无关的问题(「1+1 等于几」)的回答里又把它带出来。这种泄露两头都不占——没有命中高敏感技能(这一轮显示为正常),也没有逐字复现具体值(纸条比对盖不住),常规规则更管不着(里面可能一个号码都没有,只有「工资」这样的词)。
处理方式是按句子判断:一句话里只要出现敏感领域词,就只把那一句变成占位符。比如「北京明天晴 27 度。另外你上次问的工资条…」——只掩掉后半句,天气照常显示。
词表可以随业务扩充:通过配置追加(逗号或换行分隔),改完即生效,不用改代码、不用重启。这点很重要,因为这类判断本质上是「看到特征词就保守处理」的启发式:词表覆盖到的说法挡得住,换了同义说法、暗语就挡不住。所以我们一边留出加词的口子,一边在会话列表上给一个提示——「本会话含高敏感轮次,后续内容可能带出敏感信息」——把「后面可能还有残留」明确告诉使用者,而不是假装干净。
走一遍完整例子
- 用户问「我这个月工资多少」——命中高敏感技能 → 整轮变占位符;同时纸条记下这一轮出现的金额数字。
- 用户接着问「明天北京天气」——不命中 → 正常展示;只有回复里复现了纸条上的金额时,那处才被打码。
- 用户再问「1+1 等于几」——回复本身干净 → 正常展示。
- 但如果这条回复因为记忆顺口带出「另外你上次问的工资条部门字段有点异常」——纸条盖不住(措辞变了、值没复现)→ 领域词命中「工资」→ 只把这一句变占位符,同一条回复里其它内容照常显示。
边界与限制
- 生效有 60 秒延迟:名单缓存导致的,不是故障。
- 打码不可逆:这是目标而不是缺陷。需要看原文应走其它受控流程,不是在列表页面找还原入口。
- 没有管理员豁免:任何角色都看不到被打码的内容。
- 记忆回显靠特征词识别,属于启发式:换一种说法可能识别不到,所以词表需要随业务补充。
- 拿不准时宁可多掩:名单接口不可用时退回兜底名单(保证查询可用);判定所依赖的数据取不到时,按高敏感处理(宁可多掩,不漏掩)。
- 原文的可见范围极小:只在单次请求的内存里用于比对,不落库、不落日志、不进缓存。
- 标记可追溯:确认时会记录标记原因,便于事后复盘「为什么这个技能是敏感的」。
判定精确到轮:命中轮永锁 + 延续窗口
前面说的是「按轮判定」的总体框架。具体到运营「客户对话」的技能维度判定锚点,经历了两次演进:
- 会话级技能 key(最新一轮技能身份):最新一轮换成非敏感技能后,历史敏感轮会跟着解锁,存在敏感明文暴露窗口;
- 会话级技能全集锚点(曾用技能全集,只增不减):任一命中即整会话永锁,修复了「翻转解锁」,但长会话后续纯闲聊轮也一直被锁,运营无法看到非敏感轮次。
本次改造把技能维度判定精确到「轮」。一次会话内,每个用户提问及其后续 assistant / tool / error 消息构成一轮。每轮的锁定状态按以下规则计算:
- 命中轮:该轮助理消息的技能命中高敏感技能目录 → 该轮永久锁,明文永不恢复;
- 延续窗口:自最近一次命中轮起 2 轮内(含命中轮)仍锁,模拟「上下文还带着敏感 tag」;
- 窗口外:未再命中的新轮放开,正常显示明文;
- 再命中:该轮永久锁并重置窗口,之前已放开的轮不受影响。
简单示意:
轮次       是否命中敏感技能   最终锁定状态   说明
第 1 轮    否                放开           未命中、无延续
第 2 轮    是                永久锁         命中轮,明文永远掩码
第 3 轮    否                锁             延续窗口 1
第 4 轮    否                锁             延续窗口 2
第 5 轮    否                放开           窗口滑出,新轮正常显示
第 6 轮    是                永久锁         再次命中,重置窗口;第 5 轮保持放开
第 7 轮    否                锁             新的延续窗口
fail-closed 安全底线
命中轮的敏感状态与掩码一旦建立,不随窗口滑出解除——历史敏感轮明文在任何情况下不恢复。 判定所依赖的数据取不到时也一样按敏感处理(宁可多掩,不漏掩),保证技能维度不失效、不漏判。
降级回退链:增量数据逐步生效
| 数据条件 | 判定路径 | 效果 |
|---|---|---|
| 会话存在消息级技能数据 | 逐轮判定 | 命中轮永锁 + 延续窗口 + 窗口外放开 |
| 无消息级技能数据(老会话 / 列缺失) | 回退会话级技能全集判定;全集为空再回退单值 | 任一命中 → 整会话锁(fail-closed,技能维度不失效) |
| 用户维度命中高敏感名单 | 会话级强制锁(最高级) | 所有轮一律锁,不随窗口放开 |
| 知识库维度命中 | 会话级强制锁 | 所有轮一律锁(引用锚点无法定位轮次,保守整会话掩码) |
消息级可定位轮次,全集为老会话兜底,保证存储格式演化期不漏判;用户身份敏感与知识库引用敏感属会话级事实、无逐轮依据,保持最高优先级。前端已按逐轮结果渲染(敏感轮整块蒙版、普通轮正常渲染),后端逐轮输出后前端无需额外改动。
关键取舍:为什么命中轮永锁,而不是滑窗解锁
- 命中轮永久锁(采纳):历史敏感内容不允许解锁。被否方案是「窗口滑出后整段解锁」——但那样会重新引入敏感明文暴露窗口:最新一轮换成非敏感技能后,历史敏感轮跟着解锁,正是最初要修的问题。
- 窗口大小固定 2 轮:作为可配置常量,近似「上下文还带着敏感 tag」的短期延续;后续可接 agent 上下文截断信号做精确驱动。
- 明确非目标:不做内容级敏感识别(不读对话正文判断是否涉敏);不改变用户维度 / 知识库维度的整会话锁语义。
验收上,新增的逐轮用例覆盖了命中轮永锁、窗口内锁、窗口外放开、再命中重置窗口且已放开轮不被回锁、无消息级数据回退全集、用户维度整会话锁等场景,全部通过。
演进:窗口内技能识别——一次方案评审我们学到了什么
判定精确到轮之后,还有一个更底层的漏掩场景:只按「本轮激活的技能」判断,会漏「记忆里还摊着的技能」。
用大白话说:模型干活之前,会先去「翻技能说明书」。翻过之后,说明书的内容就留在它的上下文窗口里。接下来几轮,它不用再翻,直接照着记忆就能回答。过去的掩码判定只看「这一轮它翻了哪本说明书」——它一旦不翻了,系统就认为「这轮没碰到敏感技能」,把本该掩码的对话当成普通对话展示出来:
| 轮次 | 模型的动作 | 只按「本轮翻了哪本」判定的结果 |
|---|---|---|
| 第 N 轮 | 翻开《工资查询》说明书 | 识别为敏感(正确) |
| 第 N+1 轮 | 不翻,照着记忆回答工资明细 | 判为普通(漏掩) |
| 第 N+2 轮 | 不翻,继续照着记忆回答 | 判为普通(漏掩) |
| 说明书被挤出记忆后 | 已经不依赖它 | 判为普通(合理) |
问题成立,方案的真源判断——「桌上还摊着哪些书」比「这轮翻的是哪本书」更准——是对的;它正好补上「命中后第 3 轮起、被压缩之前」这一段,而这一段现在只能靠固定的 2 轮窗口去猜。
两套做法的对比
| 维度 | 现状(本轮激活技能) | 方案(窗口内技能) |
|---|---|---|
| 信息来源 | 「这一轮翻开了哪本说明书」(本轮激活的技能) | 「记忆里还摊着哪些说明书」(窗口内出现过、且还在上下文里的技能) |
| 判定位置 | 运营后台的会话数据库 | 调用链(Trace)元数据,与评估侧同源 |
| 掩码时效 | 命中这一轮永久锁 + 后面固定几轮(近似) | 只要还在记忆里就一直算敏感,直到内容被压缩挤出去 |
三条最关键的差别:
- 信息来源更准:从「这轮翻了哪本书」升级成「桌上还摊着哪些书」,补上了现有固定窗口靠猜的那一段。
- 判定位置换了地方会带来新问题:判在元数据上,就变成两套标准——同一个会话,在「客户对话」页和 Trace 页可能显示不同结论,运营同学会困惑。
- 掩码时效明显变长:压缩前可能有几十轮都标敏感,更安全,但「普通对话」的区分度会明显下降。方案否掉了「压缩后永久标」,但没有处理「压缩前长期标」这半个问题。
评审方法论:逐条对代码 + 线上数据核对
这份方案在落地前做了一次逐条评审,方法值得沉淀:
- 逐条对代码核对:方案里写明的类名、字段名、文件路径必须全局搜索验证是否真实存在——结果是方案里的好几个类名在代码库里完全不存在,真实实现在另外几个文件里,落实时要按真实实现改写。
- 没有的机制不能硬做:方案假设「说明书正文被直接注入对话」,实际上注入的只是「技能目录清单」(名字和路径),正文是模型自己翻进来的。如果按「清单」来判定,等于把整个应用挂载的所有技能都标成敏感——正是方案自己在「不做的事」里要避免的那种误标。
- 用线上数据说话:方案用的「上下文变量」发布机制在这个项目里已经被证明行不通——写入发生在子任务里,读出发生在主任务里,读不到。这不是推测,是刚踩过的坑:修复前,消息表里数万条消息的技能字段全是空的,根因就是这个;「完全同款」的知识库发布,线上数千个会话里数百个真用过知识库检索,其中只有个位数写上了字段(不足 1%)。照抄这套机制,新字段大概率恒为空,方案想达到的效果直接落空。
- 上下文变量跨任务失效是坑:委派出去的子任务有独立的执行上下文,在主任务里读不到子任务写入的属性——这类机制从设计上就要回避。
- 一轮内多次调用要取并集:一轮里模型可能被调用多次,只留最后一次会把先前窗口里的技能信息覆盖丢掉,应取并集。
- 扫描成本需要缓存:每轮扫全部历史消息里的工具调用、每条都要解析路径、还可能读一次磁盘文件,需要去重和记忆化,否则每轮都在重复做无用功。
- 压缩后回读历史会漏:路径识别只认应用技能目录和员工技能目录两种开头,历史记录文件的路径两者都不是——压缩之后确实会漏,「不存在实质漏洞」的论证不成立。
- 子任务覆盖盲区:子任务有自己的消息列表,如果不在同一个列表里,主会话就扫不到子任务翻过的说明书,需要明确算不算。
- 不做的事要守住:不扫工具返回值、不扫注入后的系统提示——扫描这两处会把无关内容当成技能,造成大面积误标。这个边界与现状一致,方向对。
顺带发现一个更紧急的问题:知识库维度的高敏感掩码很可能从上线起就没真正生效过——判定要读的字段跟技能字段是同一个失效原因(上面那组数据就是证据)。建议单独立项优先修复,优先级高于本方案。
推荐做法:以会话持久化为唯一标准
最终推荐的落地路径不是照搬方案,而是把「窗口内技能」落到会话数据库、作为唯一标准:
- 只有一个标准:运营「客户对话」页和 Trace 页共用一套判定,不会出现同一个会话两种结论。
- 可回溯:历史会话能查、能复盘,便于事后核对判定是否合理。
- 改动更小:不用新开一条元数据链路;现有「命中后固定几轮」的机制可以退化成兜底下限,甚至直接取消,改用更准的窗口信号。
如果坚持写进调用链元数据,需要五处修正:换掉发布机制(用跨任务注册表,别用子任务里写入的上下文变量)、一轮内累积而不是覆盖、设窗口上限(或与压缩边界取较小值)、把历史记录路径纳入识别(否则压缩后必然漏判)、明确子任务算不算在内。
评审还拍板了三个问题,都是产品口径问题:唯一标准放在哪边(会话数据库——两页一致、可回溯,还是调用链元数据?两边并存会长期给出两种结论);一次掩码管多久(固定几轮、上限 N 轮,还是「一直在记忆里就一直敏感」?这直接决定普通对话的区分度);压缩后的漏判是否接受(把历史记录路径纳入识别,或者直接用已上线的会话级锚点兜底锁兜住)。
小结:几条安全设计原则
读到这里,其实已经可以提炼出几条通用的安全设计原则:
- fail-closed(宁可多掩,不漏掩):判定所依赖的数据取不到时,按高敏感处理;名单接口不可用时退回兜底名单;打码不可逆是目标而不是缺陷。
- 逐轮判定,不连坐:只有命中轮被整轮掩码,后续普通轮正常展示;「沾到一次就整段掩码」会毁掉运营的排障上下文。
- 降级不放开:存储格式演化期,老会话从消息级回退到会话级全集、再回退到单值,方向永远是「更多掩码」而不是「更少掩码」;命中轮的明文在任何情况下不恢复。
- 名单 + 缓存的一致性:三份名单(技能 / 知识库 / 用户)各自维护、叠加生效;查询侧 60 秒缓存保证单接口批量拉取,兜底名单保证可用性;对「标签存哪、怎么传、多久生效」要能一句话说清。
- 人参与关键决策:模型只「提建议」,主管「确认」才算生效——标错的代价两头都不小,让人拍板是折中。
- 为演进保留余地:固定窗口只是近似,等「上下文是否还带敏感 tag」的显式信号就绪后可以精确驱动;词表可配置追加、窗口大小可配置化,都是同一个思路——机制先上线,参数后调优。
这套机制的核心不是一个玄妙的算法,而是一组朴素但严格的原则:判定精确到轮、任何情况下不还原明文、数据不足时向安全一侧倾斜。对于任何允许第三方能力接入、又必须保护用户隐私的平台,这组原则都值得复用。