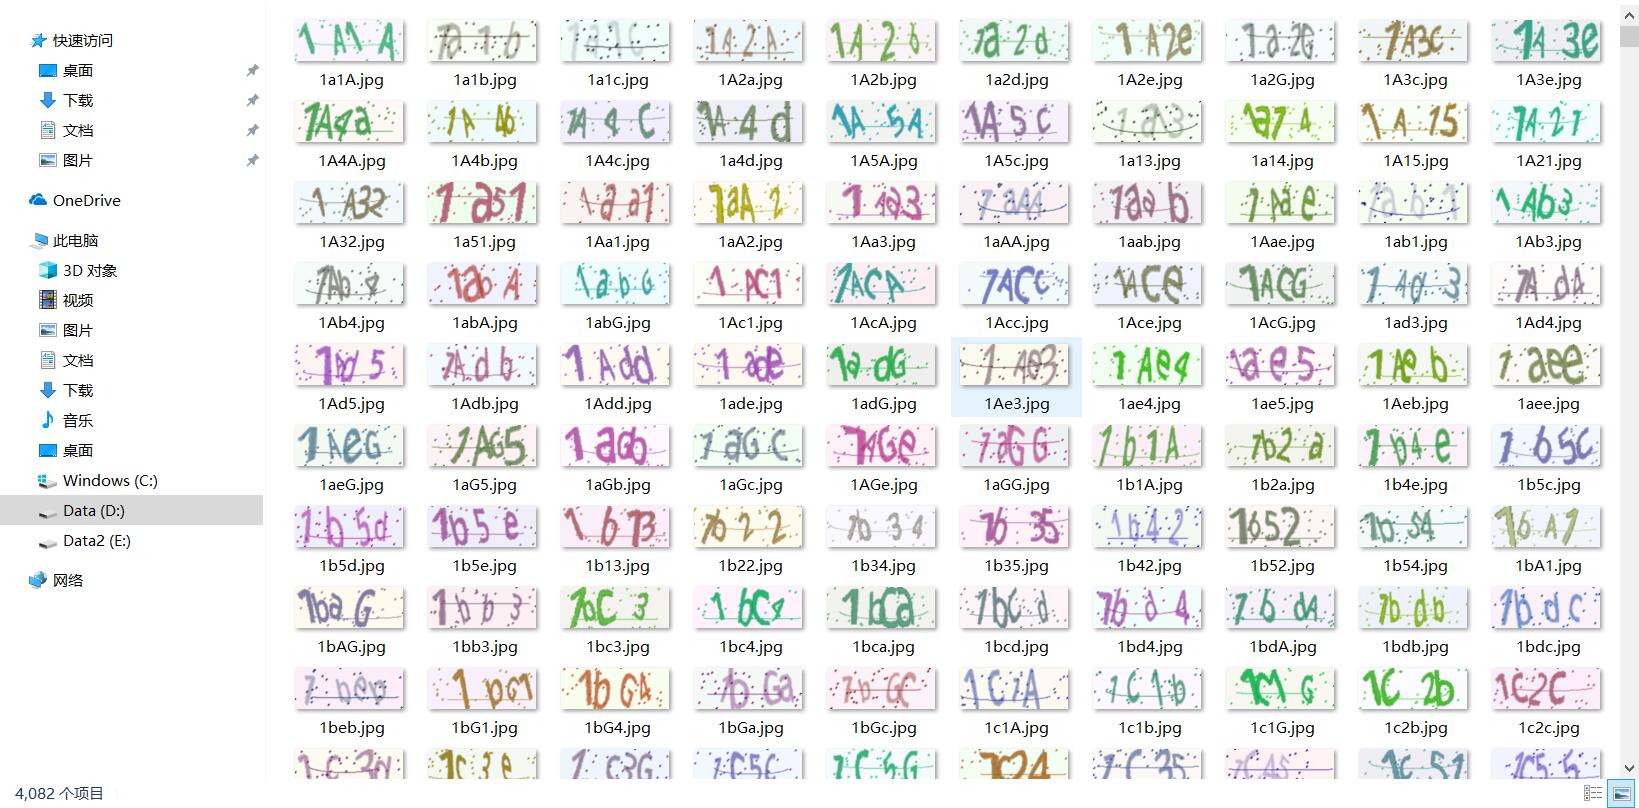
验证码生成
# 验证码生成库
# pip install captcha
from captcha.image import ImageCaptcha
import numpy as np
from PIL import Image
import random
import sys

number = ['1','2','3','4','5','a','b','c','d','e','A','G']

def random_captcha_text(char_set=number, captcha_size=4):
    # 验证码列表
    captcha_text = []
    for i in range(captcha_size):
        # 随机选择
        c = random.choice(char_set)
        # 加入验证码列表
        captcha_text.append(c)
    return captcha_text

# 生成字符对应的验证码
def gen_captcha_text_and_image():
    image = ImageCaptcha()
    # 获得随机生成的验证码
    captcha_text = random_captcha_text()
    # 把验证码列表转为字符串
    captcha_text = ''.join(captcha_text)
    # 生成验证码
    captcha = image.generate(captcha_text)
    image.write(captcha_text, 'captcha/images/' + captcha_text + '.jpg')  # 写到文件

# 数量少于6000,因为重名
num = 5000
if __name__ == '__main__':
    for i in range(num):
        gen_captcha_text_and_image()
        sys.stdout.write('\r>> Creating image %d/%d' % (i+1, num))
        sys.stdout.flush()
    sys.stdout.write('\n')
    sys.stdout.flush()

    print("生成完毕")
开始训练模型
import os
import tensorflow as tf
import numpy as np
import tensorflow.contrib.slim as slim
# 数据集路径
dataset_dir = "./captcha/images/"
# 测试集占比
num_test = 0.2
# 批次大小
batch_size = 32
# 周期大小
epochs = 100
# 分类数
num_classes = 12
# 学习率
lr = tf.Variable(0.001, dtype=tf.float32)
# 是否是训练状态
is_training = tf.placeholder(tf.bool)

# 用键值对保存分类值
number = ['1','2','3','4','5','a','b','c','d','e','A','G']
my_dict={}
for index,value in enumerate(number):
      my_dict[index]=value
# 获取所有验证码图片路径和标签
def get_filenames_and_classes(dataset_dir):
photo_filenames = []
labels = []
for filename in os.listdir(dataset_dir):
# 获取文件路径
path = os.path.join(dataset_dir, filename)
photo_filenames.append(path)
label = filename[0:4]
num_labels = []
for i in range(4):
num = my_dict[label[i]]
num_labels.append(num)
labels.append(num_labels)
return photo_filenames,labels
# 获取图片路径和标签
photo_filenames,labels = get_filenames_and_classes(dataset_dir)
photo_filenames = np.array(photo_filenames)  # 图片地址数组
labels = np.array(labels)  # 标签数组
# 打乱数据
np.random.seed(10)  # 随机数种子 每次生成的随机数相同
shuffle_indices = np.random.permutation(np.arange(len(photo_filenames)))  # 生成索引 然后打乱
photo_filenames_shuffled = photo_filenames[shuffle_indices]
labels_shuffled = labels[shuffle_indices]
# 切分训练集和测试集
test_sample_index = -1 * int(num_test * float(len(photo_filenames)))
x_train, x_test = photo_filenames_shuffled[:test_sample_index], photo_filenames_shuffled[test_sample_index:]
y_train, y_test = labels_shuffled[:test_sample_index], labels_shuffled[test_sample_index:]
# 图像处理函数
def parse_function(filenames, labels=None):
    image = tf.read_file(filenames)
    # 将图像解码
    image = tf.image.decode_jpeg(image, channels=3)
    # resize图片大小
    image = tf.image.resize_images(image, [224, 224])   # 原图160*60
    # 图片预处理 把数据变成-1到1之间的数值
    image = tf.cast(image, tf.float32) / 255.0  # 数据类型转换,比如读入的图片如果是int8类型的,一般在要在训练前把图像的数据格式转换为float32。
    image = tf.subtract(image, 0.5)  # 减法
    image = tf.multiply(image, 2.0)  # 乘法

    return image, labels
# 定义两个placeholder
features_placeholder = tf.placeholder(photo_filenames_shuffled.dtype, [None])  # 数据传入 1维
labels_placeholder = tf.placeholder(labels_shuffled.dtype, [None, 4])  # 标签传入 2维

# 创建dataset对象
dataset = tf.data.Dataset.from_tensor_slices((features_placeholder, labels_placeholder))  #from_tensor_slices,从张量的切片读取数据
# 处理图片
dataset = dataset.map(parse_function)
# 训练周期
dataset = dataset.repeat(1)
# 批次大小
dataset = dataset.batch(batch_size)

# 初始化迭代器
iterator = dataset.make_initializable_iterator()
# 获得一个批次数据和标签
data_batch, label_batch = iterator.get_next()
# alexnet网络需要224*224的图
def alexnet(inputs, is_training=True):
    #  slim 是tf的高级封装,可以方便的定义模型结构
    # slim.conv2d, slim.fully_connected对卷积和全连接做了统一的设置
    with slim.arg_scope([slim.conv2d, slim.fully_connected],
                         activation_fn=tf.nn.relu,
                         weights_initializer=tf.glorot_uniform_initializer(),
                         biases_initializer=tf.constant_initializer(0)):

        net = slim.conv2d(inputs, 64, [11, 11], 4)  # alexnet用的是96
        net = slim.max_pool2d(net, [3, 3])
        net = slim.conv2d(net, 192, [5, 5])  # alexnet用的是256
        net = slim.max_pool2d(net, [3, 3])
        net = slim.conv2d(net, 384, [3, 3])
        #net = slim.conv2d(net, 384, [3, 3])
        net = slim.conv2d(net, 256, [3, 3])
        net = slim.max_pool2d(net, [3, 3])

        # 数据扁平化
        net = slim.flatten(net)
        net = slim.fully_connected(net, 1024)  # alexnet有2次全连接层
        net = slim.dropout(net, is_training=is_training)  # 只有训练时dropout起作用

        # 4个输出代表4个任务
        net0 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)  # num_classes 12个分类
        net1 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)
        net2 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)
        net3 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)

    return net0,net1,net2,net3
with tf.Session() as sess:
    # 传入数据得到结果
    logits0,logits1,logits2,logits3 = alexnet(data_batch, is_training)
    # 定义loss
    # sparse_softmax_cross_entropy:标签为整数
    # softmax_cross_entropy:标签为one-hot独热编码

    loss0 = tf.losses.sparse_softmax_cross_entropy(label_batch[:,0], logits0)  # :表示批次  ,0 表示第0个任务
    loss1 = tf.losses.sparse_softmax_cross_entropy(label_batch[:,1], logits1)
    loss2 = tf.losses.sparse_softmax_cross_entropy(label_batch[:,2], logits2)
    loss3 = tf.losses.sparse_softmax_cross_entropy(label_batch[:,3], logits3)
    # 计算总的loss
    total_loss = (loss0+loss1+loss2+loss3)/4.0
    # 优化total_loss
    optimizer = tf.train.AdamOptimizer(learning_rate=lr).minimize(total_loss)

    # 计算准确率
    correct0 = tf.nn.in_top_k(logits0, label_batch[:,0], 1)
    accuracy0 = tf.reduce_mean(tf.cast(correct0, tf.float32))  #  tf.cast  数据格式转换为float32
    correct1 = tf.nn.in_top_k(logits1, label_batch[:,1], 1)
    accuracy1 = tf.reduce_mean(tf.cast(correct1, tf.float32))
    correct2 = tf.nn.in_top_k(logits2, label_batch[:,2], 1)
    accuracy2 = tf.reduce_mean(tf.cast(correct2, tf.float32))
    correct3 = tf.nn.in_top_k(logits3, label_batch[:,3], 1)
    accuracy3 = tf.reduce_mean(tf.cast(correct3, tf.float32))
    # 总的准确率
    total_correct = tf.cast(correct0, tf.float32)*tf.cast(correct1, tf.float32)*tf.cast(correct2, tf.float32)*tf.cast(correct3, tf.float32)
    total_accuracy = tf.reduce_mean(tf.cast(total_correct, tf.float32))

    # 所有变量初始化
    sess.run(tf.global_variables_initializer())
    # 定义saver保存模型
    saver = tf.train.Saver()

    # 训练epochs个周期
    for i in range(epochs):
        if i%30 == 0:
            sess.run(tf.assign(lr, lr/3))  # 刚开始训练的快一点 后面收敛慢一点
        # 训练集传入迭代器中
        sess.run(iterator.initializer, feed_dict={features_placeholder: x_train,
                                                  labels_placeholder: y_train})
        # 训练模型
        while True:
            try:
                sess.run(optimizer,feed_dict={is_training:True})
            except tf.errors.OutOfRangeError:
                # 所有数据训练完毕后跳出循环
                break

        # 测试集放入迭代器中
        sess.run(iterator.initializer, feed_dict={features_placeholder: x_test,
                                                  labels_placeholder: y_test})
        # 测试结果
        while True:
            try:
                # 获得准确率和loss值
                acc0,acc1,acc2,acc3,total_acc,l = \
                    sess.run([accuracy0,accuracy1,accuracy2,accuracy3,total_accuracy,total_loss],feed_dict={is_training:False})
                # loss值统计
                tf.add_to_collection('sum_losses', l)
                # 准确率统计
                tf.add_to_collection('accuracy0', acc0)
                tf.add_to_collection('accuracy1', acc1)
                tf.add_to_collection('accuracy2', acc2)
                tf.add_to_collection('accuracy3', acc3)
                tf.add_to_collection('total_acc', total_acc)
            except tf.errors.OutOfRangeError:
                # loss值求平均
                avg_loss = sess.run(tf.reduce_mean(tf.get_collection('sum_losses')))
                # 准确率求平均
                avg_acc0 = sess.run(tf.reduce_mean(tf.get_collection('accuracy0')))
                avg_acc1 = sess.run(tf.reduce_mean(tf.get_collection('accuracy1')))
                avg_acc2 = sess.run(tf.reduce_mean(tf.get_collection('accuracy2')))
                avg_acc3 = sess.run(tf.reduce_mean(tf.get_collection('accuracy3')))
                avg_total_acc = sess.run(tf.reduce_mean(tf.get_collection('total_acc')))
                print('%d:loss=%.3f acc0=%.3f acc1=%.3f acc2=%.3f acc3=%.3f total_acc=%.3f' %
                      (i,avg_loss,avg_acc0,avg_acc1,avg_acc2,avg_acc3,avg_total_acc))
                # 清空loss统计
                temp = tf.get_collection_ref('sum_losses')
                del temp[:]
                # 清空准确率统计
                temp = tf.get_collection_ref('accuracy0')
                del temp[:]
                # 清空准确率统计
                temp = tf.get_collection_ref('accuracy1')
                del temp[:]
                # 清空准确率统计
                temp = tf.get_collection_ref('accuracy2')
                del temp[:]
                # 清空准确率统计
                temp = tf.get_collection_ref('accuracy3')
                del temp[:]
                # 清空准确率统计
                temp = tf.get_collection_ref('total_acc')
                del temp[:]
                # 所有数据测试完毕后跳出循环
                break

    # 保存模型
    saver.save(sess, 'models/modelhy.ckpt', global_step = epochs)
模型测试
import os
import tensorflow as tf
import numpy as np
import tensorflow.contrib.slim as slim
import matplotlib.pyplot as plt
from random import choice
from PIL import Image
# 数据集路径
dataset_dir = "./captcha/images/"
# 数据输入
inputs = tf.placeholder(tf.float32,[1,224,224,3])
# 分类数
num_classes = 12
# 用键值对保存分类值
# 用键值对保存分类值
number = ['1','2','3','4','5','a','b','c','d','e','A','G']
my_dict={}
for index,value in enumerate(number):
      my_dict[value]=index
print(my_dict)
# 根据值取键
def get_key(dct, value):
    return list(filter(lambda k:dct[k] == value, dct))[0]
# 获取所有验证码图片路径
def get_filenames(dataset_dir):
    photo_filenames = []
    for filename in os.listdir(dataset_dir):
        # 获取文件路径
        path = os.path.join(dataset_dir, filename)
        photo_filenames.append(path)
    return photo_filenames
# 获取图片路径
photo_filenames = get_filenames(dataset_dir)
def alexnet(inputs, is_training=True):
    with slim.arg_scope([slim.conv2d, slim.fully_connected],
                         activation_fn=tf.nn.relu,
                         weights_initializer=tf.glorot_uniform_initializer(),
                         biases_initializer=tf.constant_initializer(0)):

        net = slim.conv2d(inputs, 64, [11, 11], 4)
        net = slim.max_pool2d(net, [3, 3])
        net = slim.conv2d(net, 192, [5, 5])
        net = slim.max_pool2d(net, [3, 3])
        net = slim.conv2d(net, 384, [3, 3])
        net = slim.conv2d(net, 384, [3, 3])
        net = slim.conv2d(net, 256, [3, 3])
        net = slim.max_pool2d(net, [3, 3])

        # 数据扁平化
        net = slim.flatten(net)
        net = slim.fully_connected(net, 1024)
        net = slim.dropout(net, is_training=is_training)

        net0 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)
        net1 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)
        net2 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)
        net3 = slim.fully_connected(net, num_classes, activation_fn=tf.nn.softmax)

    return net0,net1,net2,net3
with tf.Session() as sess:

    # 传入数据得到结果
    logits0,logits1,logits2,logits3 = alexnet(inputs, False)

    # 预测值
    predict0 = tf.argmax(logits0, 1)
    predict1 = tf.argmax(logits1, 1)
    predict2 = tf.argmax(logits2, 1)
    predict3 = tf.argmax(logits3, 1)

    # 所有变量初始化
    sess.run(tf.global_variables_initializer())
    # 定义saver载入模型
    saver = tf.train.Saver()
    saver.restore(sess,'models/modelhy.ckpt-100')

    for i in range(10):
        filename = choice(photo_filenames)
        # 读取图片
        image = Image.open(filename)
        # 根据模型的结构resize
        image = image.resize((224, 224))
        image = np.array(image)
        # 图片预处理
        image_data = image/255.0
        image_data = image_data-0.5
        image_data = image_data*2
        # 变成4维数据
        image_data = image_data.reshape((1,224,224,3))
        # 获得预测结果
        pre0,pre1,pre2,pre3 = sess.run([predict0,predict1,predict2,predict3], feed_dict={inputs:image_data})
        # 数据标签
        label = filename.split('/')[-1][0:4]
        plt.imshow(image)
        plt.axis('off')

        nums1 = get_key(my_dict, int(pre0[0]))
        nums2 = get_key(my_dict, int(pre1[0]))
        nums3 = get_key(my_dict, int(pre2[0]))
        nums4 = get_key(my_dict, int(pre3[0]))

        plt.title('predict:'+ nums1+nums2+nums2+nums3 + '\n' + 'label:' + label)
        plt.show()
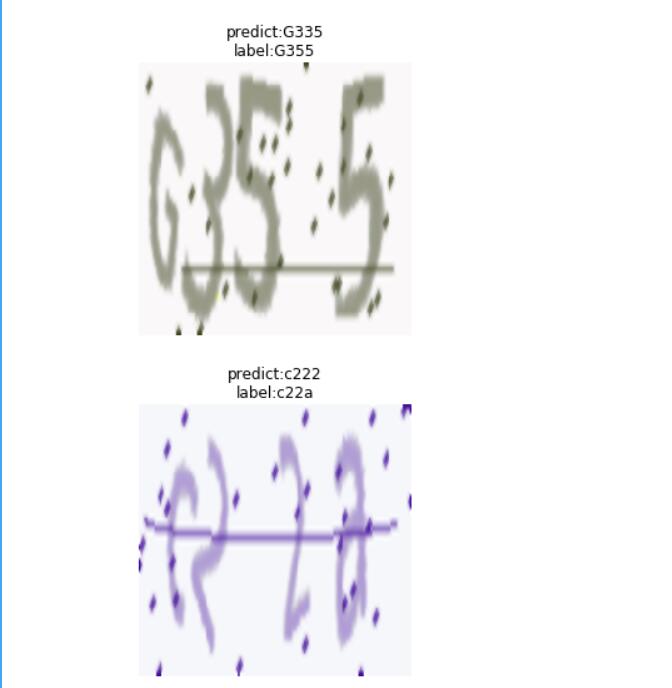
小结
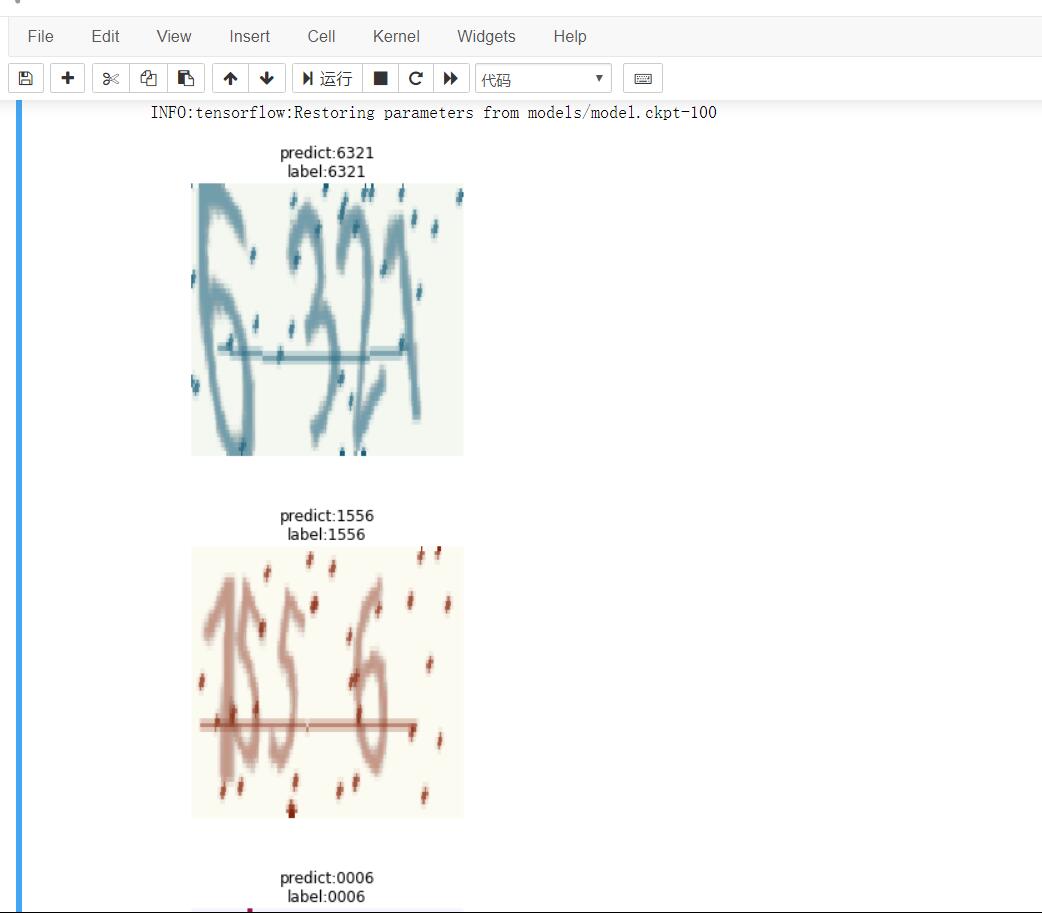
纯数字的验证码识别准确率较高。
稍微复杂点的验证码识别准确率较低,需要加大训练批次。